
遇见数据集

aaekay/pubmed-atlas

收藏
Hugging Face2026-05-16 更新2026-05-31 收录
官方服务:

资源简介:

PubMed Atlas是一个生物医学文献数据集,基于28,460,827篇PubMed摘要的嵌入(来自aaekay/pubmed-embeddings发布),使用三种编码器(NeuML/pubmedbert-base-embeddings、Qwen/Qwen3-Embedding-0.6B和BAAI/bge-m3)独立计算。数据集提供层次聚类结果、MeSH派生标签、Qwen3.5-27B生成的主题命名,以及基于图谱的研究空白排名。它包含聚类分配、集群统计信息和研究空白指标,旨在支持生物医学文本的特征提取、分类和发现任务。数据集不重新分发PubMed文本,仅包含派生数据。

PubMed Atlas is a biomedical literature dataset based on embeddings of all 28,460,827 PubMed abstracts from the aaekay/pubmed-embeddings release, computed independently for three encoders: NeuML/pubmedbert-base-embeddings, Qwen/Qwen3-Embedding-0.6B, and BAAI/bge-m3. It provides hierarchical clustering, MeSH-derived labels, Qwen3.5-27B-generated topic names, and atlas-driven research-void rankings. The dataset includes cluster assignments, cluster statistics, and research void metrics, designed to support feature extraction, classification, and discovery tasks in biomedical text analysis. No PubMed text is redistributed; only derived data is included.
提供机构:
aaekay
搜集汇总
数据集介绍
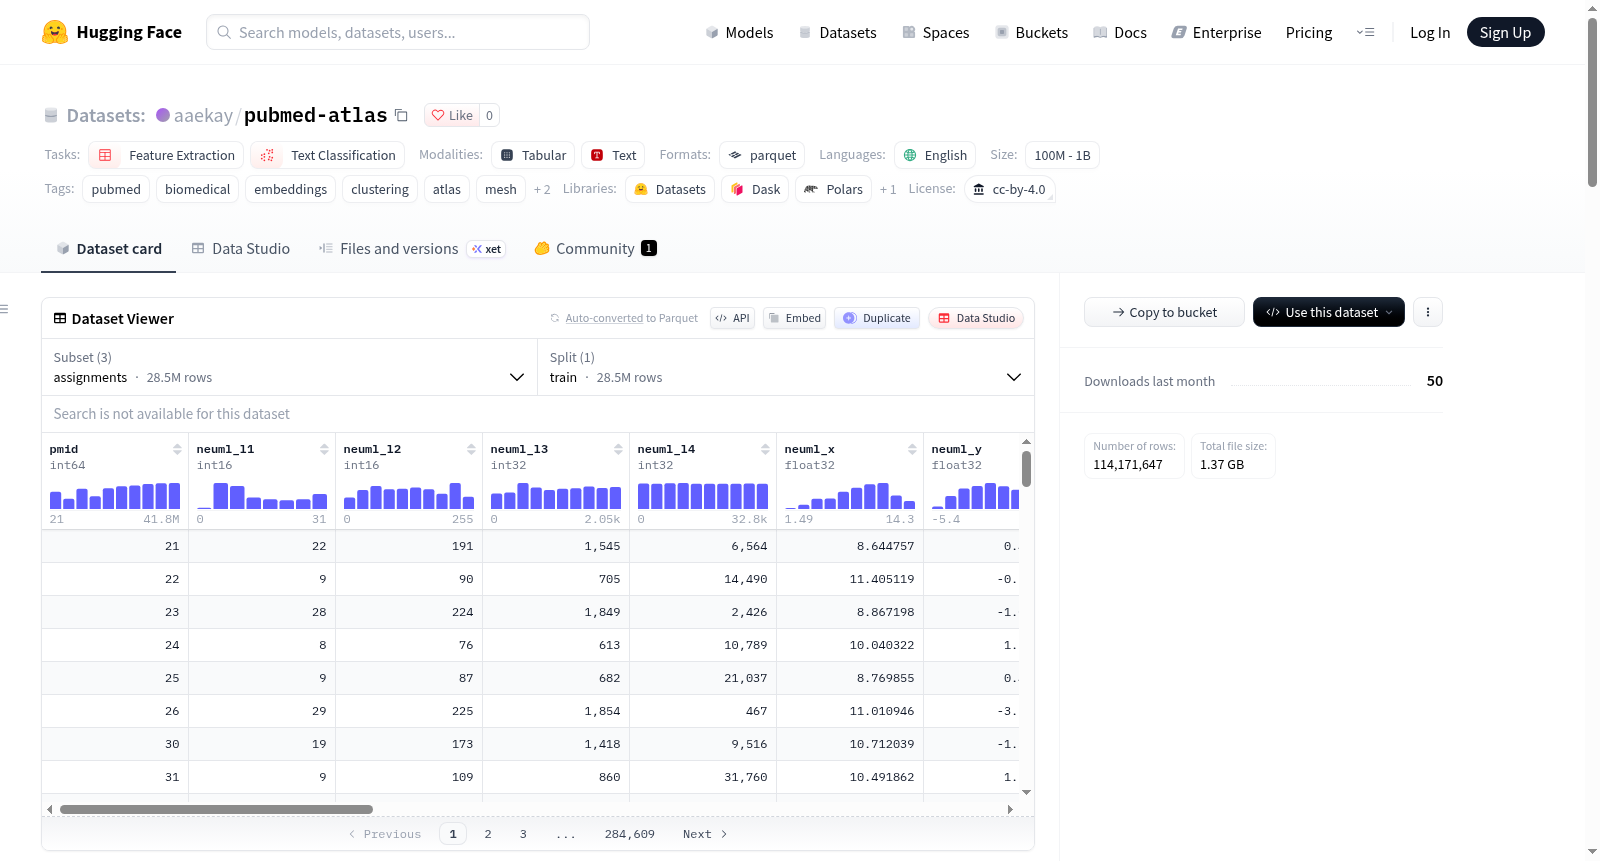
aaekay/pubmed-atlas 数据集图片
构建方式
面向大规模生物医学文献知识组织与语义发现的需求,PubMed Atlas 以 aaekay/pubmed-embeddings 发布的 28,460,827 条 PubMed 摘要嵌入为基座,对 NeuML/pubmedbert-base-embeddings、Qwen/Qwen3-Embedding-0.6B 与 BAAI/bge-m3 独立构建层次化图谱。其构建在 500 万条 MeSH 分层抽样的 PMID 上以 FAISS 球形 k 均值训练 32,768 个叶质心,经余弦 argmax 分配全量摘要;继而于叶质心上施行余弦平均连接凝聚层次聚类,切分为 L1=32、L2=256、L3=2,048、L4=32,768 四级。UMAP 坐标、MeSH 顶层字母与 TF-IDF 描述符,以及 Qwen3.5-27B 生成的主题名和描述共同形成标签。
特点
作为面向 PubMed 摘要嵌入的层次化聚类资源,PubMed Atlas 的特征体现为多编码器并行、跨模型共识与可解释标签的融合。其覆盖 28,460,827 条 PubMed 记录,三个编码器各含 32,768 个叶质心与四级层次,L3 跨模型一致性达 ARI 0.20–0.26、NMI 0.59–0.63;由 ≥10 成员三元组形成 24,044,298 条 PMID 的共识覆盖(84.5%),命名共识簇达 210,739 个。MeSH 纯度随层级由约 0.28–0.37 升至 0.49,并包含基于 RND 与 KL 的研究空白排序,最高分达 3.31。数据集仅分发派生聚类编号、统计量与主题标签,不重分发 PubMed 文本,许可为 CC-BY-4.0。
使用方法
在生物医学文本挖掘、科学计量与文献发现等场景中,PubMed Atlas 可通过 HuggingFace 的 parquet 配置文件便捷调用。使用者可加载 assignments 获取每个 PMID 在 NeuML、Qwen、BGE 三模型下的 L1–L4 簇编号、共识 L3 三元组及 UMAP 坐标,并以 pmid 为键与 aaekay/pubmed-embeddings 连接;clusters 提供簇规模、父节点、质心、MeSH 标签、Qwen3.5-27B 生成标签与描述及样例 PMID;rnd 文件给出逐 PMID 的 RND、L3 聚合 RND、KL 区分度与共识空白排名。该资源适用于特征提取、文本分类、聚类分析、主题发现与新颖性探测。使用须遵循 CC-BY-4.0,保留 PubMed ID 链接与署名,不得再分发原始标题或摘要文本。
背景与挑战
背景概述
在生物医学知识快速累积的背景下,PubMed摘要规模已逾两千八百万条,如何将高维语义嵌入转化为可导航、可解释且具跨模型稳健性的知识图谱,成为生物医学信息学的关键议题。aaekay于2026年发布PubMed Atlas,依托aaekay/pubmed-embeddings,对28,460,827条摘要分别以PubMedBERT、Qwen3-Embedding-0.6B与BGE-M3三种编码器构建四层层次聚类,融合MeSH元数据与Qwen3.5-27B主题命名,并导出跨模型共识簇及“研究空白”排序。该资源为文献计量、主题发现、检索增强与科学创新监测提供了大规模基础。
当前挑战
该数据集所回应的领域问题,在于海量生物医学文本中语义类别组织的可解释性、跨编码器表征的一致性与潜在研究空白的可计算识别。构建层面,千万级向量在三种异质嵌入空间中的球形k均值聚类、32,768叶节点层次聚合与UMAP降维伴随显著算力与存储负担;跨模型L3一致性ARI仅0.20–0.26,MeSH纯度由L1至L4约0.28–0.49,显示主题标签与语义结构存在歧义;研究空白虽由KL与RND联合排序,极端分数簇仍需外部验证;同时受许可限制,原始文本未再分发,限制端到端复现。
常用场景
经典使用场景
在生物医学文本挖掘与文献计量学的语境中,PubMed Atlas 的经典用途在于为海量摘要构建可复用的语义骨架。其覆盖 28,460,827 条 PubMed 摘要,并以 pmid 为纽带与 aaekay/pubmed-embeddings 对接,提供三种编码器下的层次聚类、MeSH 标签、LLM 生成主题名及 UMAP 坐标。研究者可沿 L1 至 L4 层级,从 32 个宏观域细化到 32,768 个叶簇,开展跨编码器语义检索、主题分类、聚类归属和文献地图可视化;consensus_l3 与 210,739 个命名共识簇则支撑跨模型一致的文献结构洞察。
解决学术问题
针对生物医学知识发现中长期存在的主题碎片化、标签异质性与跨模型结果不可比等难题,PubMed Atlas 提供了系统化观测框架。它通过 pmid 层面的多模型层次分配、MeSH 纯度与 TF-IDF 描述符、Qwen3.5-27B 主题命名,以及 L3 层跨模型 ARI 0.20–0.26、NMI 0.59–0.63 的一致性度量,缓解聚类对齐困难、主题解释薄弱和研究空白难以量化的问题。其 research voids 以高 KL 低 RND 象限识别异常主题组合,为科学计量、生物医学信息学和假设生成提供可检验的语义线索。
衍生相关工作
围绕 PubMed Atlas 形成的衍生工作,集中体现于伴随论文、aaekay/pubmed-embeddings 嵌入发布以及多编码器共识聚类框架。相关研究将 FAISS 球形 k 均值、scipy 凝聚层次聚类、UMAP 降维、MeSH 派生标签与 LLM 主题命名整合为可扩展流程,并推动 atlas-driven research-void ranking 成为文献发现的新范式。跨模型一致性分析、生物医学主题体系评估、研究空白探测、LLM 辅助科学计量和知识图谱构建等下游任务,均可能以该资源为基准。其意义在于把静态主题模型推进为多模型共识、可解释且可追溯的 PubMed 规模知识图谱。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

