
遇见数据集

disi-unibo-nlp/feast-foodex2-terms

收藏
Hugging Face2026-06-03 更新2026-06-14 收录
官方服务:

资源简介:

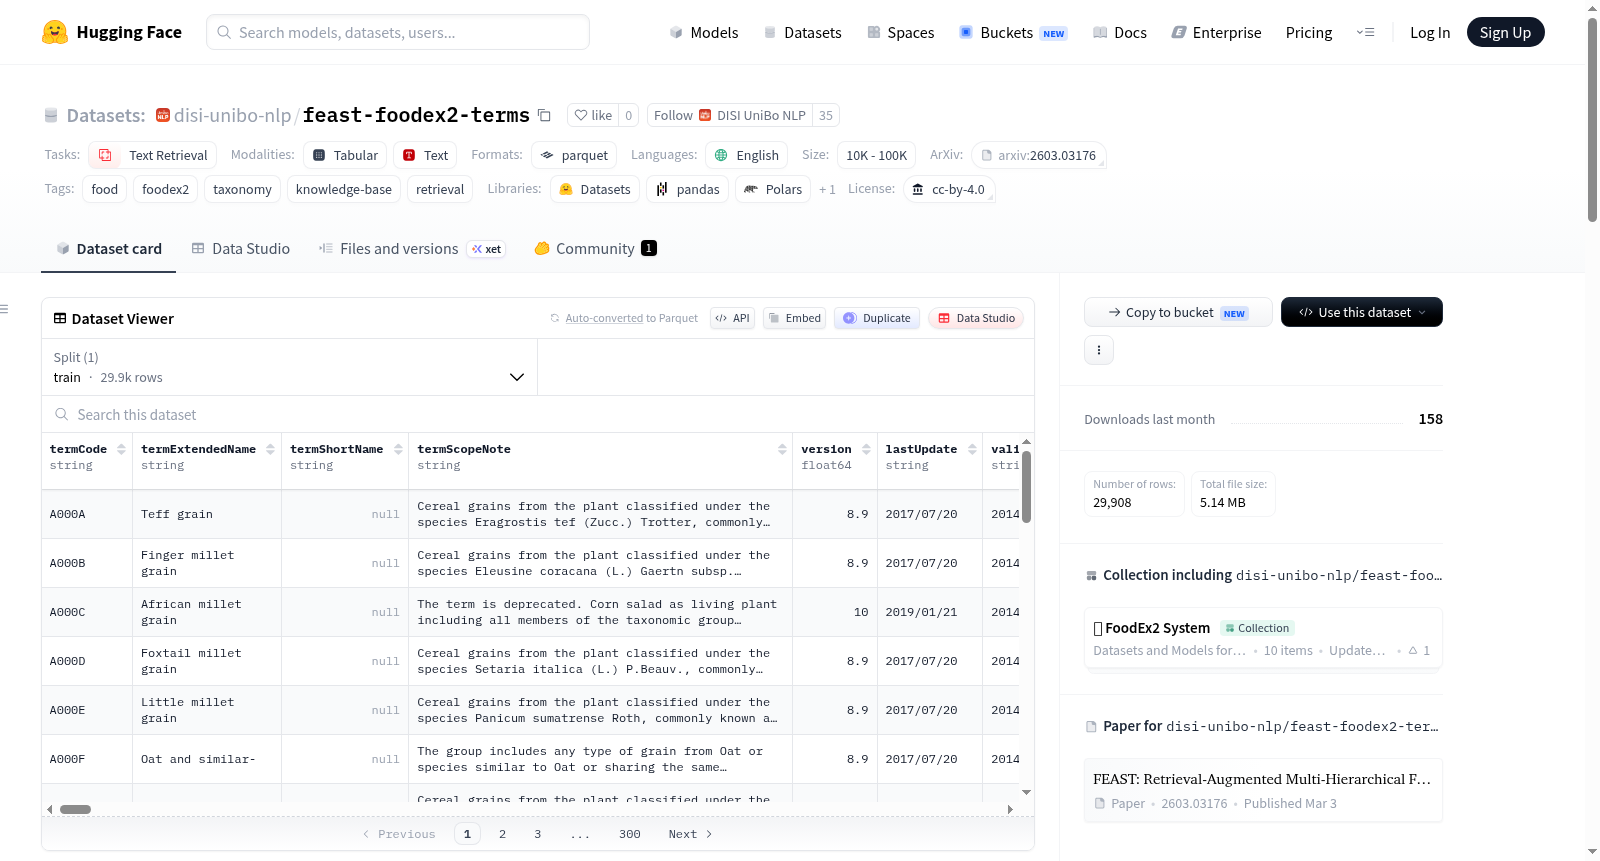
该数据集包含欧洲食品安全局(EFSA)开发的完整FoodEx2分类法——一个用于描述和编码欧洲消费食品的分层分类系统。数据集结构为单一的train分割,每行对应一个FoodEx2术语(约29,900行),列包括术语代码、术语扩展名称、术语范围说明、主父代码和隐式面描述符。分类法以树状层次结构组织食品术语,每个术语有一个父术语,涵盖从广泛食品组到特定食品项目的多个级别。此外,还包括面描述符,用于注释食品的物理状态、脂肪含量或生产方法等属性。数据集用于支持食品分类和检索研究,特别是与FEAST实验相关的可重复性工作。

This dataset contains the complete FoodEx2 taxonomy developed by the European Food Safety Authority (EFSA) — a hierarchical classification system for describing and coding food items consumed in Europe. The dataset structure includes a single train split with approximately 29,900 rows, each representing a FoodEx2 term, with columns such as termCode, termExtendedName, termScopeNote, masterParentCode, and implicitFacets. The taxonomy organizes food terms in a tree hierarchy where each term has one parent, spanning multiple levels from broad food groups to specific food items. It also includes facet descriptors that annotate properties of food like physical state, fat content, or production method. The dataset is intended for research in food classification and retrieval, particularly for reproducibility in FEAST experiments.
提供机构:
disi-unibo-nlp
搜集汇总
数据集介绍
disi-unibo-nlp/feast-foodex2-terms 数据集图片
构建方式
Feast-foodex2-terms数据集收录了由欧洲食品安全局(EFSA)开发的完整FoodEx2分类体系,该体系是一个用于描述和编码欧洲消费食品项目的层次化分类系统。数据集以单训练集(train split)形式组织,包含约29,900条记录,每行对应一个唯一的FoodEx2术语条目。每条记录通过'termCode'(唯一标识符)、'termExtendedName'(可读术语名称)、'termScopeNote'(可选描述或定义)、'masterParentCode'(直接父级术语代码)以及'implicitFacets'(隐式关联的面部描述符)等字段进行结构化定义。数据构建严格遵循EFSA官方发布的分类规则,确保术语在树形层次结构中具有明确的父子关系,并纳入诸如物理状态、脂肪含量等属性标记的面部描述符。
特点
该数据集最显著的特征在于其层级分明的树状结构,从广泛的食品类别逐步细化至具体食品项,为多层次食品检索与分类提供了坚实基础。数据集不仅包含基本术语,还整合了面部描述符,这些描述符以簇(如F03表示物理状态、F10表示脂肪含量)的形式组织,可对食品的多种属性进行精细化注释。此外,数据集规模适中(约29,900个术语),覆盖了欧洲饮食中常见的各类食品,并附带了官方生成的元数据(如范围注释),便于用户理解每个术语的语义边界。这种结构化的知识库特别适用于文本检索、知识图谱构建及跨语言食品分类任务。
使用方法
用户可借助Hugging Face Datasets库直接加载该数据集,将其应用于文本检索、分类模型微调或层级化食品编码系统的研究。典型的使用场景包括:利用'termExtendedName'和'termScopeNote'字段构建基于语义的食品检索系统;通过'masterParentCode'字段重建分类树并进行路径分析;结合'implicitFacets'字段探索食品多属性关联。数据集需与配套的注释数据集(disi-unibo-nlp/feast-foodex2)协同使用,后者提供了基于此分类法的真实食品描述文本。研究人员应引用论文《FEAST: Retrieval-Augmented Multi-Hierarchical Food Classification for the FoodEx2 System》以规范使用,并始终参考EFSA官方文档获取最权威的分类信息。
背景与挑战
背景概述
在食品安全与营养监测领域,精确的食物分类体系是数据标准化与跨国比较的基石。欧洲食品安全局(EFSA)开发的FoodEx2层级分类系统,旨在系统性地描述欧盟区域内的食品消费数据,其术语库覆盖从宏观食品类别到微观食品属性的详尽层次。该数据集由博洛尼亚大学的研究团队于2025年整理并发布,作为FEAST研究计划的一部分,以支持基于检索增强的多层级食品分类任务。通过公开近三万条FoodEx2术语及其层级关系、隐式属性描述,该数据集为自然语言处理与食品信息学的交叉研究提供了标准化基准,显著推动了食品安全风险评估中结构化知识的获取与复用。
当前挑战
该数据集面临的核心挑战包括领域问题与构建过程中的双重难点。在领域层面,FoodEx2词汇的层级复杂性导致传统文本检索方法难以分辨语义相近的术语(如不同加工状态的同类食材),且隐式属性(如脂肪含量、物理状态)的稀疏标注使得跨层级语义对齐尤为困难。在构建过程中,原始EFSA术语文档的非结构化格式以及多语言异源数据(如欧盟项目手册与散在的Excel文件)的整合,迫使研究团队需设计精细的清洗与映射管线,以消除歧义并保持层级一致。此外,术语的权威性依赖官方更新,而研究团队的再分发版本需严格验证与源数据的同步性,避免引入概念偏移或父子关系断裂的风险。
常用场景
经典使用场景
该数据集作为欧洲食品安全局(EFSA)构建的FoodEx2分类体系的核心组成部分,为食品描述与编码提供了标准化的层级参考。其经典应用场景在于支撑细粒度的食品检索任务,尤其是在多层级树状结构中精准定位特定食品类别。研究者和工程师借助该数据集,可将自然语言描述的食品文本映射到FoodEx2术语,实现从“茶类饮料”到“花草及非茶类泡饮”等概念间的语义匹配与层次化检索,为食品安全监测和营养评估提供可靠的语义锚点。
衍生相关工作
基于该数据集,衍生出了多项具有影响力的研究工作。其中,FEAST模型首次将检索增强生成(RAG)与多层级食品分类相结合,在ECAI 2025会议上展示了如何利用该数据集提升稀疏标注场景下的分类鲁棒性。此外,配套发布的feast-foodex2注释语料库进一步丰富了训练资源,驱动了层次化自适应学习、对比预训练以及刻面感知的食品表示学习等方向的发展。这些工作共同推动了食品计算领域的跨学科融合,成为食品AI基准评估的重要基石。
数据集最近研究
最新研究方向
当前,feast-foodex2-terms数据集在食品安全与营养监测领域的前沿研究中扮演着关键角色。随着欧洲食品安全局(EFSA)对食品分类系统精细化管理需求的日益增长,基于该数据集的检索增强生成(RAG)技术正成为热点。ECAI 2025会议上提出的FEAST框架便是这一方向的典范,它利用多层级层次化分类方法,结合知识库中的术语树结构与隐式方面描述符,显著提升了食品项的自动标注与检索精度。这一研究不仅优化了食品消费数据的标准化处理流程,更推动了欧盟范围内食品风险暴露评估与膳食调查的智能化进程,为全球食品安全治理提供了可扩展的技术范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

