advanced-soundscapes-stage-1
收藏资源简介:
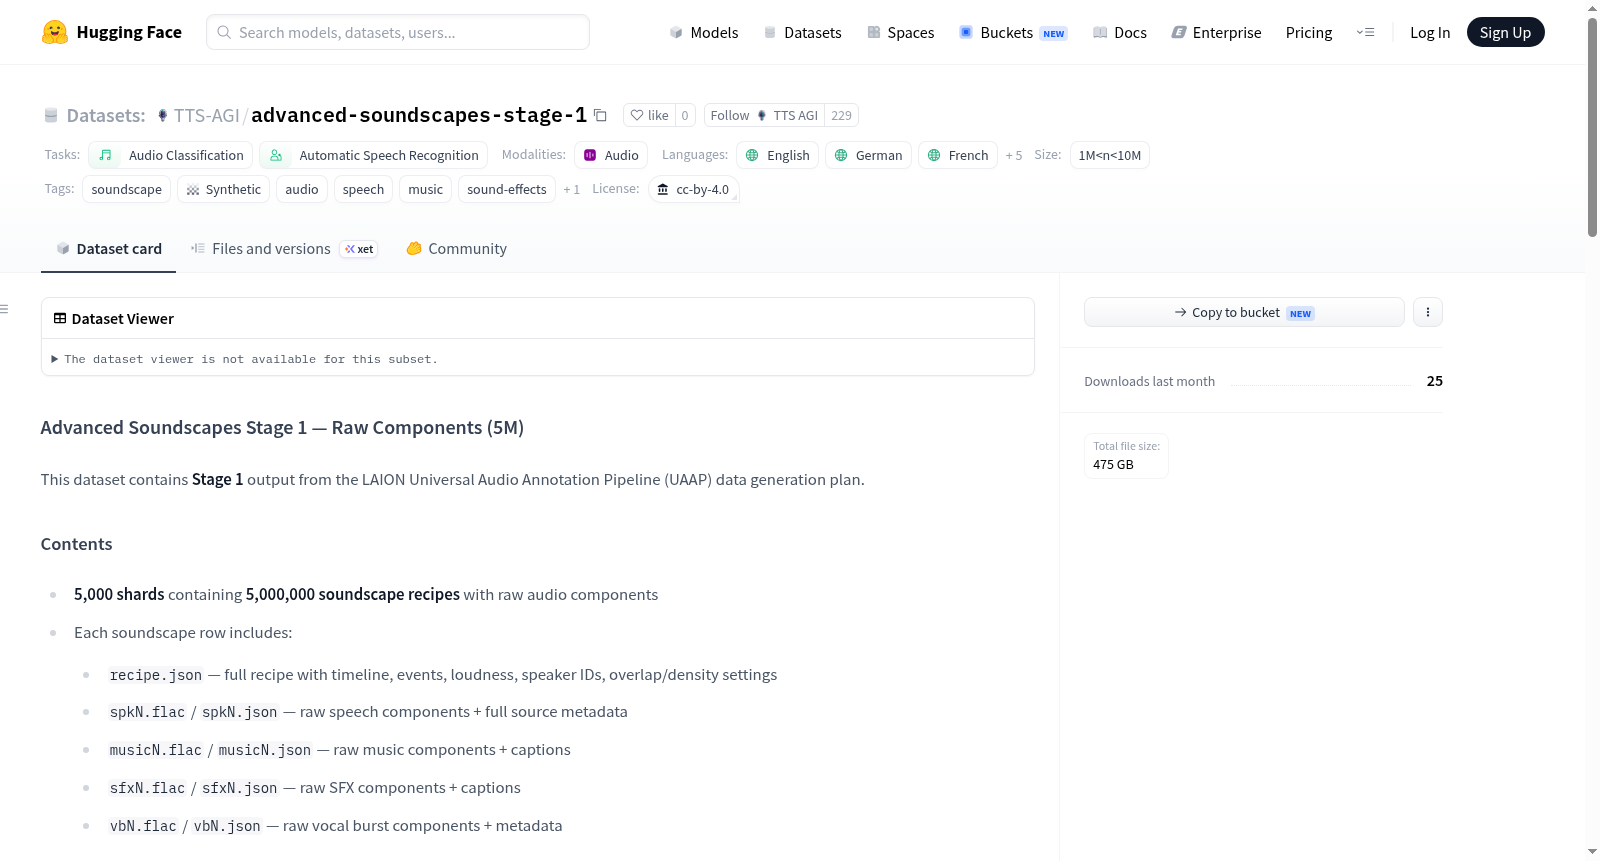
Advanced Soundscapes Stage 1 — Raw Components (5M) 数据集是LAION通用音频标注流水线(UAAP)数据生成计划的第一阶段产出。该数据集旨在为合成复杂声景提供结构化的原始音频组件,适用于音频分类和自动语音识别等任务。数据集包含5,000个分片,总计5,000,000个声景配方,规模在100万到1000万之间。数据内容涵盖多语言语音、音乐、音效和人声爆发等多种音频类型。每个数据行(对应一个声景配方)包含一个完整的配方文件(recipe.json),其中详细记录了时间线、事件、响度、说话人ID、重叠/密度等设置;以及对应的原始音频组件文件:语音组件(.flac音频及.json元数据)、音乐组件(.flac音频及字幕)、音效组件(.flac音频及字幕)和人声爆发组件(.flac音频及元数据)。数据以WebDataset .tar分片格式组织,每个分片包含1000个片段。数据来源于多个公开数据集,包括多语言语音、带字幕的AI音乐片段、合成的音效事件以及合成的人声爆发。数据生成的第一阶段(CPU处理)包括配方采样、从源数据集中抽取原始音频片段、解码并重采样至16 kHz单声道FLAC、计算精确的混音计划(包含真实时间、响度、说话人ID)以及收集完整的源元数据。配方设计采用了10种不同的原型(如平衡三重奏、语音主导、音乐主导等),并设定了响度梯度(从“非常安静”到“非常响亮”)和时长波段(从5-10秒的“微短”到40-60秒的“长”),以覆盖多样化的声景场景。
Advanced Soundscapes Stage 1 — Raw Components (5M) dataset is the first-stage output of the LAION Universal Audio Annotation Pipeline (UAAP) data generation plan. This dataset aims to provide structured raw audio components for synthesizing complex soundscapes, suitable for tasks such as audio classification and automatic speech recognition. The dataset contains 5,000 shards, totaling 5,000,000 soundscape recipes, with a scale between 1 million and 10 million. The data content covers various audio types including multilingual speech, music, sound effects, and vocal bursts. Each data row (corresponding to a soundscape recipe) includes a complete recipe file (recipe.json), which details settings such as timeline, events, loudness, speaker ID, overlap/density, etc.; and corresponding raw audio component files: speech components (.flac audio and .json metadata), music components (.flac audio and captions), sound effect components (.flac audio and captions), and vocal burst components (.flac audio and metadata). The data is organized in WebDataset .tar shard format, with each shard containing 1,000 segments. The data is sourced from multiple public datasets, including multilingual speech, AI-generated music clips with captions, synthetic sound effect events, and synthetic vocal bursts. The first stage of data generation (CPU processing) involves recipe sampling, extracting raw audio segments from source datasets, decoding and resampling to 16 kHz mono FLAC, computing precise mixing plans (including real-time, loudness, speaker ID), and collecting complete source metadata. The recipe design employs 10 different prototypes (such as balanced trio, speech-dominant, music-dominant, etc.), and sets loudness gradients (from very quiet to very loud) and duration bands (from micro-short at 5-10 seconds to long at 40-60 seconds) to cover diverse soundscape scenarios.
数据集概述:Advanced Soundscapes Stage 1 — Raw Components (5M)
- 许可证:CC-BY-4.0
- 任务类别:音频分类、自动语音识别
- 语言:多语言(英语、德语、法语、西班牙语、中文、日语、韩语等)
- 标签:声景、合成音频、语音、音乐、音效、UAAP
- 规模:1M < 样本数 < 10M
该数据集是 LAION 通用音频注释管道(UAAP)数据生成计划的阶段 1 输出。
内容
- 包含 5,000 个分片,总计 5,000,000 条声景配方,每条配方包含原始音频组件。
- 每条声景行包含:
recipe.json:完整配方,含时间线、事件、响度、说话人 ID、重叠/密度设置。spkN.flac/spkN.json:原始语音组件及完整源元数据。musicN.flac/musicN.json:原始音乐组件及标题。sfxN.flac/sfxN.json:原始音效组件及标题。vbN.flac/vbN.json:原始人声爆发组件及元数据。
格式
- 格式:WebDataset
.tar分片,每个分片含 1000 个片段。每条记录为以片段 ID 为键的 tar 内目录。
源数据集
| 源 | 类型 | 许可证 |
|---|---|---|
| laion/majestrino-data | 语音(约 50 种语言) | CC0 |
| laion/captioned-ai-music-snippets | 音乐(3–30 秒) | Apache-2.0 |
| laion/generated-sound-events | 音效(合成,1190 类) | NC-verify |
| laion/synthetic_vocal_bursts | 人声爆发 | 许可宽松 |
阶段 1 流程
阶段 1 仅为 CPU 处理,步骤包括:
- 采样配方(原型、时长、密度、重叠、说话人配置)。
- 从源数据集中提取原始音频片段(语言平衡、去重)。
- 解码并重采样为 16 kHz 单声道 FLAC。
- 计算精确混合计划(真实时间、响度、说话人 ID)。
- 收集完整源元数据。
- 写入 WebDataset 行。
阶段 2(GPU)将:为缺失字段生成标题,通过 Gemma-4-12B 融合,渲染最终混合 MP3。
配方原型
| 原型 | 权重 | 语音% | 音乐% | 音效% |
|---|---|---|---|---|
| 平衡三重唱 | 14% | 34% | 33% | 33% |
| 语音主导 | 16% | 70% | 15% | 15% |
| 音乐主导 | 11% | 12% | 76% | 12% |
| 音效主导 | 11% | 12% | 12% | 76% |
| 仅语音 | 13% | 100% | 0% | 0% |
| 仅音乐 | 6% | 0% | 100% | 0% |
| 仅音效 | 8% | 0% | 0% | 100% |
| 语音+音乐 | 8% | 55% | 45% | 0% |
| 语音+音效 | 9% | 55% | 0% | 45% |
| 音乐+音效 | 4% | 0% | 50% | 50% |
响度等级
| 标签 | RMS 增益 |
|---|---|
| very_quiet | 0.020 |
| quiet | 0.040 |
| moderate | 0.075 |
| loud | 0.120 |
| very_loud | 0.180 |
时长区间
| 区间 | 范围 | 权重 |
|---|---|---|
| 微 | 5–10 秒 | 18% |
| 短 | 10–20 秒 | 32% |
| 中 | 20–40 秒 | 32% |
| 长 | 40–60 秒 | 18% |