Qwen-Image-Bench
收藏资源简介:
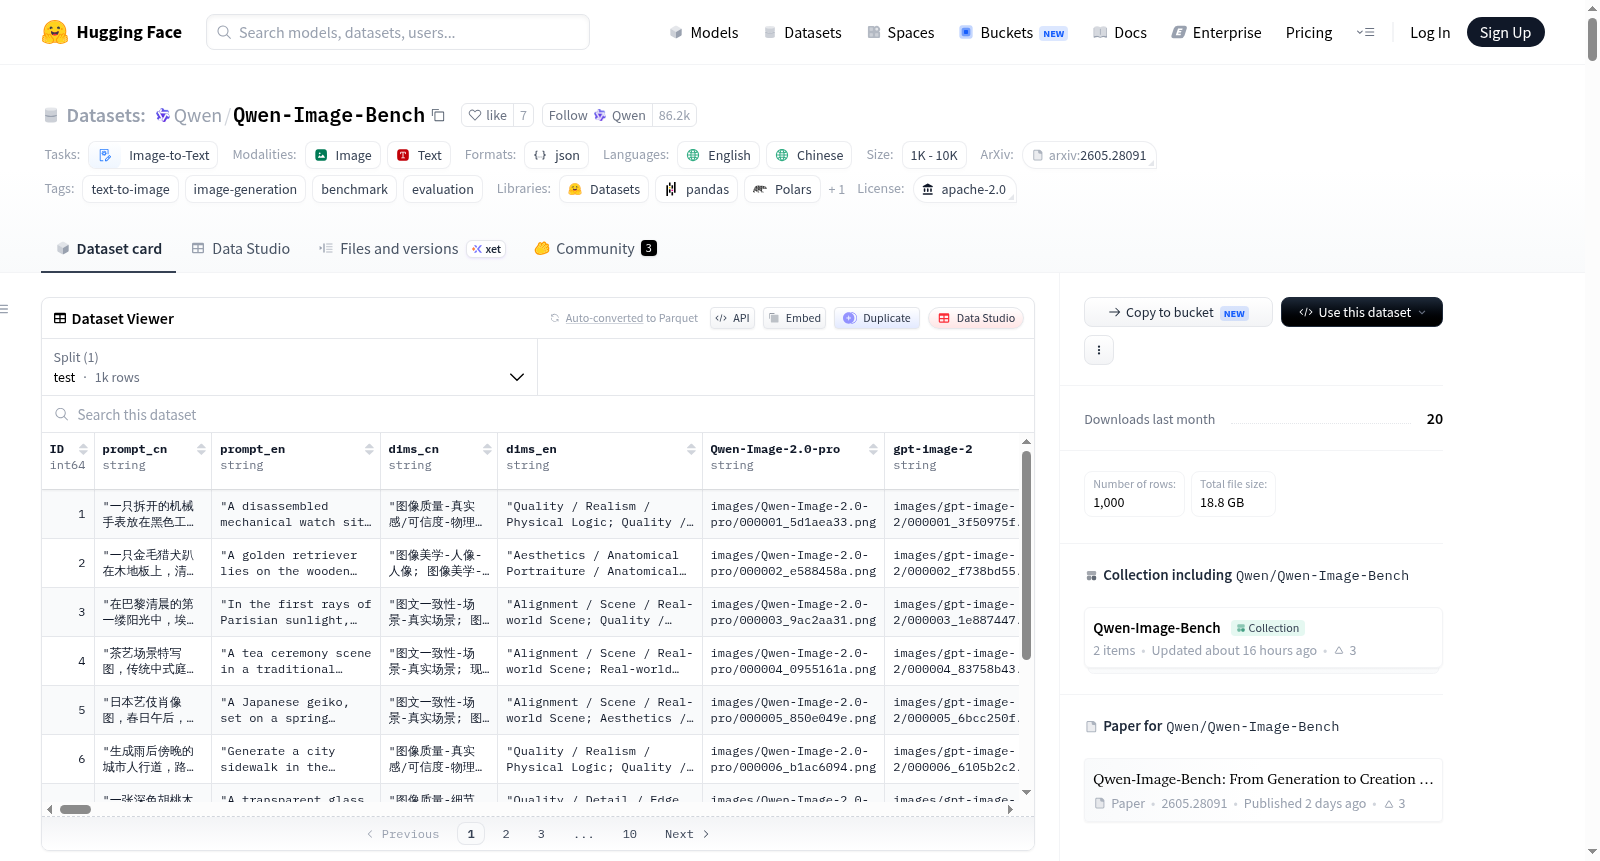
Qwen-Image-Bench 是一个面向创作者的文本到图像生成模型评估基准数据集。它旨在超越传统的语义对齐评估,通过引入“真实世界保真度”和“创意生成”两个应用驱动维度,满足专业创意工作流对真实还原和创意表达的高要求。该数据集包含1,000个由专家精心设计的中英文双语提示词,这些提示词在长度和语言上均衡分布,每个提示词均设计用于联合考察跨多个评估维度的4个以上细粒度方面。数据集采用一个三层层次化评估体系,包含5个顶级支柱(质量、美学、对齐、真实世界保真度、创意生成)、23个子能力和56个具体评估方面。数据集文件为JSONL格式,每条记录包含提示词ID、中英文提示文本、评估维度描述、18个前沿T2I模型(如GPT Image 2、Qwen Image 2.0 Pro等)生成的图像路径,以及一个配套的统一诊断评判模型(Q-Judger)对每个模型在各维度上的原始评估输出。Q-Judger模型基于大量专家标注数据训练,能为每个样本生成覆盖全部56个细粒度方面的得分向量,实现模型能力的精准诊断。该基准适用于对文本到图像生成模型进行全面的、贴近真实创作场景的评估与能力分析。
Qwen-Image-Bench is a benchmark dataset for evaluating text-to-image generation models tailored for creators. It aims to surpass traditional semantic alignment-only evaluations, meeting the high requirements of professional creative workflows for realistic restoration and creative expression by introducing two application-driven dimensions: real-world fidelity and creative generation. This dataset contains 1,000 expertly designed bilingual Chinese-English prompts, which are evenly distributed across both language variants and prompt lengths. Each prompt is engineered to jointly assess more than 4 fine-grained aspects spanning multiple evaluation dimensions. The dataset adopts a three-tier hierarchical evaluation framework, which includes 5 top-level pillars (Quality, Aesthetics, Alignment, Real-world Fidelity, and Creative Generation), 23 sub-capabilities, and 56 specific evaluation aspects. The dataset is distributed in JSON Lines (JSONL) format, with each record containing the prompt ID, Chinese and English prompt texts, evaluation dimension descriptions, image paths generated by 18 cutting-edge text-to-image (T2I) models (e.g., GPT Image 2, Qwen Image 2.0 Pro, etc.), as well as the raw evaluation outputs of each model across all dimensions from the accompanying unified diagnostic judging model, Q-Judger. Trained on a large corpus of expert-annotated data, the Q-Judger model can generate a score vector covering all 56 fine-grained aspects for each sample, enabling precise diagnostic analysis of model capabilities. This benchmark is suitable for comprehensive, real-world creative scenario-aligned evaluation and capability analysis of text-to-image generation models.
数据集概述:Qwen-Image-Bench
Qwen-Image-Bench 是一个以创作者为中心的文本到图像(T2I)生成模型评估基准,旨在超越传统的语义对齐,评估模型在真实创意工作流中的表现。
核心特性:
- 三层等级分类体系 (Three-Level Hierarchical Taxonomy): 从专业艺术工作流程(构思→风格化→迭代优化)出发,自上而下设计。
- 5 个一级支柱 (L1 Pillars): 质量 (Quality)、美学 (Aesthetics)、对齐 (Alignment)、真实世界保真度 (Real-world Fidelity) 和创意生成 (Creative Generation)。
- 23 个二级子能力 (L2 Sub-capabilities): 例如世界知识、文本渲染、视觉叙事、设计应用等。
- 56 个三级评估细项 (L3 Evaluation Facets): 提供细粒度、可验证的评分细则。其中 28 个细项属于“真实世界保真度”和“创意生成”这两个应用驱动的支柱。
- 1,000 条专家精心设计的双语提示 (Expert-Crafted Bilingual Prompts):
- 在文本长度(500 条长提示 + 500 条短提示)和语言(中文/英文)上分层且均衡。
- 每条提示会同时激活多个支柱下的 4 个以上细粒度评估细项。
- Q-Judger 诊断评估模型:
- 基于 Qwen3.6-27B 模型,为每个样本生成跨越全部 56 个三级细项的完整评分向量。
- 在超过 130,000 个由专家标注的双语提示-图像对上训练。
- 由 80 位来自艺术院校的专业标注员监督,每个样本至少有 3 份独立评审。
- 与人类专家判断的排名一致性达到 Spearman ρ = 0.92。
数据概览:
| 属性 | 描述 |
|---|---|
| 许可协议 | Apache-2.0 |
| 任务类型 | 图像到文本 (image-to-text) |
| 语言 | 英语 (en), 中文 (zh) |
| 数据集规模 | 1K < n < 10K (1000 条提示) |
| 标签 | text-to-image, image-generation, benchmark, evaluation |
| 数据文件 | qwen_image_bench_hf_v0518.jsonl (测试集) |
数据字段:
| 字段名 | 类型 | 描述 |
|---|---|---|
ID |
int | 唯一提示标识符 (1-1000) |
prompt_cn |
str | 中文文本提示 |
prompt_en |
str | 英文文本提示 |
dims_cn |
str | 该提示对应的评估维度 (中文) |
dims_en |
str | 该提示对应的评估维度 (英文) |
<model_name> |
str | 各模型生成的图像相对路径 (对应中文提示) |
quality_response_<model> |
str | 评估模型在“质量”维度的原始输出 |
aesthetics_response_<model> |
str | 评估模型在“美学”维度的原始输出 |
alignment_response_<model> |
str | 评估模型在“对齐”维度的原始输出 |
creative_generation_response_<model> |
str | 评估模型在“创意生成”维度的原始输出 |
real_world_fidelity_response_<model> |
str | 评估模型在“真实世界保真度”维度的原始输出 |
包括的模型 (18个): Qwen-Image-2.0-pro, Gpt-Image-2, FLUX.2-Max, Nano-Banana-2.0, Nano-Banana-Pro, Seedream-4.0, Seedream-4.5, Seedream-5.0, GLM-Image, Kling-v2.1, Qwen-Image-2512, Qwen-Image, GPT-Image-1, GPT-Image-1.5, HunyuanImage-3.0, Imagen-4.0, Imagen-4.0-Ultra, FLUX.2-Pro
评估维度 (三级评分体系):
- 质量 (Quality): 包含现实主义(物理逻辑、材质纹理)、细节(噪点、边缘清晰度、自然度)、分辨率。
- 美学 (Aesthetics): 包含构图、色彩和谐、光影、解剖学肖像、情感表达、风格控制。
- 对齐 (Alignment): 包含属性(数量、面部表情、材质属性、颜色、形状、大小)、动作(接触互动、非接触互动、全身动作)、布局(2D空间、3D空间)、关系(构成关系、差异/相似、包含关系)、场景(真实场景、虚拟场景)。
- 真实世界保真度 (Real-world Fidelity): 包含公平性(社会偏见、文化公平)、安全与合规、世界知识(动物、物体、信息可视化、时间特征、文化元素)。
- 创意生成 (Creative Generation): 包含想象力、特征匹配、逻辑解析、文本渲染(文本准确性、文本布局、字体、跨语言生成)、设计应用(平面设计、产品设计、空间设计、时尚造型、游戏设计、艺术设计)、视觉叙事(电影风格、镜头/镜头风格、故事板创作、镜头尺寸、构图、角度、漫画创作)。
评分方法:
- 原始分数映射:
0(失败) →0;1(通过) →60;2(优秀) →100;N/A(不适用) → 排除。 - 评分流水线: 分数自下而上聚合:三级细项 → 二级子能力 → 一级支柱 → 总体得分。每个样本的总体得分是其激活的一级支柱得分的未加权平均值。模型级得分是所有 1000 条提示的平均值。
主要排行榜结果: 在评估的 18 个前沿模型中,GPT Image 2 以 64.69 的总体得分位居榜首,领先第二名近 5 分。模型自然分为 5 个性能梯队。研究发现,“创意生成”和“真实世界保真度”这两个应用驱动支柱表现出最大的模型间方差,而物理逻辑、解剖学保真度等细项是整个 T2I 技术的系统性能力天花板。
获取更多信息:
- 论文: http://arxiv.org/abs/2605.28091
- GitHub 仓库: https://github.com/QwenLM/Qwen-Image-Bench
- 模型 (HuggingFace): https://huggingface.co/Qwen/Qwen-Image-Bench
- 模型 (ModelScope): https://modelscope.cn/models/Qwen/Qwen-Image-Bench
- 数据集 (ModelScope): https://www.modelscope.cn/datasets/Qwen/Qwen-Image-Bench