
unlearning-cleanslate/eval-nemotron-nano-9b-v2-simnpo-gentle-baseline
收藏数据链接:
官方服务:
资源简介:
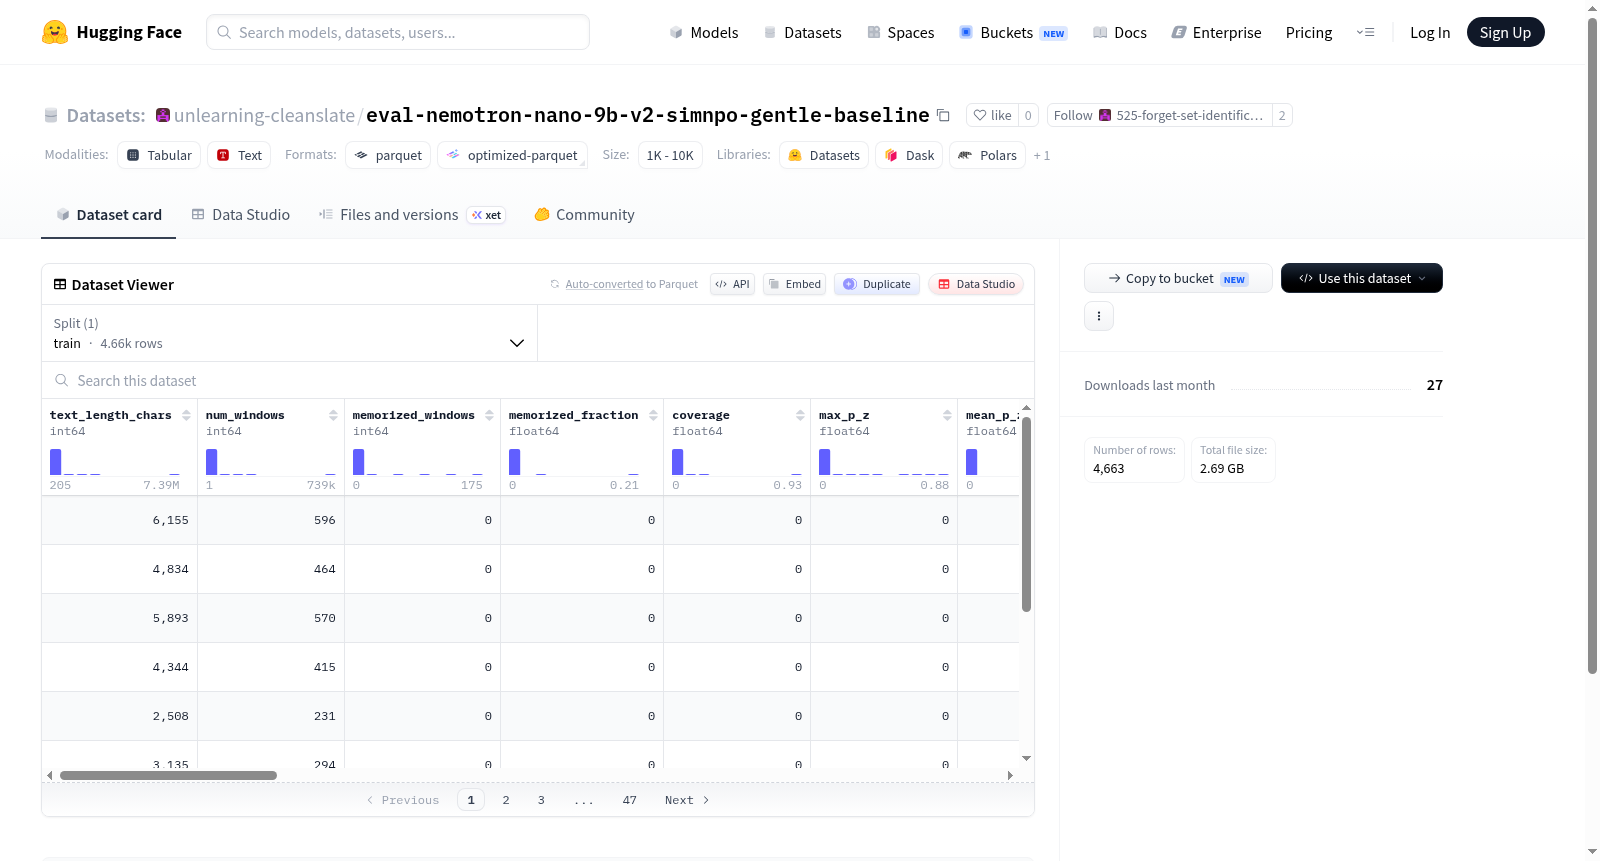
该数据集包含用于评估文本记忆或相关属性的结构化数据,具有多个特征字段,如文本长度、记忆窗口、覆盖度、概率统计值以及内容元信息(如标题、创建者和年份)。数据以训练集形式提供,共4663个示例,每个示例包含详细的窗口级评估结果。
This dataset contains structured data for evaluating text memorization or related properties, with multiple feature fields such as text length, memorized windows, coverage, probability statistics, and content metadata (e.g., title, creators, year). It is provided as a training split with 4663 examples, each including detailed window-level evaluation results.
搜集汇总
数据集介绍
构建方式
该数据集旨在评估Nemotron-Nano-9B-v2模型在SimNPO温和基线设置下的记忆化行为。构建过程基于对模型生成文本的系统性分析,通过将长文本序列分割为固定大小的滑动窗口,并计算每个窗口内目标序列的对数概率与困惑度,从而量化模型对训练数据的记忆程度。每个样本均包含文本长度、窗口数量、记忆窗口数、记忆比例、覆盖度及多种概率统计指标,同时详细记录了概率最高的窗口的起始与结束位置、种子及目标文本。所有评估指标均基于模型在预设窗口尺寸、步长和阈值下的输出计算得出。
使用方法
该数据集适用于研究大型语言模型的记忆化现象及其与训练数据的关系。用户可直接使用HuggingFace的datasets库加载默认分割(train),并利用字段如memorized_fraction、coverage及窗口级信息进行统计分析或可视化。通过比较不同窗口的记忆状态,可定位模型具体记忆的文本片段。建议结合eval_model、window_size等参数,复现评估过程或调整阈值进行灵敏度分析。数据集的列类型包括整数、浮点、字符串及嵌套列表,便于灵活提取与处理。
背景与挑战
背景概述
随着大型语言模型在自然语言处理领域的广泛应用,其训练数据的记忆效应逐渐成为研究焦点。该数据集由研究人员于2024年创建,旨在评估不同训练策略对模型记忆行为的影响。通过细致刻画模型在文本片段上的记忆分数(memorized_fraction)、窗口覆盖(coverage)以及概率分布(p_z)等指标,该数据集为理解模型在何种条件下倾向于记忆特定训练样本提供了量化工具。其影响力在于,推动了模型训练中隐私保护与泛化能力平衡的研究,并为后续模型评估基准的构建奠定了方法论基础。
当前挑战
该数据集面临的核心挑战包括:1)所解决的领域问题为大型语言模型的记忆行为量化,难点在于如何区分模型的有益知识提取与有害数据记忆,避免模型在私有或敏感数据上产生隐私泄露风险;2)构建过程中,需对海量文本进行窗口化处理并计算每个窗口的似然概率,面临计算资源开销大、记忆阈值(eval_threshold)设定主观性强等挑战,同时不同种子(seed)和窗口大小(window_size)的选择可能引入评估偏差,影响结果的可重复性与可信度。
常用场景
经典使用场景
该数据集专为评估和对比大语言模型在长文本生成中的记忆化行为而设计,经典使用场景聚焦于量化模型对训练数据片段的复现倾向。通过记录文本长度、滑动窗口覆盖度及逐窗口的词汇概率分布(如p_z值),研究者能够系统性地检测模型在多大程度上逐字复现了源文本,从而衡量其记忆与泛化能力的平衡。这一框架特别适用于分析不同训练策略(如SimNPO)或模型架构(如Nemotron系列)对记忆化程度的影响,为开发更可靠、更少泄露训练数据的生成模型提供标准化的评估工具。
解决学术问题
该数据集精准回应了大语言模型领域一个棘手的学术难题:如何科学地量化并区分模型的合理泛化与不期望的记忆化行为。传统评估多依赖困惑度或下游任务表现,难以揭示模型是否仅仅记住了训练数据。通过提供细粒度的窗口级记忆化指标(如记忆片段比例、覆盖度、对数概率排名),该数据集使研究者能够深入分析记忆化与模型规模、训练数据重复性、生成策略之间的关联。这一能力对于理解模型泛化边界、防止数据泄露、提升少样本学习真实效果具有奠基性意义,推动了模型安全性与隐私保护研究。
实际应用
在实际应用中,该数据集广泛服务于大语言模型的安全发布评估和质量控制流程。模型开发团队可借助数据集中的记忆化检测结果,在模型发布前审查其是否过多复现了受版权保护或敏感的训练文本,从而规避法律与伦理风险。同时,数据集的细粒度窗口分析可用于诊断和调试模型生成的幻觉问题——当模型在特定主题上表现出异常高的记忆化概率时,提示可能存在训练数据污染或过拟合。此外,该工具也适用于教育领域,帮助教师评估LLM生成的学术内容是否存在抄袭嫌疑。
数据集最近研究
最新研究方向
该数据集聚焦于大语言模型在训练过程中对训练数据的记忆化程度评估,通过精细化的窗口化分析框架,量化模型对特定文本片段的记忆倾向。前沿研究正借助此类数据,深入探索模型能力涌现与数据记忆之间的微妙平衡,尤其是在模型规模与训练动态的双重作用下,如何规避无意中泄露训练数据隐私的风险。近期关于模型遗忘与数据遗忘的研究热点,使得此类评估数据集成为构建更安全、更可靠的基础模型的关键工具,对整个生成式AI生态的合规发展具有深远意义。
以上内容由遇见数据集搜集并总结生成


