
Beetle-Data/da-100M-pretok
收藏官方服务:
资源简介:
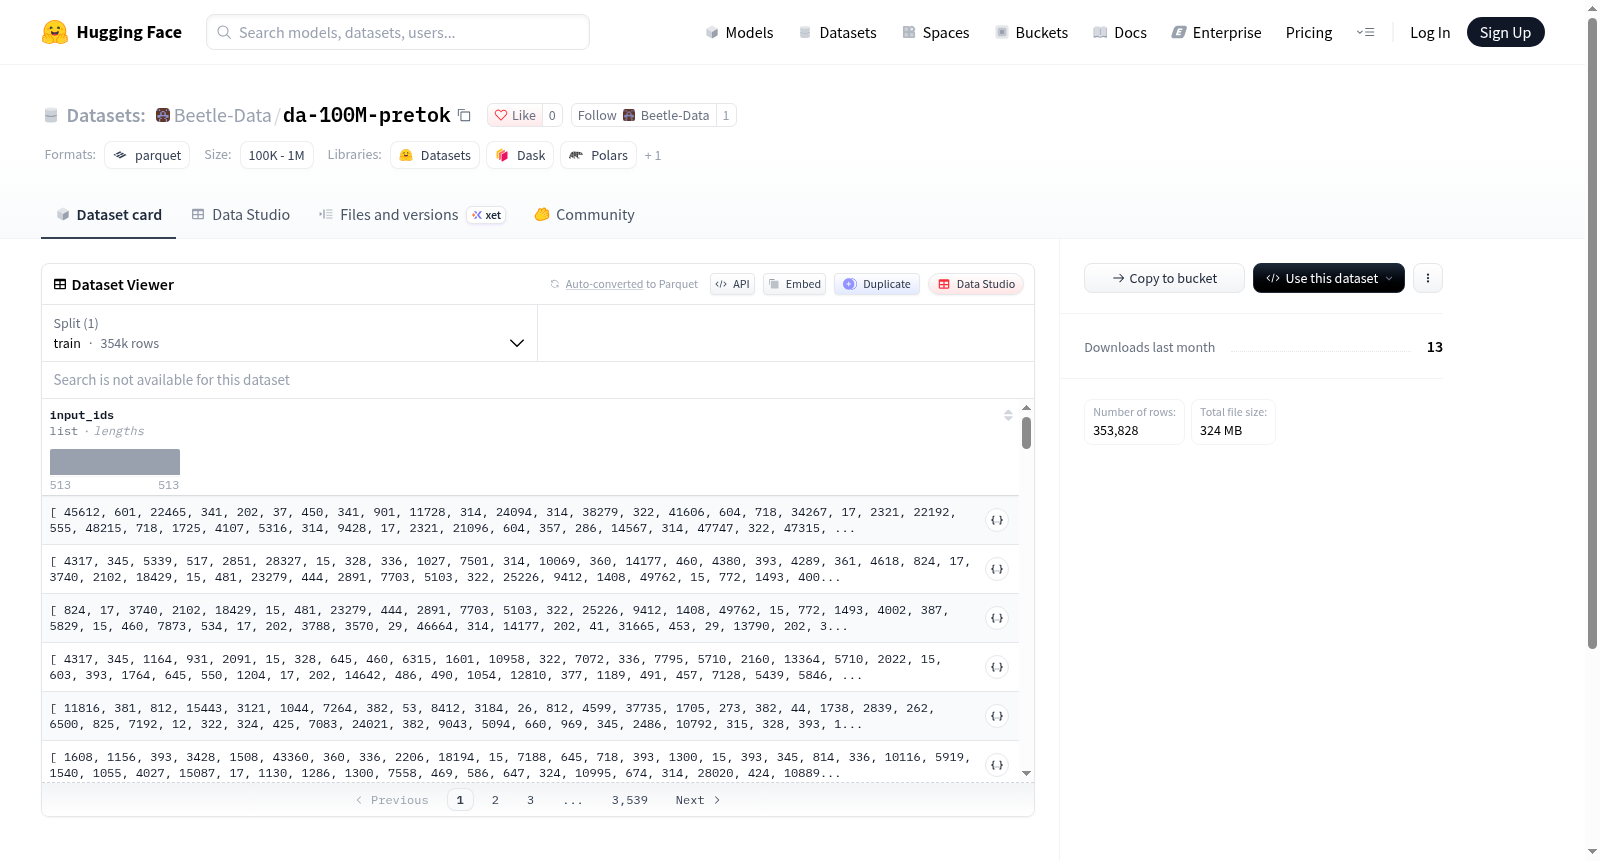
该数据集名为Beetle-Data/da-100M-pretok,是一个经过预分块处理的数据集,每个块包含513个标记的打包序列(input_ids),确保没有跨文档的混合。数据集被分片上传,所有部分上传完成后,会通过data/_finalized.json文件进行标记。
Pretokenized chunks (`input_ids` = 513-token packed sequences, no cross-document bleeding). Sharded incrementally; the marker `data/_finalized.json` is committed once all parts are uploaded.
提供机构:
Beetle-Data搜集汇总
数据集介绍
构建方式
在自回归语言模型预训练愈发依赖高效分词与序列打包的背景下,da-100M-pretok 的构建遵循预分词块范式。据其 Hugging Face 详情页,原始语料经分词器编码后形成 input_ids,并被组织为长度 513 的 packed sequences,且通过边界控制避免跨文档污染。数据以 Parquet 分片形式存放于 data/*.parquet,采用增量式分片上传流程;当所有部件完成上传后,data/_finalized.json 标记被提交,用以指示数据集最终化。配置层面,默认配置 default 通过 data/*.parquet 匹配全部分片。
特点
面向大规模预训练语料对存储效率与训练稳定性的双重诉求,该数据集呈现出若干显著特征。其核心字段为 input_ids,序列长度固定为 513,并以打包方式提升训练时 token 利用率;文档边界隔离机制抑制了跨文档语义渗漏,有利于语言建模目标保持样本独立性。数据以 Parquet 列式分片组织,便于并行读取与分布式训练。增量分片与 _finalized.json 完成标记共同构成完整性指示,使数据版本状态可被追踪。默认配置以通配路径聚合分片,降低加载配置复杂度。
使用方法
在语言模型预训练与微调的数据接入环节,使用者可通过 Hugging Face datasets 等接口加载该数据集,选择默认配置 default,并令其依据 data/*.parquet 读取全部分片。加载后可直接访问 input_ids 字段,将其输入因果语言建模、序列建模或相关预训练流程。由于序列已打包至 513 token,训练侧通常无需再次执行分词与拼接,仅需按框架要求进行张量截断、批处理与设备迁移。依据 data/_finalized.json 可核验分片是否完整,亦支持流式或分片式读取以适应大规模训练管线。
背景与挑战
背景概述
面向大规模语言模型预训练的数据工程正从原始文本清洗转向序列级封装,da-100M-pretok 即在此脉络中形成。该数据集由 Hugging Face 组织 Beetle-Data 发布,公开 README 未标注具体创建时间与个人研究者信息,核心工作是将语料预先切分为 513 个 token 的打包序列,并以 input_ids 序列化存储,明确避免跨文档渗漏;分片增量上传,待全部部件完成后再提交 data/_finalized.json 作为最终化标记。其研究问题在于降低训练期在线分词与文档边界处理开销,提升长序列预训练的数据吞吐、可复现性与读取效率。对依赖固定长度样本的 Transformer 训练流程而言,此类预分词资源构成语料治理与实验复现的重要基础设施。
当前挑战
预训练语料的领域价值与构建难度常呈现共生关系,da-100M-pretok 所涉挑战亦嵌入分词、打包与分片流程之中。其所服务的领域问题在于将海量异构文本转化为语言模型可高效消费的定长 token 序列,同时维持文档语义完整与训练样本边界清晰。构建过程中,513-token 打包需在序列长度、填充效率与文档截断之间取得平衡;跨文档渗漏控制要求精确维护文档边界,避免注意力机制跨样本污染;增量分片上传与 _finalized.json 最终化标记则涉及存储一致性、断点续传、版本校验和全局去重。大规模 Parquet 分片的元数据管理、加载吞吐与数据溯源亦构成工程挑战,任何分片缺失或标记滞后均可能影响下游训练的稳定复现。
常用场景
经典使用场景
在自回归语言模型预训练中,语料通常需完成分词、拼接与分片,以降低训练管线开销。da-100M-pretok 以 input_ids 形式提供 513 词元打包序列,且不跨文档渗透。其经典使用场景是将 Parquet 分片经由 datasets 载入,直接馈入 Transformer 进行因果语言建模;固定长度序列适配大规模批处理与分布式数据并行,规避在线 tokenization 的中央处理器瓶颈。无跨文档 bleeding 保证样本内部语义边界清晰,可用于下一词预测、长上下文训练及 packing 策略比较。增量分片与 _finalized.json 标记便于训练前校验完整性,适合在预训练、继续预训练和消融实验中作为即取即用的词元级语料。
实际应用
在工业与开源模型训练中,该数据集可作为预训练或继续预训练的词元级输入,直接以 Parquet 分片接入 HuggingFace datasets、PyTorch DataLoader 或分布式训练框架,缩短数据准备周期。其 513 词元定长样本适合吞吐优先的批训练、混合精度与梯度累积,也可用于领域适应、指令微调前期语言建模、模型初始化及 tokenizer 与打包策略评测。无跨文档渗透有利于需要干净样本边界的训练与诊断。分片与 _finalized.json 有助于流水线确认数据就绪,便于云端或集群增量加载与校验。
衍生相关工作
公开详情页未列举具体衍生文献或命名模型,故难以确证某一经典工作直接源于该数据集。从可衍生脉络看,基于该语料的因果语言模型预训练可形成模型卡、训练配方与缩放律分析;固定长度无渗透打包便于开展 packing 消融、上下文扩展和 tokenizer 对比;Parquet 分片与终结标记可衍生数据校验、流式加载和可复现训练脚本。后续研究可将其纳入 Beetle-Data 系列的数据配比、继续预训练和评测流水线,构成从语料构建到模型评估的生态链条。
以上内容由遇见数据集搜集并总结生成


