sphragis
收藏资源简介:
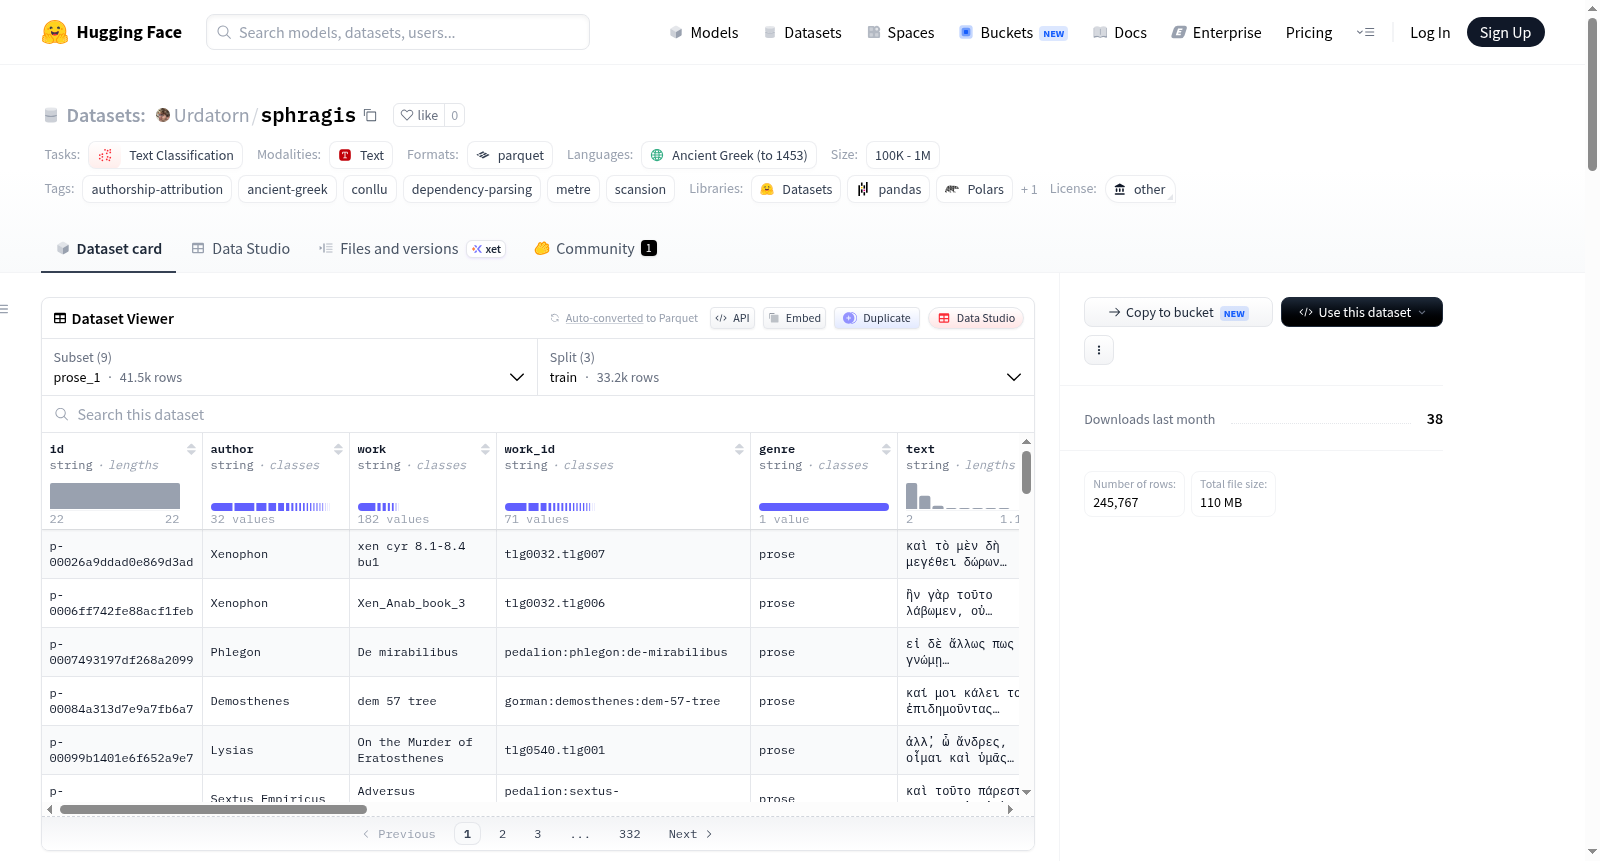
Sphragis 是一个用于古希腊语作者归属的基准数据集(Beta 0.3.2 版本)。它结合了经过许可、人工注释的依存树库(来自 AGDT 2.1、UD Perseus、UD PROIEL、UD PTNK、Gormans Greek Dependency Trees、Pedalion、Harrington Trees 等)和格律注释的 Hypotactic 语料库(Chamberlain 2023)。数据集提供了固定的训练、验证和测试划分,支持文本分类任务。数据集包含9个配置,分为散文(prose)和诗歌(verse)两大类,每类根据最小样本块大小(1、10、100)分为三种配置。诗歌配置进一步分为句级(verse_sentence)和行级(verse_metre)两种,且成对出现。所有配置的划分均采用随机种子776,并按作者/作品组进行分层抽样,大致保持80%训练、10%验证、10%测试的比例。主要列包括:id、author、work、work_id、genre、text、conllu、cts_urn、passage、treebank_source、source_records、licenses、dedup_key、split。其中 genre 字段仅有三个值:prose、verse_sentence、verse_metre。诗歌配置还包含 metrical_line_ids、metrical_lines、parent_sentence_ids、alignment_component_id 等额外列。去重策略:对散文部分进行了基于归一化文本的精确去重,去除了13,510条重复行,并处理了作者标签冲突。诗歌部分通过严格的边界对齐算法确保行与句子的对应关系。依赖表示方面,保留了原始UD数据,并将AGDT/Arethusa树转换为CoNLL-U格式,同时保留原生关系标签。XPOS被归一化为九位古希腊语AGDT/Perseus标签约定。数据集来源包括多个已知语料库,许可为混合许可(包含非商业和共享许可)。作者归属政策保守,排除了匿名、未知作者、伪作、有争议的作品等,保留的作品如《伊利亚特》、《奥德赛》、赫西俄德的《神谱》和《工作与时日》、埃斯库罗斯的《波斯人》和《七将攻忒拜》等。
Sphragis is a benchmark dataset for authorship attribution in Ancient Greek (Beta 0.3.2). It combines licensed, manually annotated dependency treebanks (from AGDT 2.1, UD Perseus, UD PROIEL, UD PTNK, Gormans Greek Dependency Trees, Pedalion, Harrington Trees, etc.) and a metrically annotated Hypotactic corpus (Chamberlain 2023). The dataset provides fixed train, validation, and test splits for text classification tasks. It includes 9 configurations, divided into prose and verse categories, each with three sub-configurations based on minimum sample chunk sizes (1, 10, 100). The verse configurations are further split into sentence-level (verse_sentence) and line-level (verse_metre) pairs. All splits are stratified by author/work group with a random seed of 776, maintaining roughly 80% train, 10% validation, and 10% test proportions. Main columns include id, author, work, work_id, genre, text, conllu, cts_urn, passage, treebank_source, source_records, licenses, dedup_key, split. The genre field has only three values: prose, verse_sentence, verse_metre. Verse configurations also include additional columns like metrical_line_ids, metrical_lines, parent_sentence_ids, alignment_component_id. Deduplication: exact deduplication based on normalized text for prose, removing 13,510 duplicate rows and resolving author label conflicts. Verse deduplication uses strict boundary alignment algorithms. Dependency representation retains original UD data and converts AGDT/Arethusa trees to CoNLL-U format with native relation labels. XPOS is normalized to the nine-category Ancient Greek AGDT/Perseus tag convention. Data sources include multiple known corpora, with mixed licenses (non-commercial and share-alike). Authorship attribution policy is conservative, excluding anonymous, unknown, pseudepigrapha, and disputed works, while retaining works such as Iliad, Odyssey, Hesiods Theogony and Works and Days, Aeschylus Persians and Seven Against Thebes, etc.
Sphragis 数据集概述
基本信息
- 数据集名称: Sphragis
- 语言: 古希腊语 (grc)
- 许可证: 混合许可证(other),包含非商业性和共享相同方式许可的数据
- 任务类型: 文本分类(text-classification)
- 标签: 作者归属(authorship attribution)、古希腊语、CoNLL-U格式、依存句法分析、韵律、格律分析
数据集简介
Sphragis 是一个用于古希腊语作者归属研究的基准数据集(Beta 0.3.2版本),结合了人工标注的依存句法树库和格律标注的Hypotactic语料库,提供固定的训练、验证和测试集划分。
配置与数据规模
数据集包含9种配置,按单元类型和最小作者保留规模(后缀1/10/100)区分:
| 配置名称 | 单元 | 作者数 | 训练集 | 验证集 | 测试集 |
|---|---|---|---|---|---|
prose_1 |
去重后的树库句子 | 32 | 33,172 | 4,146 | 4,146 |
prose_10 |
去重后的树库句子 | 29 | 33,051 | 4,131 | 4,131 |
prose_100 |
去重后的树库句子 | 12 | 25,730 | 3,216 | 3,216 |
verse_sentence_1 |
完整格律对齐的树库句子 | 5 | 12,568 | 1,570 | 1,570 |
verse_sentence_10 |
完整格律对齐的树库句子 | 4 | 12,547 | 1,568 | 1,568 |
verse_sentence_100 |
完整格律对齐的树库句子 | 2 | 11,914 | 1,489 | 1,489 |
verse_metre_1 |
完整句法对齐的扫描行 | 5 | 22,922 | 2,866 | 2,866 |
verse_metre_10 |
完整句法对齐的扫描行 | 4 | 22,895 | 2,862 | 2,862 |
verse_metre_100 |
完整句法对齐的扫描行 | 2 | 21,818 | 2,727 | 2,727 |
所有配置均保持约80/10/10的总体划分比例。后缀表示支持的最小文本块规模,_1配置保留完整的精选数据集。
主要数据列
所有配置包含:
id、author(作者)、work(作品)、work_id、genre(体裁)、text(文本)conllu(CoNLL-U格式句法分析)、cts_urn、passage、treebank_source(树库来源)source_records:包含所有上游记录的JSON,含版本、URL、许可证、标注溯源和句法方案licenses(许可证)、dedup_key(去重键)、split(划分标记)
verse_sentence额外包含metrical_line_ids和完整重叠metrical_lines的JSON列表;verse_metre包含parent_sentence_ids、book、poem_sequence、line_number、格律、扫描及音节级标注。两个韵文配置均包含alignment_component_id。
genre字段仅有三个值:prose、verse_sentence和verse_metre。
数据来源
语料库来自以下数据源:
- AGDT 2.1(Perseus树库)
- UD Perseus、UD PROIEL、UD PTNK
- Gorman的希腊语依存树
- Pedalion树
- Harrington树
- Hypotactic(格律标注语料库)
涵盖作品范围
韵文材料涵盖:《伊利亚特》、《奥德赛》、赫西俄德的《神谱》和《工作与时日》、埃斯库罗斯的《波斯人》和《七将攻忒拜》,以及Semonides的作品。有争议的《七将攻忒拜》段落(861-874和1005-1078行)在完整对齐组件边界处被排除。
数据划分方法
划分使用随机种子776,在每个作者/作品组内独立分层,约80%训练、10%验证、10%测试。3-9行的组获得一行验证和一行测试;少于3行的组保留在训练集中。
作者归属政策
基准优先保障可靠的训练标签而非覆盖面。排除了匿名及未知作者、Pseudo-*及传统归属、片段标记作品、公司或媒介作者身份,以及归属存在重大争议的作品或段落。