ibm-research/MermaidSeqBench
收藏资源简介:
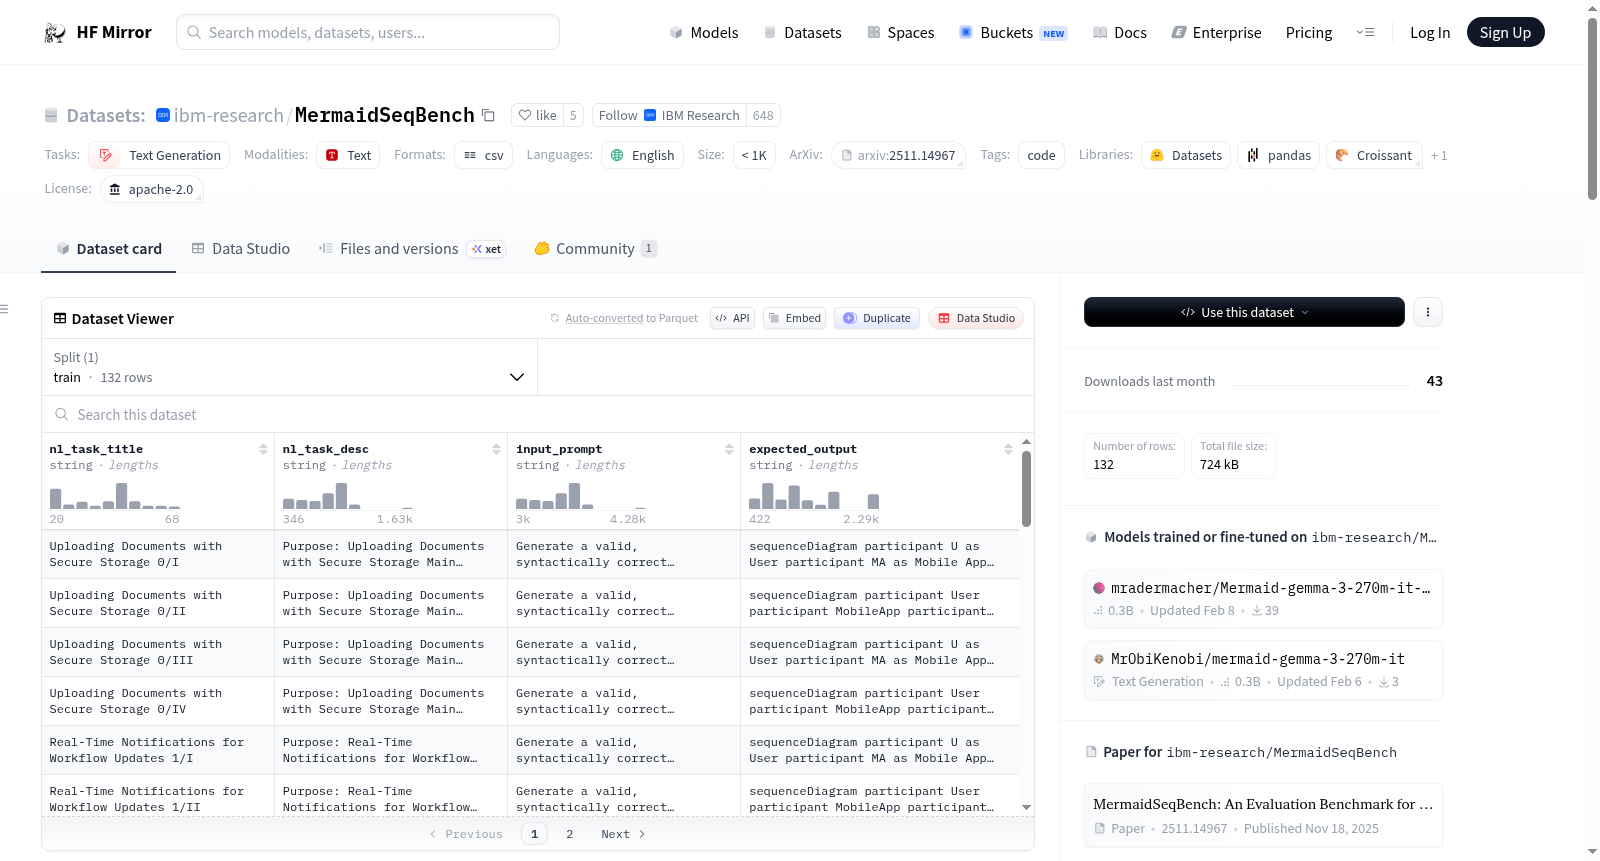
MermaidSeqBench数据集是一个经过人工验证的基准数据集,用于评估大型语言模型(LLM)在根据自然语言提示生成Mermaid序列图方面的能力。数据集由大型语言模型(LLM)合成生成,从领域专家提供的一小部分种子示例开始。所有输出都经过人工标注者的手动验证和校正,以确保有效性和质量。该数据集包含132个样本,每个样本包括任务标题、任务详细描述、输入提示和预期的Mermaid图代码。
The MermaidSeqBench dataset is a human-verified benchmark for assessing large language models (LLMs) on their ability to generate Mermaid sequence diagrams from natural language prompts. The dataset was synthetically generated using large language models (LLMs), starting from a small set of seed examples provided by a subject-matter expert. All outputs were subsequently manually verified and corrected by human annotators to ensure validity and quality. The dataset consists of 132 samples, each containing task title, detailed natural language description of the task, instructional natural language prompt, and the expected Mermaid diagram code.