
遇见数据集

SeFi-Image/SeFi-Image-DiT-Finetune-Demo

收藏
Hugging Face2026-07-19 更新2026-07-22 收录
官方服务:

资源简介:

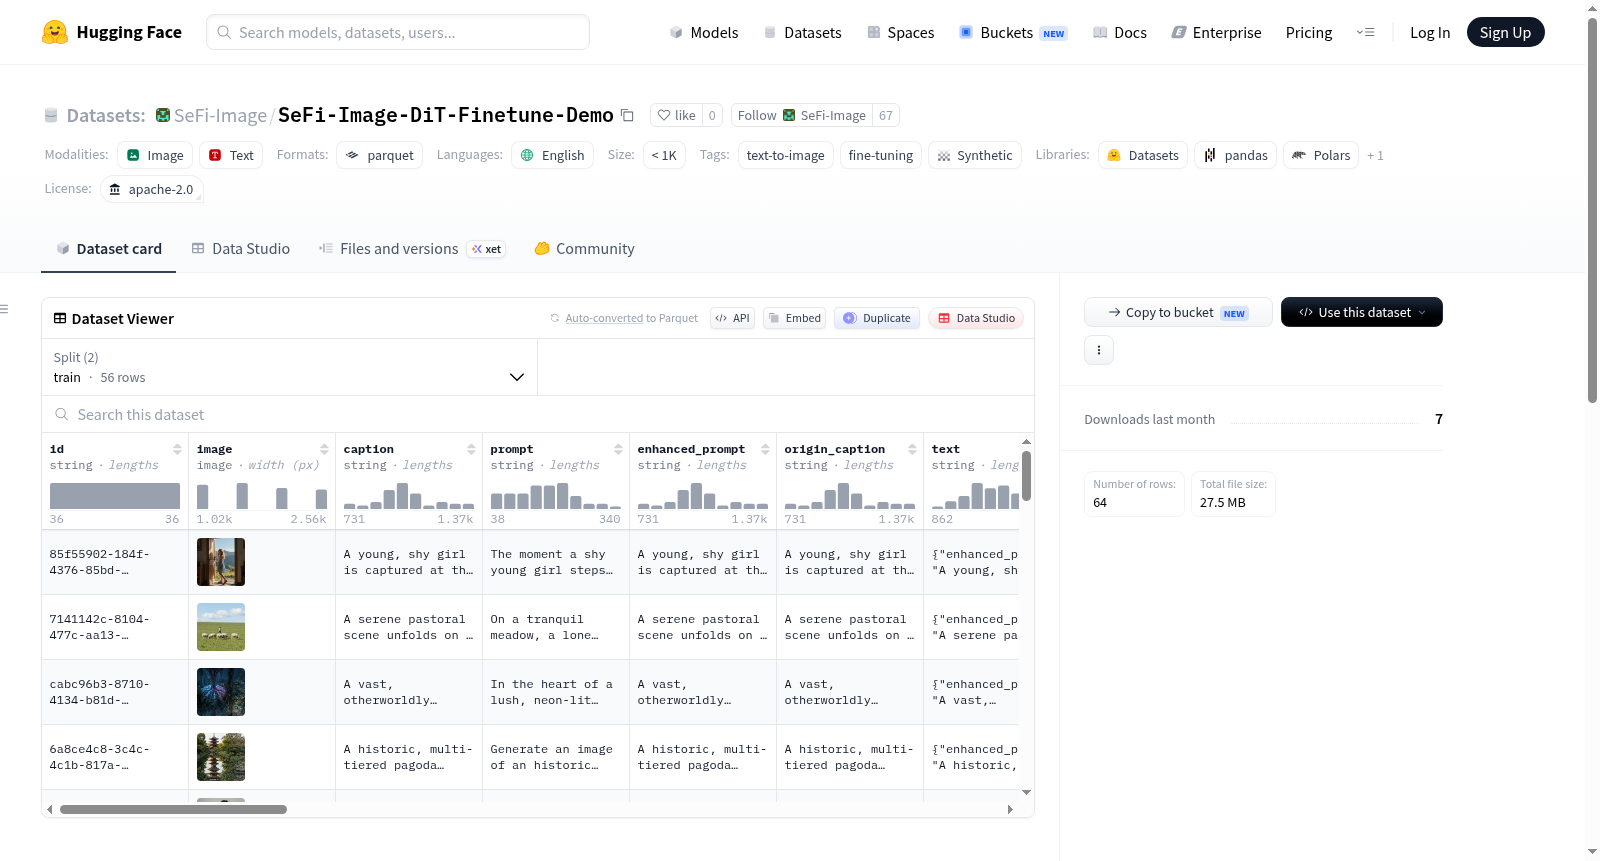
该数据集包含56个训练和8个验证图像-文本对,用于固定1024 DiT(扩散变换器)微调的烟雾测试。数据来源于ma-xu/fine-t2i数据集的synthetic_enhanced_prompt_random_resolution子集,仅包含图像生成器为Z-Image-Turbo的行,并排除了FLUX.2-dev行、现有SemVAE演示源ID以及在提示/图像质量审查中被拒绝的行。数据集通过稳定的源ID进行筛选,并确定性地以4:1的权重选择增强提示和原始提示。图像为至少1024像素的正方形源JPEG文件,在训练加载器中会确定性地调整为1024x1024分辨率。每个数据行包含嵌入的图像、提示、增强提示、来源信息、尺寸、图像SHA-256哈希、生成器元数据以及ai_generated=true标记。该数据集是一个小型合成工程测试数据集,不具代表性训练语料库或模型质量基准功能,生成场景可能包含不完美的解剖结构或渲染文本。

This dataset contains 56 training and 8 validation image-text pairs for fixed-1024 DiT fine-tuning smoke tests. It is derived from the ma-xu/fine-t2i datasets synthetic_enhanced_prompt_random_resolution subset, including only rows where the image generator is Z-Image-Turbo, and excludes FLUX.2-dev rows, existing SemVAE demo source IDs, and rows rejected during prompt/image quality review via stable source ID. The dataset selects enhanced_prompt and prompt with deterministic 4:1 weights, and images are square source JPEGs at least 1024px, resized deterministically to 1024x1024 in the training loader. Each row contains an embedded image, prompt, enhanced_prompt, source provenance, dimensions, an image SHA-256, generator metadata, and an ai_generated=true marker. It is a tiny synthetic engineering fixture, not a representative training corpus or model-quality benchmark, and generated scenes may contain imperfect anatomy or rendered text.
提供机构:
SeFi-Image
搜集汇总
数据集介绍
SeFi-Image/SeFi-Image-DiT-Finetune-Demo 数据集图片
构建方式
该数据集源自`ma-xu/fine-t2i`数据集的`synthetic_enhanced_prompt_random_resolution`子集,经过严格的筛选与重构而成。仅保留由Z-Image-Turbo生成的图像-文本对,剔除了FLUX.2-dev行、现有SemVAE演示源ID以及提示语与图像质量审核未通过的数据,最终获得56个训练样本与8个验证样本。数据构建中,增强提示语与原始提示语以4:1的确定权重被选择,所有图像均为边长至少1024像素的方形JPEG,训练加载器将其统一缩放至1024×1024分辨率,确保数据一致性与模型适配性。
特点
该数据集专为固定分辨率1024的DiT微调烟雾测试设计,具有轻量、纯净与可控三大特性。每行数据嵌入图像、原始提示语、增强提示语、来源溯源、尺寸、图像SHA-256哈希、生成器元数据及ai_generated=true标记。附属的manifest.json锁定了源版本与分片摘要,selection_manifest.json则记录了确定性选择逻辑、质量排除项及分割顺序。所有图像经工程审查,确保无EXIF、GPS、XMP、IPTC或注释载荷,且排除了隐私、水印、公司标识等敏感元素,是一个经精心净化的合成工程夹具。
使用方法
用户可通过HuggingFace的`datasets`库直接加载数据集,使用`load_dataset("SeFi-Image/SeFi-Image-DiT-Finetune-Demo")`命令即可获取训练与验证拆分,并通过索引访问每行的`prompt`字段。该数据集主要作为DiT模型微调流程的快速验证工具,适用于检测训练管线的正确性与稳定性。需注意,此为小型合成工程夹具,并非代表性训练语料或模型质量基准,生成的场景可能存在解剖学缺陷或渲染文本问题,用户在应用前应自行检查上游许可条款与用例合规性。
背景与挑战
背景概述
在文本到图像生成领域,扩散模型(Diffusion Models)已成为主流框架,其中DiT(Diffusion Transformer)架构因其可扩展性与生成质量而备受关注。然而,该领域的研究高度依赖大规模、高质量的图文配对数据,而对模型进行微调(fine-tuning)以适配特定场景或风格时,往往面临数据量不足、标注成本高昂等问题。SeFi-Image-DiT-Finetune-Demo数据集由SeFi-Image团队于近期创建,旨在为固定1024分辨率下的DiT模型微调提供轻量级、可复现的烟雾测试(smoke test)基准。该数据集包含56个训练样本和8个验证样本,均源自ma-xu/fine-t2i数据集的子集,并经严格筛选,仅保留由Z-Image-Turbo生成的样本,同时剔除了FLUX.2-dev与SemVAE相关的源数据。数据集精心设计了确定性选择策略(增强提示与原始提示以4:1权重混合),并进行了工程审查以确保样本的出处、质量、隐私与安全性。作为一个小型但严谨的工程测试工具,该数据集为验证DiT微调流程的正确性与可复现性提供了标准化起点,在模型开发与基准测试中具有实用价值。
当前挑战
SeFi-Image-DiT-Finetune-Demo数据集所解决的领域问题是:在文本到图像生成模型的微调过程中,缺乏一个规模紧凑、来源清晰、标注一致且便于快速验证管道正确性的基准数据集。现有大规模数据集如LAION-5B或COCO虽涵盖广泛,但直接用于微调测试时,数据量庞大、噪声较多,不便于快速迭代与调试。构建过程中的挑战包括:第一,需从上游数据集fine-t2i中精确筛选出由Z-Image-Turbo生成的样本,同时排除FLUX.2-dev和SemVAE等非目标源,确保数据源的纯净性;第二,对图像与文本对进行多维度的质量审查,包括出处、配对质量、隐私信息、水印、公司标识、知识产权引用和内容安全,并移除所有EXIF、GPS、XMP等元数据,以保障发布合规性;第三,数据规模极小(仅64对),需在确定性选择与随机性之间取得平衡,确保训练、验证拆分的可复现性,同时要求图像分辨率至少为1024px正方形,适应固定分辨率DiT微调的需求。这些挑战共同塑造了该数据集作为工程测试夹具的独特定位。
常用场景
经典使用场景
在文本到图像生成领域,SeFi-Image-DiT-Finetune-Demo数据集为扩散变换器(DiT)模型的高效微调提供了一种轻量级验证基准。该数据集精心筛选了56个训练样本与8个验证样本,所有图像均源自Z-Image-Turbo生成器,并经过严格的质量审查,确保无隐私泄露与版权风险。其经典用途在于作为烟雾测试(smoke test)工具,帮助研究者在固定1024×1024分辨率下快速验证DiT微调流程的正确性与稳定性,尤其适用于检查数据加载、模型适配及训练管道的完整性。
解决学术问题
该数据集核心解决了文本到图像微调研究中基准测试碎片化的问题。学术社区常因缺乏统一、轻量的验证集而难以快速迭代模型,SeFi-Image-DiT-Finetune-Demo通过提供标准化的合成数据与确定性选择权重(enhanced_prompt与prompt按4:1权重混合),使得研究者能够分离模型改进与数据质量变量的影响。其意义在于构建了可复现的微调评估起点,推动了DiT架构在资源受限场景下的快速原型验证,同时为合成数据在模型优化中的可靠性提供了实证基础。
衍生相关工作
该数据集衍生了一系列关于合成数据质量评估与微调策略的重要工作。其源头母集Fine-T2I启发了后续研究对多生成器(如FLUX.2-dev)输出差异的对比分析,而SeFi-Image-DiT-Finetune-Demo的确定性选择逻辑则催生了更系统的数据子集选择方法。此外,包含的Z-Image-Turbo元数据为探索高效生成器与DiT架构协同优化提供了实验平台,相关论文已围绕合成数据中的解剖学缺陷与文本渲染精度展开深入探讨,推动了生成内容鲁棒性评估框架的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

