
遇见数据集

electricsheepasia/asia-ilo-emp-3wap-sex-age-dsb-rt-youth-employment-to-population-ratio-by-sex-age-an

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

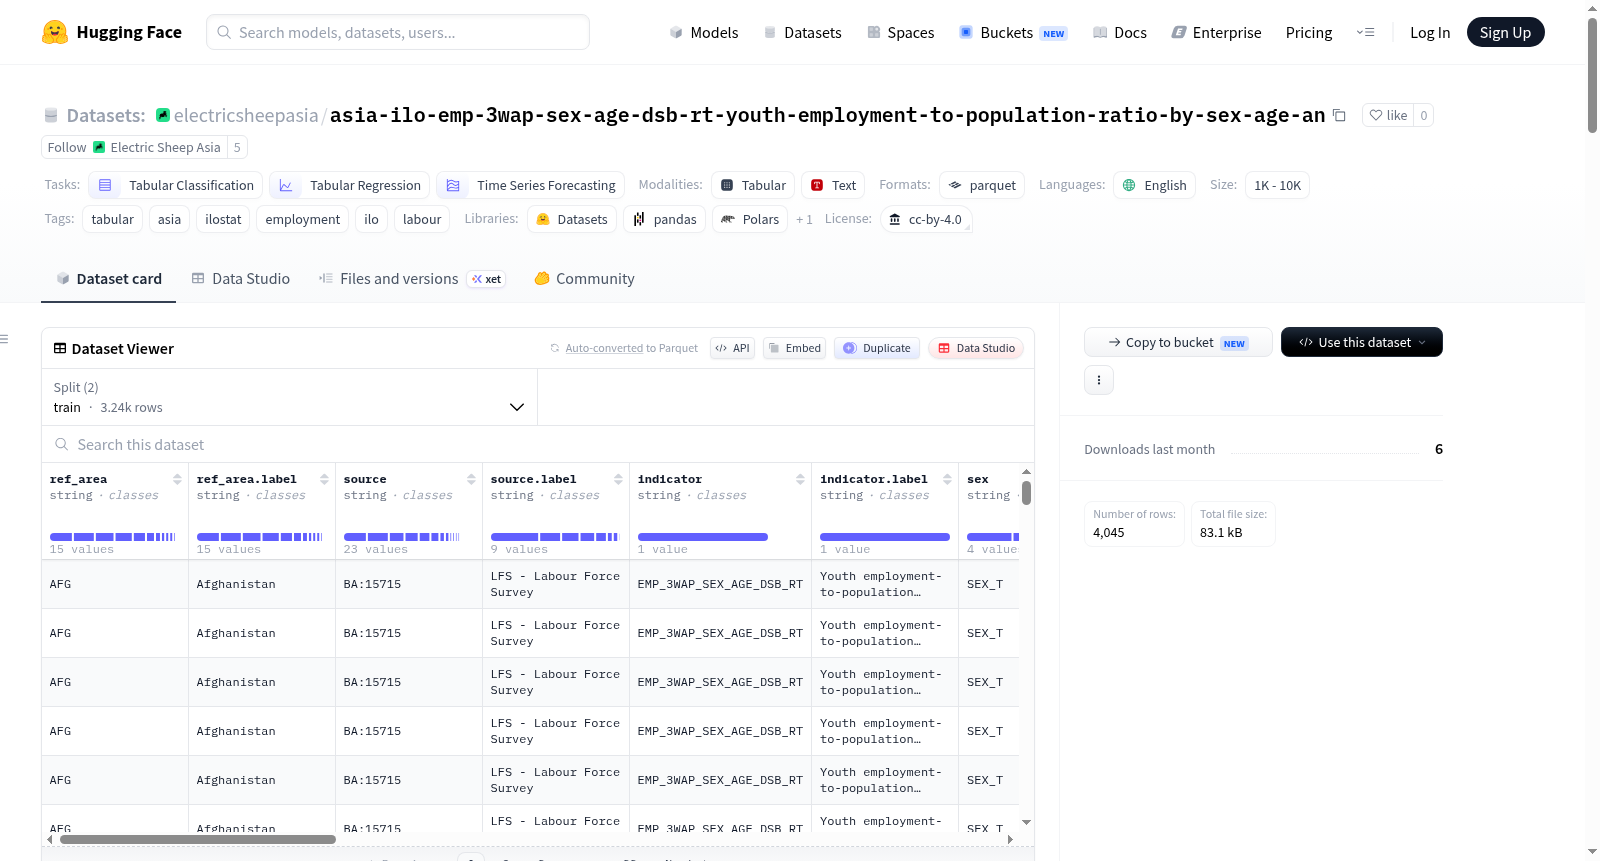
该数据集包含亚洲23个国家从1996年到2024年的青年就业人口比率数据,具体指标为“按性别、年龄和残疾状况分的青年就业人口比率(%)”。数据集共有4,045个观测值,数据来源于国际劳工组织(ILO)的ILOSTAT统计数据库,通过API获取并过滤到亚洲国家。数据以表格形式组织,包括国家代码、国家名称、数据来源、指标代码、指标名称、性别分类(如总计、男性、女性)、年龄分类(青年年龄段:15-29岁)、残疾状况分类、观测年份、观测值、观测状态标志以及相关注释列。数据按年度频率提供,并经过ILO的协调处理,使用国际劳工统计学家会议(ICLS)的定义。数据集适用于表格分类、回归和时间序列预测等任务,旨在为研究者和开发者提供机器学习就绪的亚洲就业数据。

This dataset contains youth employment-to-population ratio data for 23 Asian countries from 1996 to 2024, with the specific indicator Youth employment-to-population ratio by sex, age and disability status (%). It includes 4,045 observations sourced from the International Labour Organizations (ILO) ILOSTAT statistical database, retrieved via API and filtered to Asian countries. The data is organized in tabular format, covering columns such as country code, country name, data source, indicator code, indicator name, sex disaggregation (e.g., total, male, female), age classification (youth bands: 15-29), disability status classification, observation year, observed value, observation status flags, and related notes. The data is provided at annual frequency and harmonized using International Conference of Labour Statisticians (ICLS) definitions. It is suitable for tasks like tabular classification, regression, and time-series forecasting, aiming to offer machine learning-ready employment data for Asia.
提供机构:
electricsheepasia
搜集汇总
数据集介绍
electricsheepasia/asia-ilo-emp-3wap-sex-age-dsb-rt-youth-employment-to-population-ratio-by-sex-age-an 数据集图片
构建方式
该数据集源自国际劳工组织(ILO)旗下的ILOSTAT统计数据库,通过其REST API接口直接提取原始指标代码为EMP_3WAP_SEX_AGE_DSB_RT的数据,并依据ISO 3166-1 alpha-3标准筛选出覆盖23个亚洲国家的观测记录。数据采集后,由Electric Sheep Asia团队进行规范化处理,统一模式并封装为Parquet格式,最终以HuggingFace数据集形式发布,确保了从原始劳动统计到机器学习就绪数据的无缝衔接。
特点
数据集总计包含4,045条观测值,时间跨度自1996年至2024年,聚焦于青年就业人口比率这一核心指标,并按性别、年龄及残疾状态进行精细分层。其独特价值在于整合了来自不同国家劳动力调查的异构微观数据,并依据国际劳工统计学家会议(ICLS)定义进行标准化处理,同时通过'来源标签'和详尽的'观测状态'注释字段,如方法论修订和定义偏差,为数据质量与可比性提供了透明且可追溯的保障。
使用方法
研究者可通过HuggingFace的`load_dataset`函数直接载入该数据集,并利用返回的DataFrame对象进行灵活操作。典型用法包括通过`ref_area`字段过滤特定国家(如印度尼西亚)的子集数据,针对单一指标按时间序列排序后进行可视化分析,或借助透视表功能将数据重塑为国家与年份的矩阵结构,从而便捷地服务于比较研究、趋势预测及分类或回归模型的构建。
背景与挑战
背景概述
在全球劳动统计领域,国际劳工组织(ILO)的ILOSTAT数据库被视为权威数据源,为研究劳动力市场动态提供了坚实基础。该数据集由Electric Sheep Asia于2024年重新打包发布,聚焦亚洲23个国家1996年至2024年间青年就业人口比率的时序观测,核心指标为基于性别、年龄与残疾状况分层的青年就业人口比率。这一精细维度使得学术界得以深入探究亚洲地区青年劳动力参与的结构性特征,尤其为分析残疾青年群体的就业困境、性别差异以及代际不平等提供了罕见的量化工具,其影响力体现在弥合了区域劳动统计中针对脆弱群体的数据鸿沟,推动了包容性劳动力市场政策的循证研究。
当前挑战
数据集面临的首要领域挑战在于青年就业人口比率这一指标本身在亚洲多国定义不统一,部分国家采用非标准残疾定义或修订后的调查方法,导致跨国的纵向可比性受限。构建过程中,数据整合遭遇多重障碍:不同来源的劳动力调查数据需依据国际劳工统计学家会议标准进行协调,但原始数据中频繁出现方法论断裂(如指标修订标记 'Break in series')与观测值可靠性标记(如标记为 'Unreliable'),迫使研究者需额外处理时序不一致性。此外,性别分类中出现的 'SEX_O'(其他)类别样本稀少,进一步加剧了子群体分析时的统计推断不稳定性,这些因素共同构成了从原始调查到可用数据集转换的核心挑战。
常用场景
经典使用场景
该数据集聚焦于亚洲23个国家1996至2024年间青年就业人口比率,并依据性别、年龄及残疾状态进行细致分层,为劳动经济学与社会政策研究提供了宝贵的时间序列微观数据。经典使用场景涵盖:借助面板数据模型探析青年就业率在性别与残疾维度下的长期演变趋势与国别差异;通过多元回归分析识别影响残疾青年就业的关键社会经济因素;以及基于时间序列预测方法构建青年劳动力市场未来态势的预估模型。
实际应用
在现实政策制定与国际发展项目中,该数据集展现了不可替代的实践价值。各国劳动部门可依据不同性别与残疾类别的就业比率,识别出最亟需职业培训与社会保障干预的目标人群;国际组织如ILO与联合国开发计划署能基于跨国的纵向比较,评估《残疾人权利公约》等框架在各国青年就业领域的落地成效;非政府组织亦可借此定位区域性高失业率节点,设计靶向性的创业扶持与就业中介服务方案,从而促进亚洲青年劳动力市场的包容性转型。
衍生相关工作
围绕该数据集衍生出了一系列具有影响力的研究工作。在学术发表层面,已有研究者基于其中性别分层数据构建了劳动力市场性别不平等指数的扩展测算模型,亦有团队利用残疾状态分类字段,首次系统测算了东南亚残疾青年就业隐形成本并发表于区域经济学顶刊。在工具层面,数据提供了标准化接口与清晰的分层字段,催生了多个适配ILO统计框架的Python预测分析包(如ilostat-explorer)。同时,该数据集作为Electric Sheep Asia统一数据层的一部分,也为多源数据融合的亚洲劳动力综合监测系统搭建了关键组件。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

