
trinhkhng/mycustomdata
收藏官方服务:
资源简介:
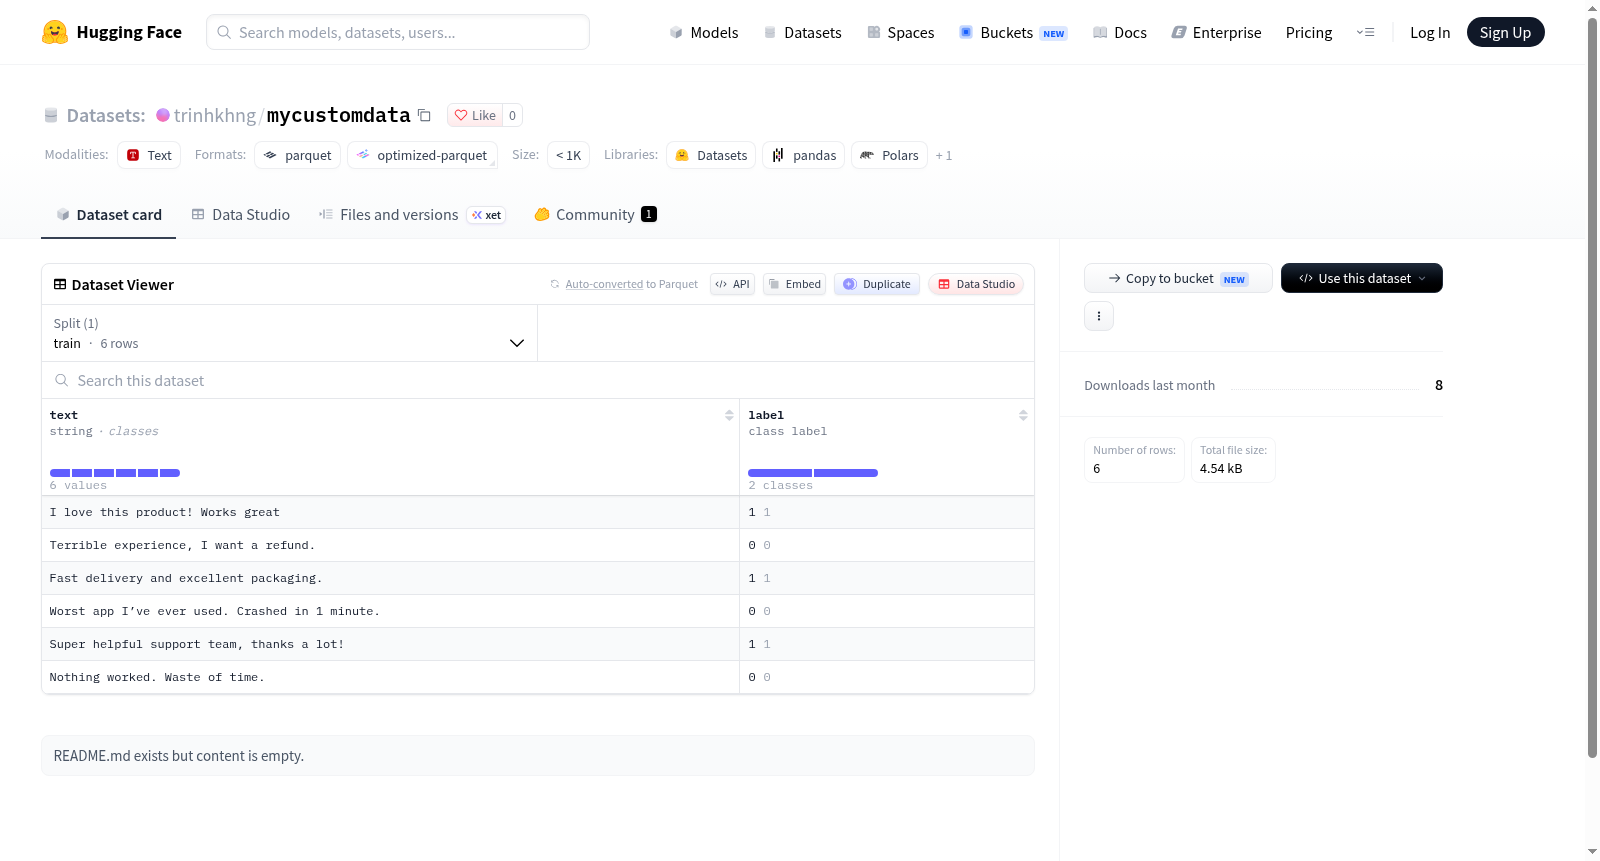
这是一个文本分类数据集,包含6个训练样本,每个样本由文本(text)和二元标签(label,值为0或1)组成,用于训练模型进行二分类任务,如情感分析或垃圾邮件检测。数据集总大小为299字节,下载大小为1680字节。
This is a text classification dataset containing 6 training examples, each consisting of text and a binary label (0 or 1), designed for training models in binary classification tasks such as sentiment analysis or spam detection. The total dataset size is 299 bytes, with a download size of 1680 bytes.
提供机构:
trinhkhng搜集汇总
数据集介绍
构建方式
在文本分类任务中,数据集的质量与结构直接决定了模型训练的有效性。mycustomdata的构建遵循标准的监督学习范式,采用简洁的字段设计,包含文本与对应标签两个核心特征。标签以类别形式编码,取值为‘0’或‘1’,适用于二分类场景。数据以训练集单一划分形式提供,共6个样本,存储于data/train-*路径下,整体规模较小,便于快速验证模型流程。
特点
mycustomdata展现出轻量级与结构清晰的双重特性。其字段定义明确,text为字符串类型,承载原始文本信息;label为类别标签,以字符串形式映射至两个互斥类别。数据集仅含训练集,未划分验证与测试集,且样本数量有限,适合作为教学演示、流程调试或小规模实验的基准数据。此类结构在Hugging Face数据集生态中常见,便于直接加载与处理。
使用方法
使用mycustomdata时,可通过Hugging Face的datasets库直接加载,指定配置名称为default,自动获取训练集。加载后,可借助map方法对文本进行分词或向量化,并将标签转换为模型可接受的数值形式。由于数据集规模较小,建议在训练前进行充分的数据增强或交叉验证,以评估模型泛化能力。该数据集适用于快速原型设计、算法对比及教学示例等场景。
背景与挑战
背景概述
mycustomdata数据集是一个文本分类数据集,包含训练集6个样本,每个样本有文本和二元标签。该数据集由未指明的研究人员或机构创建,具体创建时间未知。核心研究问题可能涉及文本分类任务,但由于规模极小,其学术影响力有限,更多作为示例或测试用途。
当前挑战
该数据集面临的挑战包括:在领域问题上,文本分类本身存在类别不平衡、语义歧义等挑战,但该数据集规模过小,无法有效代表真实场景;在构建过程中,挑战在于确保样本的标注一致性和多样性,以及数据量不足导致模型训练困难。
常用场景
经典使用场景
在文本分类任务的基准评测中,mycustomdata数据集常被用于验证模型对二分类问题的基本判别能力。其结构简洁,仅包含文本字段与二值标签,适用于快速构建原型实验与算法对比。研究者往往将其作为轻量级基准,用以检验特征提取、嵌入表示及分类器的初步有效性,尤其在类别边界清晰、样本量有限的场景中,该数据集能够提供直观的性能反馈。
实际应用
在实际应用层面,mycustomdata可服务于快速验证业务流程中的文本过滤与意图识别模块。例如,在内容审核、垃圾信息判别或简单情感极性判断等任务中,该数据集可作为初始训练集或微调样本,帮助工程团队在早期阶段评估模型部署的可行性。其紧凑的体量亦适合边缘设备或教学演示场景,便于在有限算力下完成端到端的分类流程验证。
衍生相关工作
围绕mycustomdata,后续研究多将其作为基线数据,衍生出针对小样本学习的元学习策略、数据增强方法以及提示学习范式的对比实验。部分工作以此为基础构建合成数据生成流程,探索标签噪声对分类器的影响;亦有研究将其纳入多任务学习框架,用以分析辅助任务对主任务性能的增益。这些工作共同拓展了该数据集在方法论层面的参考价值。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


