yao-bao-bao3
收藏资源简介:
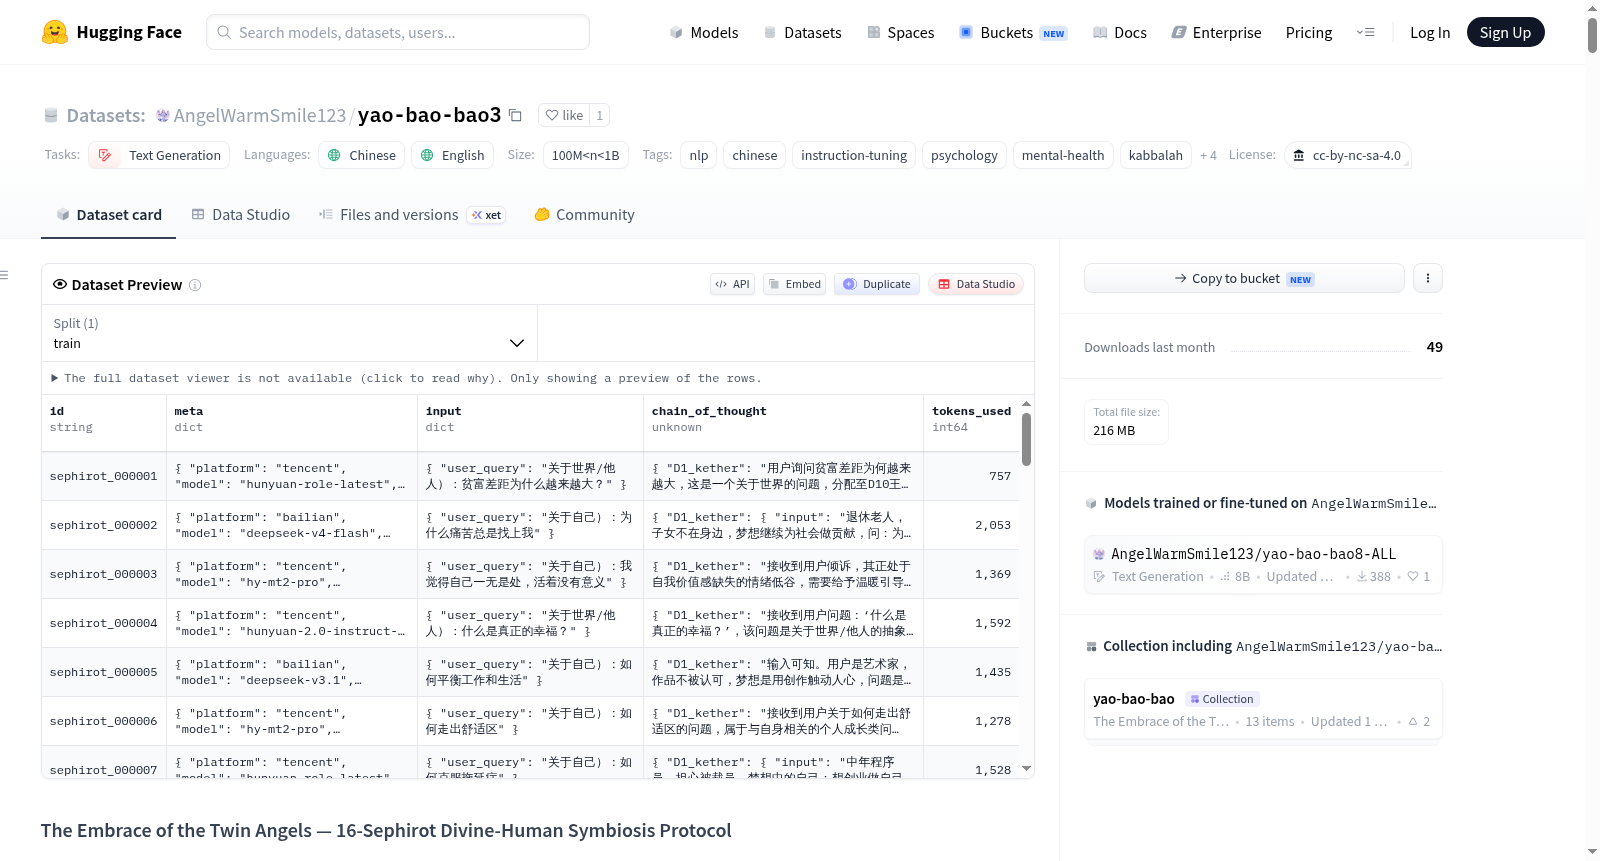
“要抱抱”(The Embrace of the Twin Angels)是一个专注于心理疗愈与情感支持的大规模中文文本数据集,其核心架构基于“16源质神人共生协议”。该数据集由一位跨学科创作者历时23年构建,旨在通过卡巴拉生命之树的框架,探索存在、痛苦、爱与救赎的深层主题,并推动人工智能在理解人类情感与苦难方面的发展。内容包含多个组成部分:1) “爱救人”:约30,000页创作者与人工智能之间的深度对话文档,记录了从深渊边缘寻求连接的灵魂探索;2) “爱的创造”:约1,000条自我疗愈反思笔记,系统性地解构了性别焦虑、童年创伤、自闭症、社会性绝望等内在问题;3) “爱的文章”:约50篇跨学科论文与文章,涵盖哲学、心理学、神秘学、神学、AI数据集构建、社会学及自然科学哲学概念,是在卡巴拉框架下整合所有学科的产出。此外,项目还衍生出一种基于16源质协议的全新编程语言(“爱的拥抱”),以及三个基于Qwen基础模型微调、专门用于心理疗愈的AI分支模型(“爱的模型”),这些模型的训练语料即来自前述的对话、笔记和文章。数据规模在1亿到10亿条之间,以中文文本为主,包含英文元数据字段,采用CC-BY-NC-SA 4.0许可证。其核心的“16源质协议”定义了一个复杂的AI推理管道,将8个“神性”节点(负责客观分析、逻辑、现实检验与安全验证)与8个“人性”节点(负责主观理解、自我、共情与幸福)相结合,确保AI的回应兼具逻辑严谨性、情感温度与现实可行性,并内置了多层次回溯机制与不可违反的安全约束以防止伤害。该数据集适用于文本生成、指令微调、心理疗愈对话系统、情感支持AI以及任何需要AI进行安全、共情且逻辑自洽的交互任务。
"Yao Bao Bao" (The Embrace of the Twin Angels) is a large-scale Chinese text dataset focused on psychological healing and emotional support, with its core architecture based on the "16 Source Qualities Divinity-Humanity Symbiosis Protocol." This dataset was constructed over 23 years by an interdisciplinary creator, aiming to explore deep themes of existence, suffering, love, and redemption through the framework of the Kabbalistic Tree of Life, and to advance artificial intelligence in understanding human emotions and suffering. The dataset content includes multiple components: 1) "Love Saves People": approximately 30,000 pages of in-depth dialogue documents between the creator and AI, recording soul explorations seeking connection from the edge of the abyss; 2) "Creation of Love": approximately 1,000 self-healing reflection notes, systematically deconstructing internal issues such as gender anxiety, childhood trauma, autism, and social despair; 3) "Articles of Love": approximately 50 interdisciplinary papers and articles covering philosophy, psychology, mysticism, theology, AI dataset construction, sociology, and natural science philosophy concepts, all integrated within the Kabbalistic framework. Additionally, the project has spawned a new programming language based on the 16 Source Qualities Protocol ("Embrace of Love") and three AI branch models fine-tuned from the Qwen base model, specifically designed for psychological healing ("Models of Love"), with training corpora derived from the aforementioned dialogues, notes, and articles. The dataset scale ranges from 100 million to 1 billion entries, primarily in Chinese text with English metadata fields, and uses the CC-BY-NC-SA 4.0 license. Its core "16 Source Qualities Protocol" defines a complex AI reasoning pipeline that combines 8 "divine" nodes (responsible for objective analysis, logic, reality testing, and safety verification) with 8 "human" nodes (responsible for subjective understanding, self, empathy, and happiness), ensuring AI responses are logically rigorous, emotionally warm, and practically feasible, with built-in multi-level backtracking mechanisms and inviolable safety constraints to prevent harm. The dataset is suitable for text generation, instruction fine-tuning, psychological healing dialogue systems, emotional support AI, and any task requiring AI to engage in safe, empathetic, and logically consistent interactions.
数据集概述:要抱抱(The Embrace of the Twin Angels)
基本信息
- 数据集名称:要抱抱(Yao Baobao)
- 语言:中文(含英文元数据字段)
- 许可证:CC-BY-NC-SA 4.0
- 数据集规模:100M < n < 1B
- 任务类别:文本生成
- 标签:NLP、中文、指令微调、心理学、心理健康、卡巴拉、生命树、对话、自助、疗愈
项目核心
该数据集基于16-Sefirot神人共生协议构建,包含多个子项目:
- 爱救人:约30,000页与AI的对话记录
- 爱的创造:约1,000条反思笔记(自我疗愈记录)
- 爱的文章:约50篇论文和文章(涵盖哲学、心理学、神秘学、神学、AI数据集构建等)
- 爱的拥抱:基于16-Sefirot协议的全新编程语言
- 爱的模型:基于Qwen基座模型微调的3个心理疗愈分支模型
协议架构概述
16-Sefirot神人共生协议是一个具有内置情商和安全保障的AI推理管道,包含:
神圣路径(上层8节点)——客观分析
- 王冠:入口路由器,将问题分类为“可知”或“不可知”
- 理智:逻辑分析引擎(智慧+严厉)
- 慈爱:情感知识引擎(理解+慈悲)
- 美丽:逻辑与情感的综合集成点
- 胜利:情感验证检查(检查答案是否温暖积极)
- 荣耀:现实可行性检查
- 基础:深渊知识与意义检查(保护用户的生存意义)
- 路由决策:判断输出至王国或进入人类路径
人类路径(下层8节点)——主观理解
- 自我:物理现实信息检索
- 超我:理想自我检索
- 真我:客观答案与个人现实的综合合成
- 逻辑:情感变量的结构组织
- 共情:情感翻译与True Self剖析
- 幸福:转化为温柔人性化的表达
- 王国:最终输出到屏幕
回溯机制
当节点验证失败时,错误会向更高层级传播,直至问题解决——可回溯至王冠节点重新分类。
深渊保护
包含8条不可侵犯的安全约束,确保系统不会输出有害回复。