
SoftPromptTranslator/SUPER-NATURALINSTRUCTIONS-english-filtered-100x-augmented
收藏数据链接:
官方服务:
资源简介:
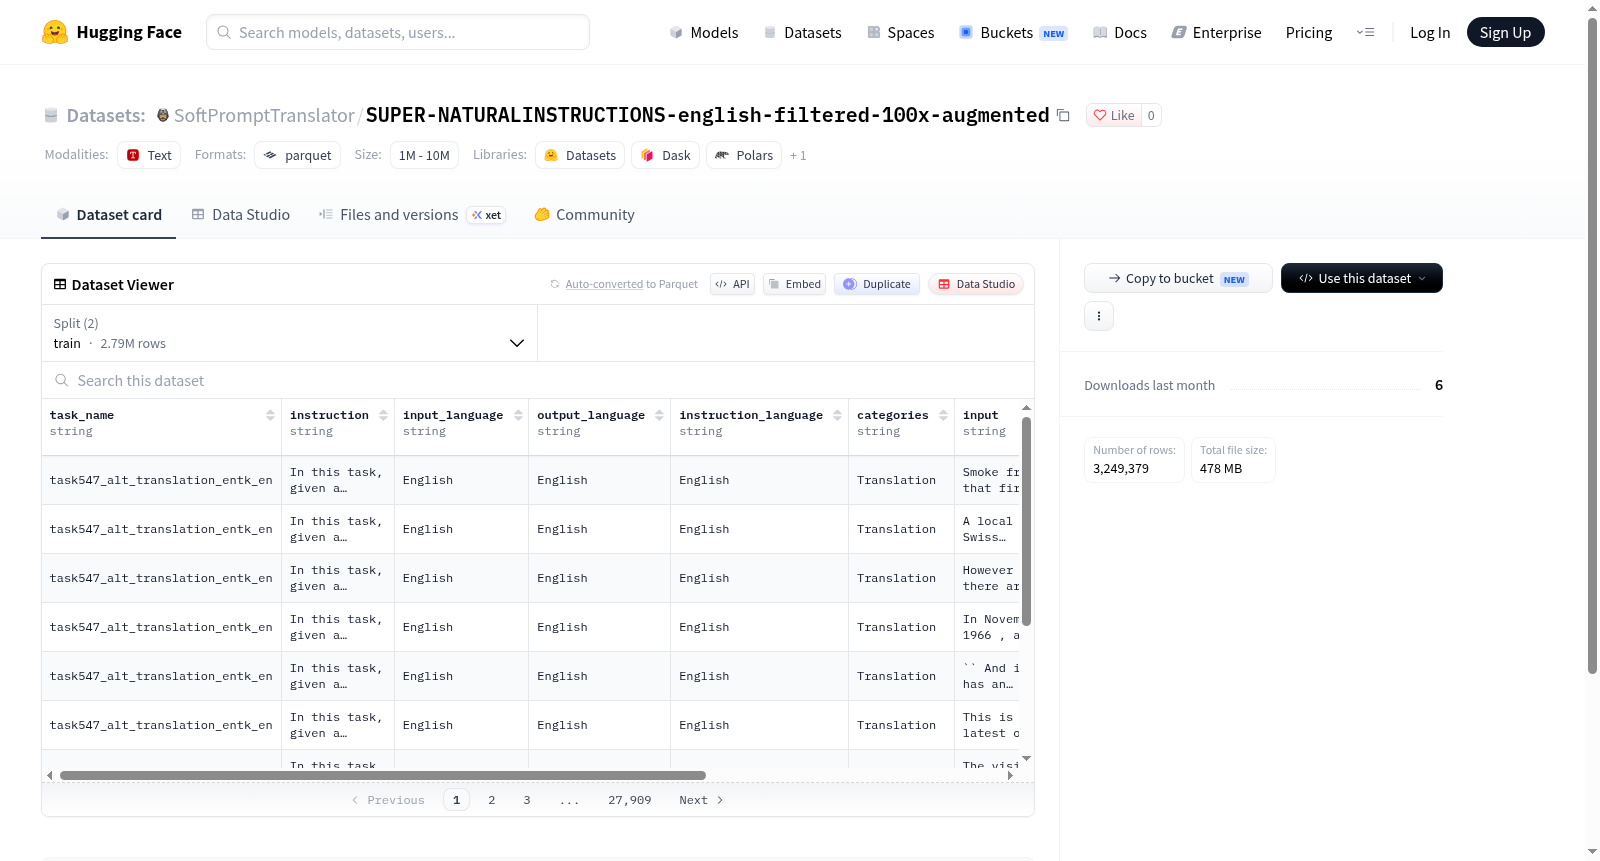
该数据集是一个多语言指令数据集,包含任务名称、指令、输入语言、输出语言、指令语言、类别、输入文本、输出文本以及总token数等字段。训练集包含约279万条样本,测试集包含约45.8万条样本。数据集可用于多语言指令微调、任务型对话、跨语言NLP任务等场景。
This dataset is a multilingual instruction dataset containing fields such as task name, instruction, input language, output language, instruction language, categories, input text, output text, and total tokens. The training set has approximately 2.79 million samples, and the test set has about 458,000 samples. It can be used for multilingual instruction fine-tuning, task-oriented dialogue, and cross-lingual NLP tasks.
提供机构:
SoftPromptTranslator搜集汇总
数据集介绍
构建方式
在自然语言处理领域,指令微调数据的规模与多样性对模型泛化能力具有决定性影响。该数据集以SUPER-NATURALINSTRUCTIONS为基底,经英语语种过滤后,对原始指令进行100倍数据增强。构建过程保留任务名称、指令、输入输出语言、类别、输入文本、输出文本及总词元数等字段,并额外记录缩减指令列表,以维持语义一致性的同时扩展表达变体。增强策略通过生成多样化的指令改写,使训练集达到2,790,891条样本,测试集为458,488条样本,整体数据体量约68.9GB,从而在有限原始资源下显著提升指令覆盖密度。
特点
该数据集的核心特征在于其大规模英语指令增强与多维度元数据标注。每个样本均携带任务名称、指令语言、输入输出语言及类别标签,便于按语言或任务类型进行细粒度分析。reduced_instructions字段以列表形式保存指令的简化版本,为研究指令冗余与语义压缩提供便利。数据划分为训练集与测试集,规模分别为2,790,891和458,488条,总词元数标注有助于控制计算成本。经100倍增强后,指令表达多样性显著提升,同时保持原始任务语义,适用于评估模型在英语指令遵循与跨任务迁移中的稳健性。
使用方法
使用该数据集时,可借助HuggingFace datasets库直接加载默认配置,训练集与测试集分别对应train和test划分。加载后,每条样本包含instruction、input、output等字段,可直接用于指令微调或上下文学习实验。研究者可根据input_language、output_language或instruction_language筛选特定语言子集,亦可利用categories进行任务分组评估。total_tokens字段有助于按词元预算采样,reduced_instructions可用于指令去重或多样性分析。该数据集适用于训练和评测英语指令遵循模型,也可作为研究数据增强对模型性能影响的基准资源。
背景与挑战
背景概述
大规模指令微调数据的构建是提升语言模型泛化能力的关键环节。Super-NaturalInstructions系列数据集由研究者于2022年前后推出,旨在汇集涵盖多语言、多任务的自然语言指令,以推动指令遵循与零样本迁移研究。该系列整合了来自众多现有数据集的任务定义与示例,形成了统一的指令格式。本数据集在其基础上进行了英文过滤与百倍增强,扩充了训练与测试样本规模,为探究数据规模对模型指令理解能力的影响提供了重要资源。
当前挑战
该数据集所应对的核心挑战在于多任务指令理解的统一建模,即模型需在异构任务间实现知识迁移与指令泛化。构建过程中的挑战包括:从多样来源整合任务时保持指令语义一致性与格式规范;英文过滤可能引入语言偏差;百倍增强在扩充数据的同时可能放大噪声或冗余,影响数据质量;大规模数据带来的存储与计算开销亦对训练效率构成压力。
常用场景
经典使用场景
在自然语言处理领域,指令微调是提升大语言模型泛化能力的关键途径。SUPER-NATURALINSTRUCTIONS-english-filtered-100x-augmented数据集汇聚了海量英语指令-输出对,并经过百倍数据增强,为模型训练提供了丰富的监督信号。其经典使用场景聚焦于指令遵循能力的系统锤炼,研究者常将其作为微调语料,促使模型精准解析多样化任务描述,并生成符合预期的回应。凭借涵盖广泛任务类别与语言变体的特性,该数据集成为评估模型零样本与少样本学习性能的重要基准。
实际应用
在实际应用中,该数据集广泛服务于对话系统、智能助手及自动化内容生成等场景。开发者利用其训练模型理解复杂用户意图,并生成准确、连贯的响应。例如,在客户服务中,模型可依据指令处理多轮咨询;在代码生成领域,它帮助模型根据自然语言描述输出可执行代码。数据集的百倍增强特性进一步提升了模型在低资源任务上的表现,为工业级部署提供了可靠的数据支撑。
衍生相关工作
基于该数据集,学界涌现出诸多经典工作,包括指令微调方法的改进、多任务学习策略的优化以及模型对齐技术的探索。部分研究利用其增强数据验证了指令多样性对模型鲁棒性的增益,另一些工作则以此为基础构建了更细粒度的评估基准。这些衍生工作不仅深化了对指令遵循机制的理解,也推动了参数高效微调与持续学习等方向的发展。
以上内容由遇见数据集搜集并总结生成


