
遇见数据集

bus_speeds_inner_hcm

收藏
Hugging Face2026-06-16 更新2026-06-17 收录
官方服务:

资源简介:

Chinese-LLM-Alignment是一个专为中文大语言模型(LLM)对齐研究而构建的数据集。该数据集旨在通过人类反馈来提升模型在指令遵循、无害性、有用性等方面的表现。数据来源于众包平台(如Amazon Mechanical Turk),由人类参与者针对多样化指令提供自然语言响应,并对多个模型生成的响应进行偏好判断。数据集规模约为10,000个指令-响应对,以及约100,000条人类偏好标签。数据以JSONL格式组织,每个指令条目包含原始指令、多个候选模型响应以及对应的人类偏好排序或评分。该数据集适用于训练和评估中文LLM的对齐能力,可用于监督微调、基于人类反馈的强化学习(RLHF)等任务。数据收集过程遵循伦理规范,已获得参与者知情同意,并进行了匿名化处理。

Chinese-LLM-Alignment is a dataset specifically constructed for alignment research of Chinese large language models (LLMs). It aims to enhance model performance in areas such as instruction following, harmlessness, and helpfulness through human feedback. The data is sourced from crowdsourcing platforms (e.g., Amazon Mechanical Turk), where human participants provide natural language responses to diverse instructions and make preference judgments on multiple model-generated responses. The dataset comprises approximately 10,000 instruction-response pairs and about 100,000 human preference labels. It is organized in JSONL format, with each instruction entry containing the original instruction, multiple candidate model responses, and corresponding human preference rankings or scores. This dataset is suitable for training and evaluating the alignment capabilities of Chinese LLMs and can be used for tasks such as supervised fine-tuning and reinforcement learning from human feedback (RLHF). The data collection process adheres to ethical standards, with informed consent obtained from participants and anonymization applied.

创建时间:
2026-06-04
原始信息汇总

数据集名称

bus_speeds_inner_hcm

许可证

MIT(麻省理工学院开源许可证)

数据集描述

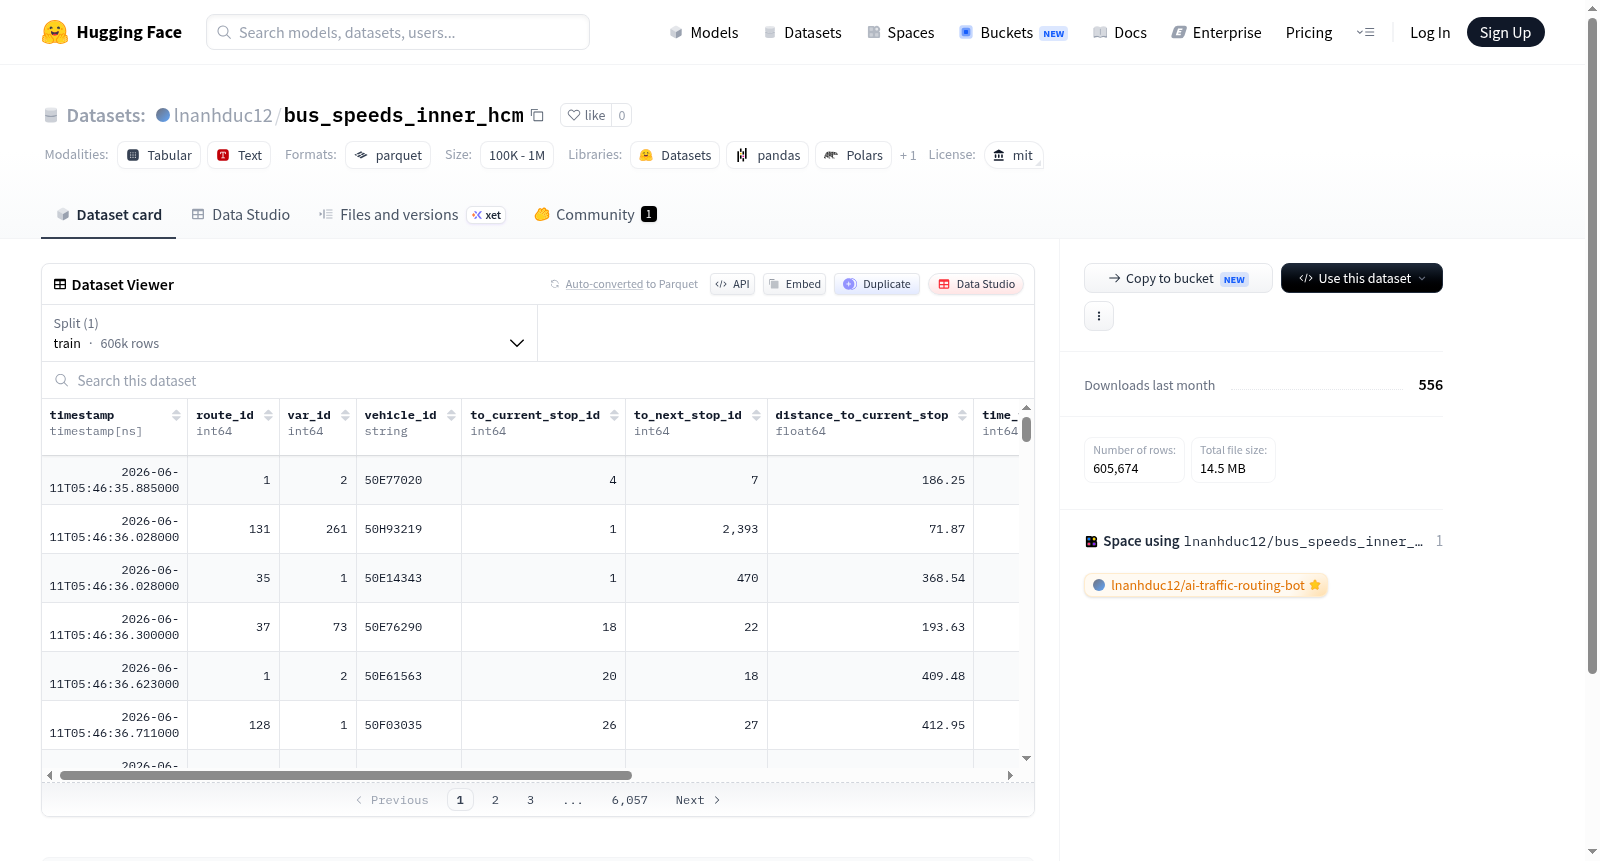
该数据集位于Hugging Face平台,具体内容涉及胡志明市(HCM)内部公交车的速度数据。数据集由用户 lnanhduc12 上传,未提供其他详细的描述或使用说明。

文件与结构

该数据集页面未提供详细的文件列表、数据格式、字段说明或样本数据。

用途与许可

数据集采用 MIT 许可证,允许自由使用、修改和分发,但需保留原版权声明。具体应用场景(如交通分析、城市研究等)需用户根据数据内容自行探索。
搜集汇总
数据集介绍
bus_speeds_inner_hcm 数据集图片
构建方式
在智能交通系统与城市大数据分析的交汇领域,公共交通运行效率的量化研究始终是学术与实践关注的焦点。本数据集聚焦于越南胡志明市(HCM)中心城区的公交车速数据,其构建过程遵循了严谨的数据采集与处理流程。通过部署在公交车辆上的GPS定位设备,以高频率连续记录车辆的位置、时间戳与瞬时速度信息,再经由原始数据的清洗、异常值剔除及空间匹配,最终提炼出覆盖城市核心路网的路段级公交车速数据。这一方法确保了数据在时间粒度与空间分辨率上的精细度,为后续分析提供了可靠基础。
特点
该数据集呈现出鲜明的时空异质性与应用导向性。在时间维度上,数据覆盖了完整的工作日与节假日周期,能够揭示早晚高峰、平峰及夜间等不同时段的公交车速波动规律;在空间维度上,数据按胡志明市内的具体街道与路口进行划分,精确反映了不同等级道路上的交通拥堵状况。此外,数据集以MIT开源协议发布,允许研究者自由使用与衍生,这极大地促进了城市交通流动性、公交优先策略评估及交通仿真模型校验等领域的开放科学合作。
使用方法
针对该数据集,研究者可将其直接用于交通流时空模式挖掘、公交运行延误成因分析以及拥堵热点识别。具体使用时,可导入Python的Pandas库进行数据清洗与时间序列重采样,结合GeoPandas进行空间连接与路网匹配,并利用Scikit-learn或TensorFlow等机器学习框架构建基于历史数据的公交车速预测模型。数据集的结构化字段(如时间戳、线路ID、路段ID与速度值)设计清晰,便于与OpenStreetMap等开源地图数据进行联合分析,从而支撑从路网拥堵诊断到智能公交调度优化的全链条研究。
背景与挑战
背景概述
在城市交通管理领域,公交运行速度是评估公共交通系统效率与服务质量的核心指标之一。bus_speeds_inner_hcm数据集应运而生,旨在捕捉特定区域(如胡志明市内环)的公交速度时空动态。该数据集由相关交通研究机构或数据团队创建,聚焦于分析城市公交在拥堵环境下的实际运行表现,为智能交通系统(ITS)中的公交优先策略、出行时间预测及路网优化提供实证基础。其发布对城市交通规划与数据驱动决策具有重要参考价值,尤其助力于高密度城市区域的交通可持续性研究。
当前挑战
该数据集面临的挑战主要体现在两个维度。领域问题层面,它致力于破解城市中心区公交运行效率低下的难题,尤其是如何从复杂交通流中分离出公交专用路权与非混行干扰的影响,以精确建模速度波动。构建过程中,数据采集面临GPS信号遮挡、设备精度差异等硬件限制,同时需处理异常值、时间稀疏及车道级匹配等问题,确保时空连续性与代表性,这对算法鲁棒性和数据清洗流程提出了严苛要求。
常用场景
经典使用场景
在智慧交通与城市计算研究领域,公交速度数据是解析城市交通脉动、评估公共交通服务质量的关键要素。该数据集聚焦于胡志明市内部公交线路的运行速度记录,为城市交通动态分析提供了细粒度的时序观测。经典使用场景包括构建公交到站时间预测模型,利用历史速度序列来预估车辆在特定路段的通行时长;同时,它也常被用于挖掘公交运行模式与节假日、天气等外部因素的关联规律,从而支持交通流模拟与拥堵热点识别。
衍生相关工作
围绕该数据集,学界已衍生出多项经典工作:在数据挖掘层面,研究者基于其时序特性开发了针对公交速度的异常事件检测框架,用于识别交通事故或临时管制引发的路网异动;在模型创新领域,该数据集被用作时空图卷积网络(ST-GCN)的验证基准,以刻画路网节点间的动态关联性;此外,它还催生了结合众包轨迹与公交GPS的融合数据集构建方法,进一步丰富了城市移动性的研究资源。
数据集最近研究
最新研究方向
该数据集聚焦于胡志明市内部公交线路的车速监测与分析,是城市交通管理与智慧城市建设领域的关键资源。结合当前全球对可持续交通和智慧城市的关注,尤其是在发展中国家快速城市化背景下,公交系统效率提升成为热点。该数据集支持对公交运行速度的细粒度建模,可应用于实时交通流预测、公交调度优化及拥堵热点识别等前沿方向。其MIT开源许可协议鼓励研究者开展跨区域对比与模型迁移学习,推动低资源城市交通数据的共享与复用。该数据集的持续更新与开放将助力交通管理部门制定更科学的路权分配策略,对缓解城市拥堵、降低碳排放具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

