
遇见数据集

cnmc-leukemia-2019

收藏
Hugging Face2024-06-30 更新2024-12-12 收录
官方服务:

资源简介:

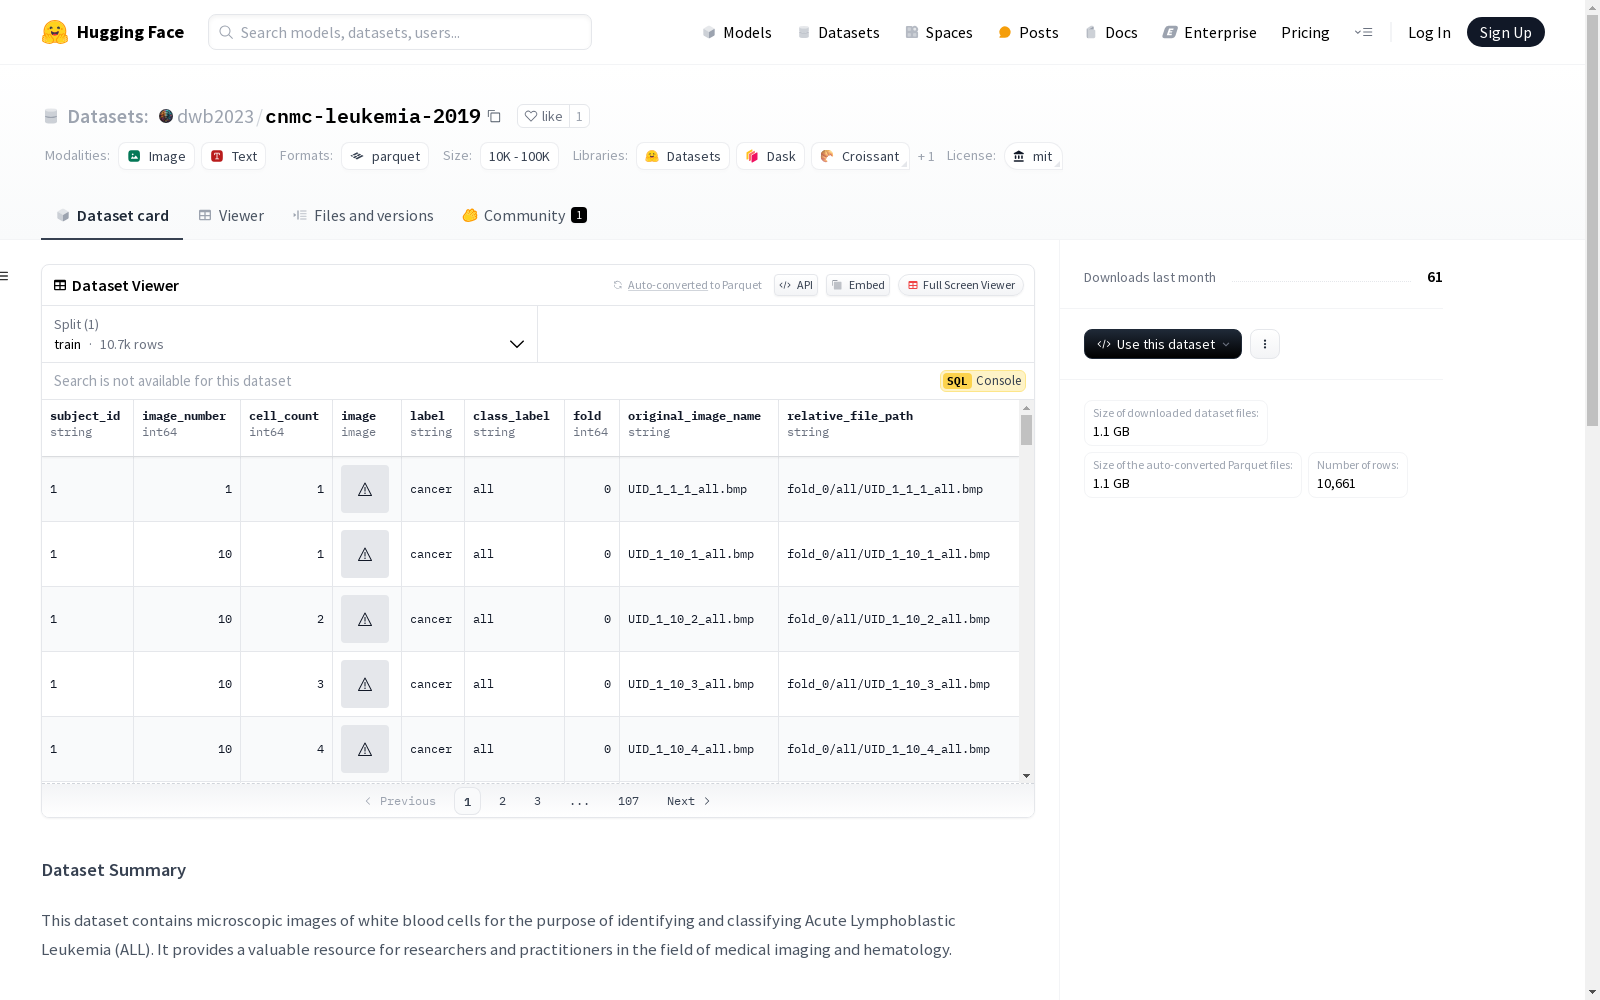
该数据集包含用于识别和分类急性淋巴细胞白血病(ALL)的白细胞显微图像。数据集提供了每个患者的唯一标识符、图像编号、细胞数量、图像数据、标签(癌症/正常)、交叉验证折叠分配、原始图像名称和相对文件路径。数据集适用于图像分类、对象检测和分割等机器学习任务。数据集只有一个训练集分割,包含10,661张图像。

This dataset contains microscopic images of white blood cells used for the identification and classification of acute lymphoblastic leukemia (ALL). It provides each patient's unique identifier, image ID, number of cells, image data, label (cancerous/normal), cross-validation fold assignment, original image name, and relative file path. This dataset is suitable for machine learning tasks such as image classification, object detection, and segmentation. There is only one training set split in this dataset, which contains 10,661 images.

创建时间:
2024-06-30
原始信息汇总

数据集概述

该数据集包含用于识别和分类急性淋巴细胞白血病(ALL)的白细胞显微图像。它为医学影像和血液学领域的研究人员和从业者提供了宝贵的资源。

数据字段

字段名称 数据类型 描述 示例值 用途
subject_id 字符串 每个患者的唯一标识符 "1", "H24" 患者级别分组、分析
image_number 整数 同一患者图像的顺序编号 1, 10, 22 图像排序、跟踪
cell_count 整数 图像中的细胞数量 1, 2, 12 分析/建模特征
image 图像 血液细胞的显微图像 (二进制图像数据) 图像分析输入
label 字符串 简单标签(癌症/正常) "cancer", "healthy" 分类目标变量
class_label 字符串 label的别名 "all", "hem" label的同义词
fold 整数 交叉验证折叠分配 0, 1, 2 模型训练/评估
original_image_name 字符串 图像的原始文件名 "UID_1_1_1_all.bmp" 源数据引用
relative_file_path 字符串 相对于数据集根目录的图像路径 "fold_0/all/UID_1_1_1_all.bmp" 定位图像文件

支持的任务和排行榜

该数据集适用于多种机器学习任务,包括:

  • 图像分类: 区分ALL和健康(HEM)细胞。
  • 对象检测: 定位并计数图像中的单个细胞。
  • 分割: 描绘图像中单个细胞的边界。

ISBI 2019 ALL挑战赛提供了一个排行榜,用于在分类任务上基准性能。

数据分割

数据集作为一个单独的分割(train)提供,包含所有10,661张图像。鼓励研究人员创建自己的验证和测试分割,或利用预定义的折叠进行交叉验证实验。

数据引用

Mourya, S., Kant, S., Kumar, P., Gupta, A., & Gupta, R. (2019). ALL Challenge dataset of ISBI 2019 (C-NMC 2019) (Version 1) [dataset]. The Cancer Imaging Archive. https://doi.org/10.7937/tcia.2019.dc64i46r
搜集汇总
数据集介绍
cnmc-leukemia-2019 数据集图片
构建方式
cnmc-leukemia-2019数据集的构建基于显微镜下的白细胞图像,旨在识别和分类急性淋巴细胞白血病(ALL)。该数据集通过采集患者的血液样本,利用显微镜成像技术获取高分辨率的细胞图像,并结合临床诊断结果进行标注。每张图像均包含独特的患者标识符、细胞数量、图像编号以及分类标签,确保数据的完整性和可追溯性。数据集的构建过程严格遵循医学影像数据的标准化流程,确保其适用于机器学习模型的训练与评估。
特点
cnmc-leukemia-2019数据集的特点在于其丰富的图像数据与详尽的标注信息。数据集包含10,661张显微镜图像,每张图像均标注了细胞数量、分类标签(如‘cancer’或‘healthy’)以及交叉验证的折叠信息。此外,数据集还提供了原始图像的文件路径和名称,便于研究者追溯数据来源。图像数据以二进制格式存储,适用于深度学习模型的输入。该数据集特别适合用于图像分类、目标检测和细胞分割等任务,为医学影像分析提供了高质量的研究资源。
使用方法
cnmc-leukemia-2019数据集的使用方法灵活多样,研究者可根据具体任务需求选择不同的应用方式。对于图像分类任务,可直接利用‘label’或‘class_label’字段作为目标变量,训练模型区分ALL与健康细胞。对于目标检测和分割任务,可通过‘cell_count’字段和图像数据定位并分析单个细胞。数据集未提供预定义的验证集和测试集,研究者需自行划分或利用‘fold’字段进行交叉验证实验。此外,数据集支持通过‘relative_file_path’字段快速定位图像文件,便于数据加载与处理。
背景与挑战
背景概述
cnmc-leukemia-2019数据集由Mourya等人于2019年发布,旨在为急性淋巴细胞白血病(ALL)的识别与分类提供高质量的显微图像资源。该数据集由The Cancer Imaging Archive(TCIA)托管,包含了10,661张白细胞显微图像,涵盖了癌症与健康细胞的标注信息。该数据集的发布为医学影像学和血液学领域的研究者提供了重要的实验数据,推动了基于机器学习的白血病诊断技术的发展。其核心研究问题在于通过图像分类、目标检测和分割等任务,提升ALL的自动化诊断精度。该数据集在ISBI 2019 ALL挑战赛中得到了广泛应用,成为相关领域的重要基准。
当前挑战
cnmc-leukemia-2019数据集在解决急性淋巴细胞白血病(ALL)的自动化诊断问题时,面临多重挑战。首先,显微图像中细胞形态的多样性和复杂性使得分类任务极具挑战性,尤其是在区分癌细胞与健康细胞时,细微的形态差异可能导致误判。其次,数据集中细胞数量的不平衡性可能影响模型的泛化能力,需通过数据增强或重采样技术加以解决。在构建过程中,研究人员需处理大量高分辨率图像,这对数据存储、预处理和标注提出了较高的技术要求。此外,确保数据标注的准确性和一致性也是构建高质量数据集的关键挑战之一。
常用场景
经典使用场景
cnmc-leukemia-2019数据集在医学影像和血液学领域具有重要应用,尤其是在急性淋巴细胞白血病(ALL)的识别和分类任务中。该数据集通过提供大量显微镜下的白细胞图像,为研究人员和从业者提供了一个宝贵的资源,用于开发和验证机器学习模型。这些模型能够自动区分癌细胞和正常细胞,从而辅助医生进行更准确的诊断。
解决学术问题
cnmc-leukemia-2019数据集解决了医学影像分析中的关键问题,特别是在急性淋巴细胞白血病的自动化诊断方面。通过提供高质量的图像数据和详细的标注信息,该数据集为研究人员提供了一个标准化的基准,用于评估和比较不同算法的性能。这不仅推动了图像分类、目标检测和分割技术的发展,还为医学影像领域的深度学习模型提供了重要的训练数据。
衍生相关工作
cnmc-leukemia-2019数据集自发布以来,已经衍生出多项经典研究工作。例如,ISBI 2019 ALL Challenge利用该数据集进行了图像分类任务的基准测试,吸引了全球众多研究团队的参与。此外,许多基于该数据集的深度学习模型在医学影像分析领域取得了显著进展,特别是在细胞检测和分割任务中。这些研究不仅推动了白血病诊断技术的发展,还为其他类型的癌症诊断提供了宝贵的经验。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

