
遇见数据集

ghananlpcommunity/ghana-named-entities-tts-twi

收藏
Hugging Face2026-06-02 更新2026-06-14 收录
官方服务:

资源简介:

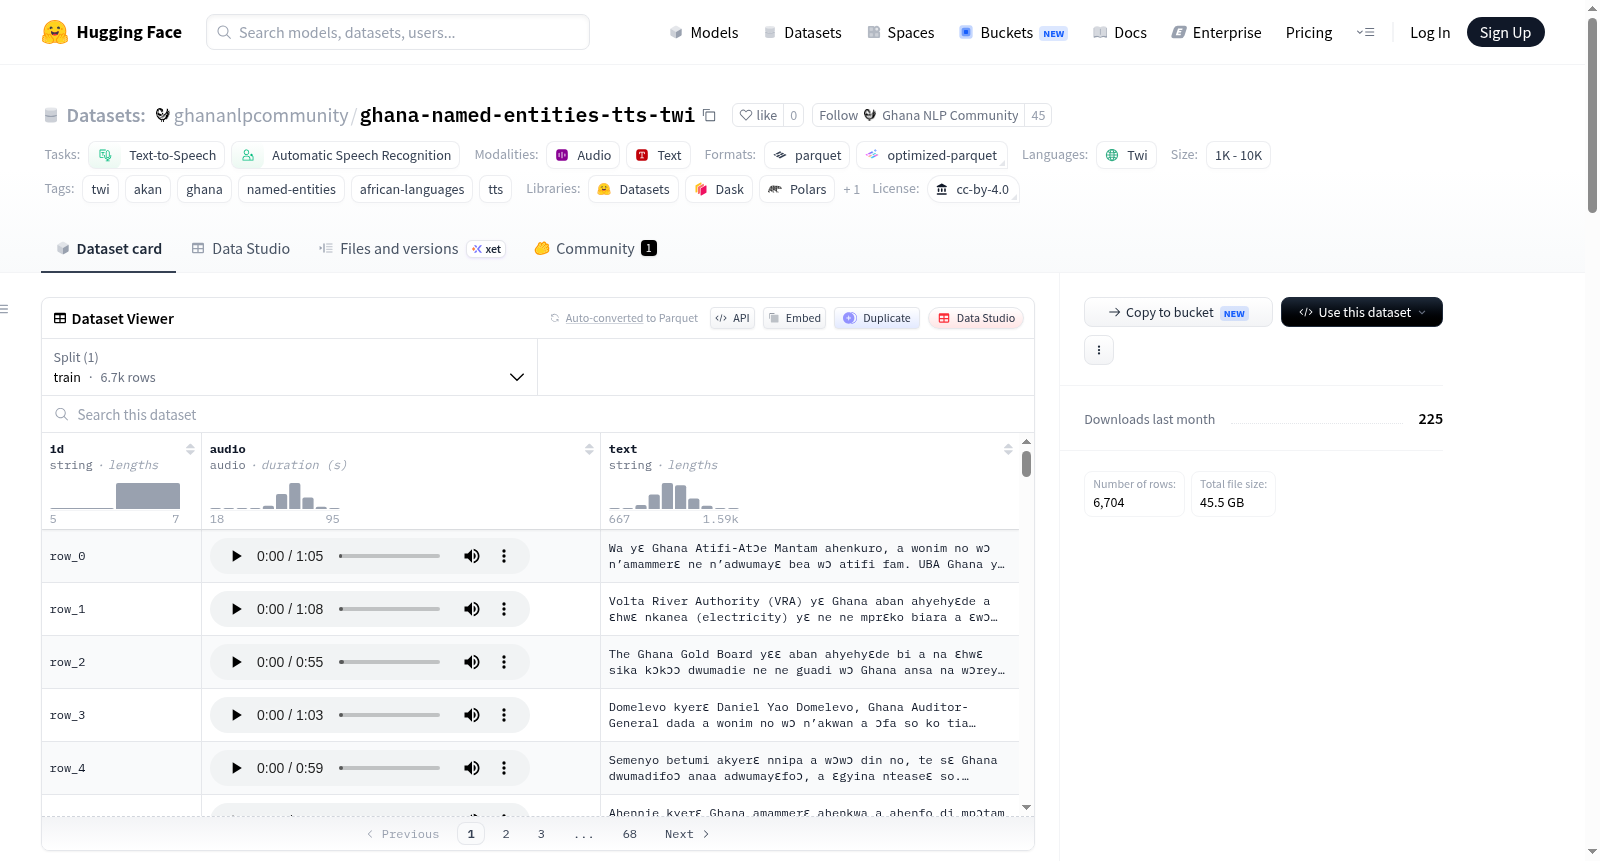
Ghana Named Entities TTS — Twi 是一个Twi语(加纳阿坎语方言)的语音合成数据集,内容基于加纳命名实体(人物、地点、组织、概念)的描述文本。每个音频片段是描述多个命名实体的段落的合成朗读。数据集包含6,704个样本,音频格式为24kHz单声道WAV,采用女性青年成人中等音高的合成语音生成。数据集构建流程包括四个步骤:首先从GhanaNLP社区收集约253,000个加纳命名实体及其英文描述;然后将英文描述按每组10个实体分块组合成段落;接着使用Gemini模型将英文段落翻译成Twi语;最后使用OmniVoice模型将Twi语段落合成为语音。该数据集旨在用于训练和评估Twi语TTS和ASR系统、低资源非洲语言语音研究以及加纳专有名词的发音建模。需要注意的是,音频为合成语音,可能存在韵律和发音方面的TTS伪影;每个片段覆盖多个实体组成的段落而非孤立话语;翻译为自动化处理,部分Twi语表达可能不够地道。

Ghana Named Entities TTS — Twi is a Twi-language speech dataset built from descriptions of Ghana named entities (people, places, organisations, and concepts). Each audio clip is a synthesised reading of a passage that describes several named entities. The dataset contains 6,704 examples in WAV format at 24,000 Hz mono, generated with a synthetic female young adult voice at moderate pitch. The dataset was created through a four-step pipeline: source collection of ~253,000 Ghana named entities with English descriptions from GhanaNLP Community; chunking English descriptions into passages of 10 entities each; translation of passages into Twi using Gemini model; and speech synthesis of Twi passages using OmniVoice model. The dataset is intended for training and evaluating Twi TTS and ASR systems, low-resource African-language speech research, and named-entity pronunciation modelling for Ghanaian proper nouns. Limitations include: audio is synthetic and may contain TTS artefacts; each clip covers multiple entities concatenated into a passage; translation was automated and some Twi renderings may not be idiomatic.
提供机构:
ghananlpcommunity
搜集汇总
数据集介绍
ghananlpcommunity/ghana-named-entities-tts-twi 数据集图片
构建方式
该数据集基于一个包含约25.3万条加纳命名实体(涵盖人物、地点、组织及概念)及其英文描述的语料库构建而成。构建流程分为四个阶段:首先,将英文描述按每组10个实体进行分组整合,形成段落化的文本块;随后,借助Gemini模型(gemini-3.1-flash-lite-preview,思考层级设为HIGH)将这些段落翻译为契维语;最后,利用OmniVoice语音合成系统(采用女性年轻成人口音、中等音高的语音指令,扩散步数为16,引导尺度为2.0)将翻译后的契维语文本转换为24kHz单声道WAV音频,共生成6704条语音样本。
特点
本数据集是专为低资源非洲语言语音研究设计的合成语音资源,聚焦加纳命名实体的语音建模。其语音由合成系统生成,虽在韵律和发音上可能留有TTS伪影,但确保了数据规模与一致性。每条音频对应一个包含多个命名实体的段落,而非孤立词语,这有助于模型学习实体间的上下文关联。数据集仅包含单个训练划分,音频格式为24kHz单声道WAV,文本列提供与音频严格对齐的契维语转录。
使用方法
用户可通过Hugging Face的datasets库便捷加载数据:使用load_dataset函数指定数据集名称和划分(split='train')即可获取迭代器,每条样本包含唯一标识符、24kHz的音频数组及对应文本。该数据集适用于契维语文本转语音系统的训练与评估,亦可作为自动语音识别任务的训练数据,尤其适合加纳命名实体发音建模及低资源非洲语言语音研究场景。
背景与挑战
背景概述
加纳是西非语言多样性极为丰富的国家,其官方语言英语与本土语言如契维语(Twi)共存,而契维语作为阿坎语族的重要分支,其语音资源在自然语言处理领域长期处于匮乏状态。为填补这一空白,GhanaNLP社区于2024年构建了名为“Ghana Named Entities TTS — Twi”的数据集,旨在为契维语的文本转语音(TTS)与自动语音识别(ASR)研究提供基础资源。该数据集聚焦于加纳特有专有名词(如人物、地点、组织等),通过将约25.3万个加纳实体描述的英文语块分组、翻译为契维语,并利用OmniVoice语音合成技术生成6704条音频样本,每条对应若干实体描述。这一工作不仅为低资源非洲语言研究提供了珍贵的标注数据,更搭建了面向专有名词发音建模的桥梁,对推动加纳乃至西非语言技术发展具有开创性意义。
当前挑战
该数据集在领域问题与构建过程中面临多重挑战。在领域问题层面,契维语等低资源非洲语言缺乏大规模、高质量的语音与文本对齐数据,现有TTS与ASR系统多基于通用语音,难以准确处理加纳特有的专有名词发音细节,导致音素层面的错误频发。同时,专有名词的合成阅读涉及语块拼接,易破坏自然韵律与连读规则。在构建过程中,自动化翻译借助Gemini大语言模型完成,虽提高了效率,但机器翻译的语义偏差可能使契维语表达不够地道,且大量实体集中描述式的语音合成,难以泛化至孤立词汇的声学特征建模。此外,合成语音的声学伪影、语速单调性等问题,均对下游系统的鲁棒性提出了严峻考验。
常用场景
经典使用场景
在低资源非洲语言语音研究领域,该数据集的核心应用场景聚焦于文本转语音与自动语音识别系统的训练与评估。凭借其涵盖加纳专有名词、机构名称及概念描述的6,704条合成语音片段,它为Twi语言的语音合成与识别模型提供了稀缺的标注数据资源。研究者可利用该数据集训练能够准确发音加纳人名、地名及组织名称的语音生成模型,或开发针对西非地区特定命名实体的语音识别系统,从而弥合主流语音技术与非洲语言之间的鸿沟。
解决学术问题
该数据集精准回应了非洲低资源语言在自然语言处理领域面临的学术困境——专有名词发音建模与语音数据匮乏的双重挑战。通过系统化收集约25.3万条加纳命名实体及其英文描述,并经过文本分块、机器翻译与语音合成流水线处理,它首次为Twi语言建立了大规模、结构化的命名实体语音数据集。这为研究多实体连续语音中的韵律建模、跨语言专有名词音译、以及合成语音的自然度评估等学术问题提供了标准化实验平台,有力推动了非洲语言语音技术的理论探索与方法创新。
衍生相关工作
该数据集衍生出了一系列具有影响力的相关研究工作:一方面,它催生了针对Twi语言合成语音质量评估的基准测试集与感知实验范式,研究者据此对比不同语音合成引擎在非洲语言上的表现差异;另一方面,基于该数据集训练的ASR模型被迁移至加纳其他方言的语音识别任务,验证了多语言表征学习的跨语言泛化能力。此外,该数据集所采用的'描述文本分块—机器翻译—语音合成'自动化流水线,已成为低资源语言语音数据构建的参考范式,被后续研究借鉴至祖鲁语、斯瓦希里语等非洲语言的类似数据集开发工作中。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

