clinical-trials-drug-approvals-dataset
收藏资源简介:
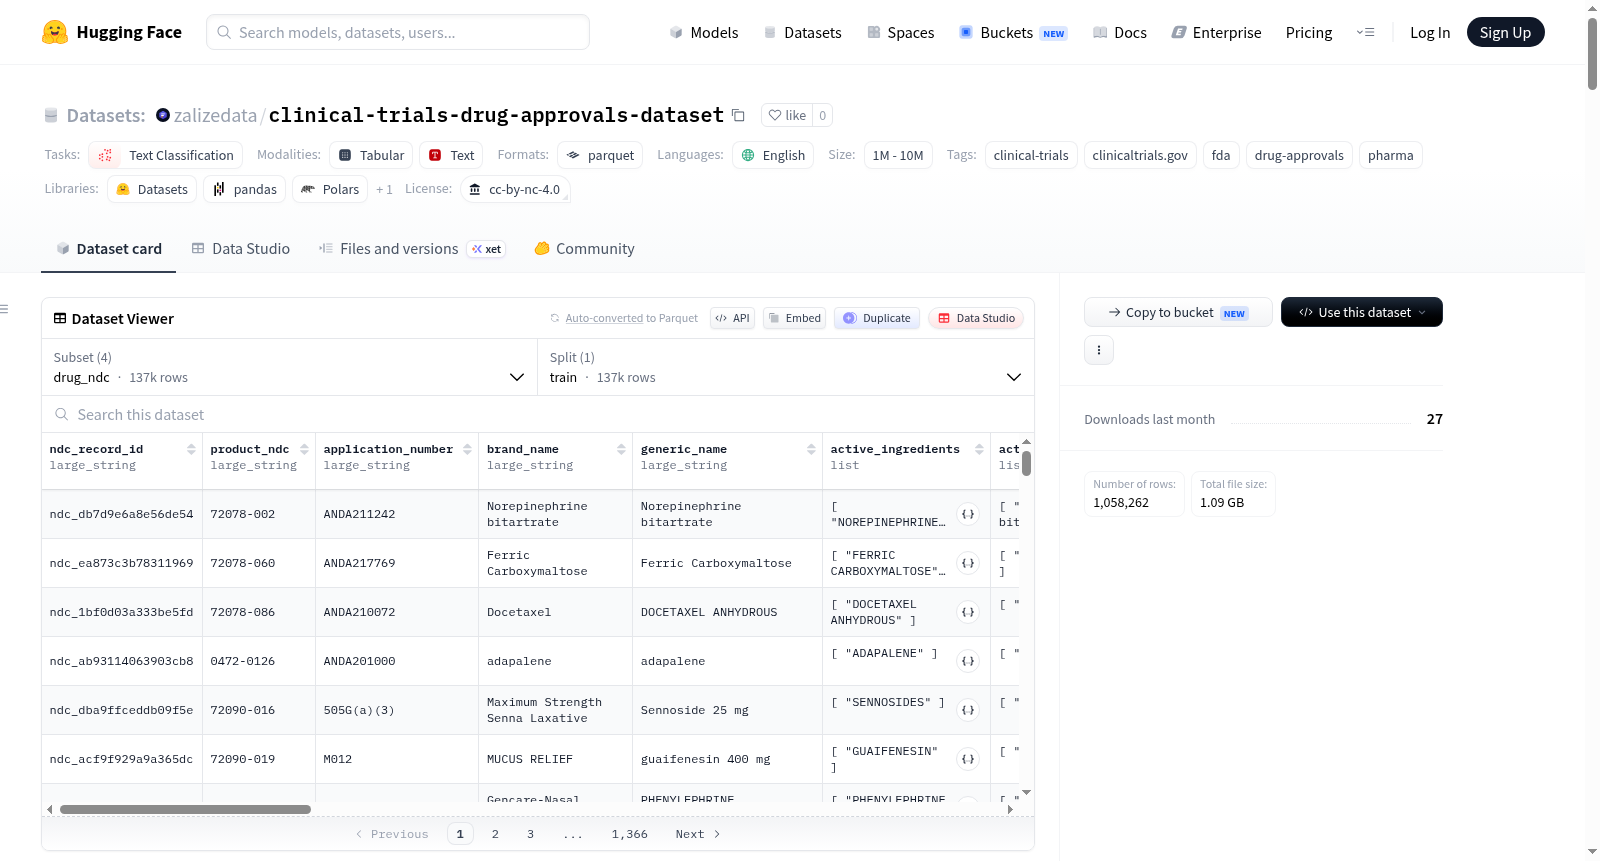
该数据集汇集了来自ClinicalTrials.gov和FDA官方数据源的临床试验与药物批准信息,由DataForge开源数据计划提供。数据集包含四个子表: - trials(临床试验):635,666条记录,涵盖试验ID、注册机构、标题、阶段、状态、条件、干预措施、赞助商、入组人数、日期、地点等字段。 - drug_ndc(国家药品编码):136,520条记录,包含产品NDC、品牌名、通用名、活性成分、剂型、营销类别、标签商等信息。 - drug_products(药品产品):51,593条记录,包括FDA申请号、品牌名、通用名、活性成分、剂型、批准类型、橙皮书状态、专利及独占期信息。 - pipeline_view(管线视图):234,483条记录,按赞助商、条件、阶段汇总的临床试验统计视图,包含试验数量、活跃/完成/中止试验数、药物、注册机构、总入组人数、国家等。 数据规模:S包(635,666行)和M包(1,058,262行),M包将临床试验与FDA批准数据关联。适用任务包括管线与竞争对手情报分析、试验选址与入组研究、监管分析、生物技术投资研究。数据以Parquet格式提供,可通过Hugging Face Datasets库加载,支持四个配置选项。许可证为CC BY-NC 4.0(学术/个人使用),商业使用需获得DataForge商业许可。
This dataset aggregates clinical trial and drug approval information from ClinicalTrials.gov and official FDA data sources, provided by the DataForge Open Data Initiative. It includes four sub-tables: - trials: 635,666 records covering trial ID, registry, title, phase, status, conditions, interventions, sponsors, enrollment, dates, locations, etc. - drug_ndc: 136,520 records containing product NDC, brand name, generic name, active ingredients, dosage form, marketing category, labeler, etc. - drug_products: 51,593 records including FDA application number, brand name, generic name, active ingredients, dosage form, approval type, Orange Book status, patent and exclusivity information. - pipeline_view: 234,483 records summarizing clinical trial statistics by sponsor, condition, and phase, including trial count, active/completed/terminated trials, drugs, registry, total enrollment, countries, etc. Data sizes: S package (635,666 rows) and M package (1,058,262 rows), with the M package linking clinical trials to FDA approval data. Applicable tasks include pipeline and competitive intelligence analysis, trial site selection and enrollment research, regulatory analysis, and biotech investment research. Data is provided in Parquet format, loadable via the Hugging Face Datasets library, supporting four configuration options. License: CC BY-NC 4.0 (academic/personal use); commercial use requires a DataForge commercial license.
临床试验与药物审批数据集(Clinical Trials & Drug Approvals)
数据集概述
该数据集整合了 635K+ 条注册临床试验记录(包含申办方、病症和干预措施)以及 1.06M 行药物智能数据包,将临床试验与 FDA 药物审批信息关联起来。数据集由 DataForge 开放数据计划提供,适用于学术和个人用途。
数据表结构与规模
| 配置名称 | 行数 | 内容简介 |
|---|---|---|
trials |
635,666 | 临床试验核心数据,含 NCT/EU CT/ISRCTN 编号、申办方、阶段、病症、干预措施、试验状态、地理位置等 |
drug_products |
51,593 | FDA 药物产品信息,含申请号、品牌名、活性成分、审批日期、专利信息、橙皮书状态等 |
drug_ndc |
136,520 | 国家药品代码(NDC)层面的药物信息,含标签商、营销类别、RxNorm 和 UNII 标识符等 |
pipeline_view |
234,483 | 管线汇总视图,按申办方集团 × 病症 × 试验阶段聚合,含试验计数、国家分布、催化日期等 |
关键字段说明
trials 表核心字段
- trial_id / registry:试验注册号和来源注册库(CTGOV / EU_CTIS / ISRCTN)
- phase / phases:规范化后的最高试验阶段
- overall_status / status_group:统一枚举的试验状态及粗粒度分组(计划/进行中/已完成/中止/未知)
- lead_sponsor_group / lead_sponsor_class:申办方归一的集团名称和类别(行业/学术/政府/其他)
- conditions / intervention_names:注册病症和干预措施名称,含 MeSH 术语映射
- drug_names_normalized:标准化为活性成分/INN 的药物干预名称
- enrollment_count / location_country_count:入组人数和涉及国家数
drug_products 表核心字段
- application_number:FDA 申请号(NDA/ANDA/BLA)
- is_generic / is_biologic:仿制药/生物药标记
- first_approval_date / latest_approval_date:最早/最近审批日期
- patent_count / patent_numbers:橙皮书专利数量及编号
- loss_of_exclusivity_date:预估独占权丧失日期(取专利到期与独占权结束的最大值)
应用场景
- 管线与竞争情报分析
- 试验点选择与入组研究
- 监管分析
- 生物技术投资研究
数据来源与方法
数据来源于 ClinicalTrials.gov 和 FDA 官方数据集,以 Parquet 格式存储,每个数据包内含数据字典、数据表说明和质量评估报告。
许可协议
采用双重许可:
- 学术/个人用途:CC BY-NC 4.0,需注明来源并回链至 data.zalize.com
- 商业用途:需获得 DataForge 商业许可
- 上游数据(ClinicalTrials.gov 和 FDA 公共数据)的许可条款继续适用
引用方式
text DataForge (data.zalize.com), built from ClinicalTrials.gov and FDA public data — https://data.zalize.com/datasets/clinical-trials-drug-approvals-dataset
DOI(Zenodo 镜像):10.5281/zenodo.21812647