Finnish-NLP/gsm8k-translated_fi
收藏资源简介:
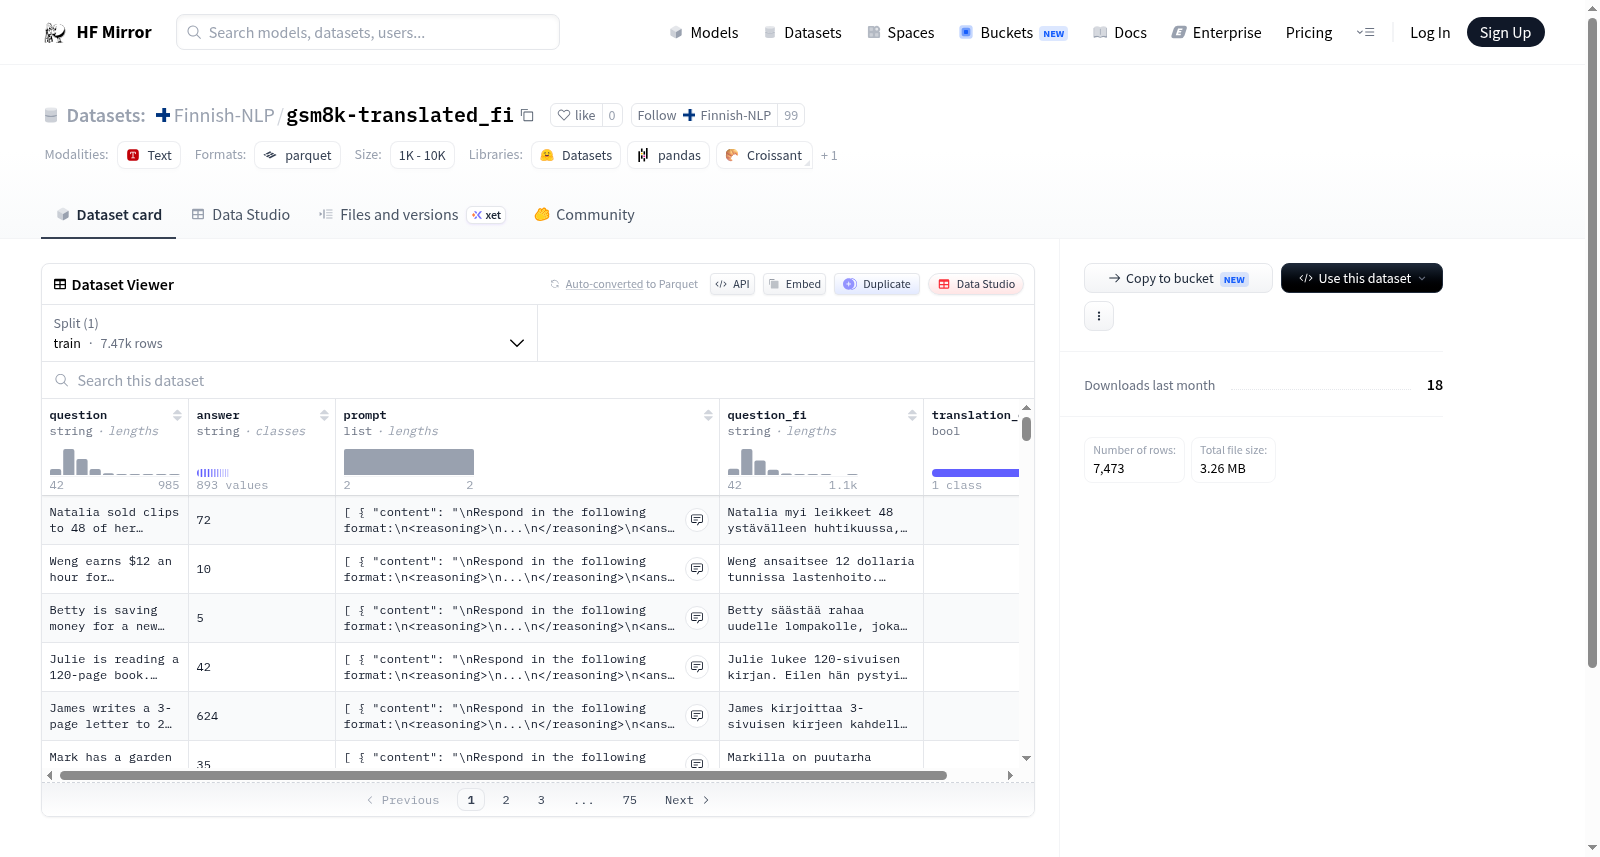
--- dataset_info: features: - name: question dtype: string - name: answer dtype: string - name: prompt list: - name: content dtype: string - name: role dtype: string - name: question_fi dtype: string - name: translation_error dtype: bool splits: - name: train num_bytes: 6426852 num_examples: 7473 download_size: 3261633 dataset_size: 6426852 configs: - config_name: default data_files: - split: train path: data/train-* ---
The dataset includes fields for questions, answers, prompts (including content and role), question correction, and translation errors. It is split into a training set, which contains 7473 examples with a file size of 6426852 bytes. The dataset is primarily used for text processing and machine translation tasks, but no detailed dataset description is provided.