Turnstile-Synthetic-Domains
收藏资源简介:
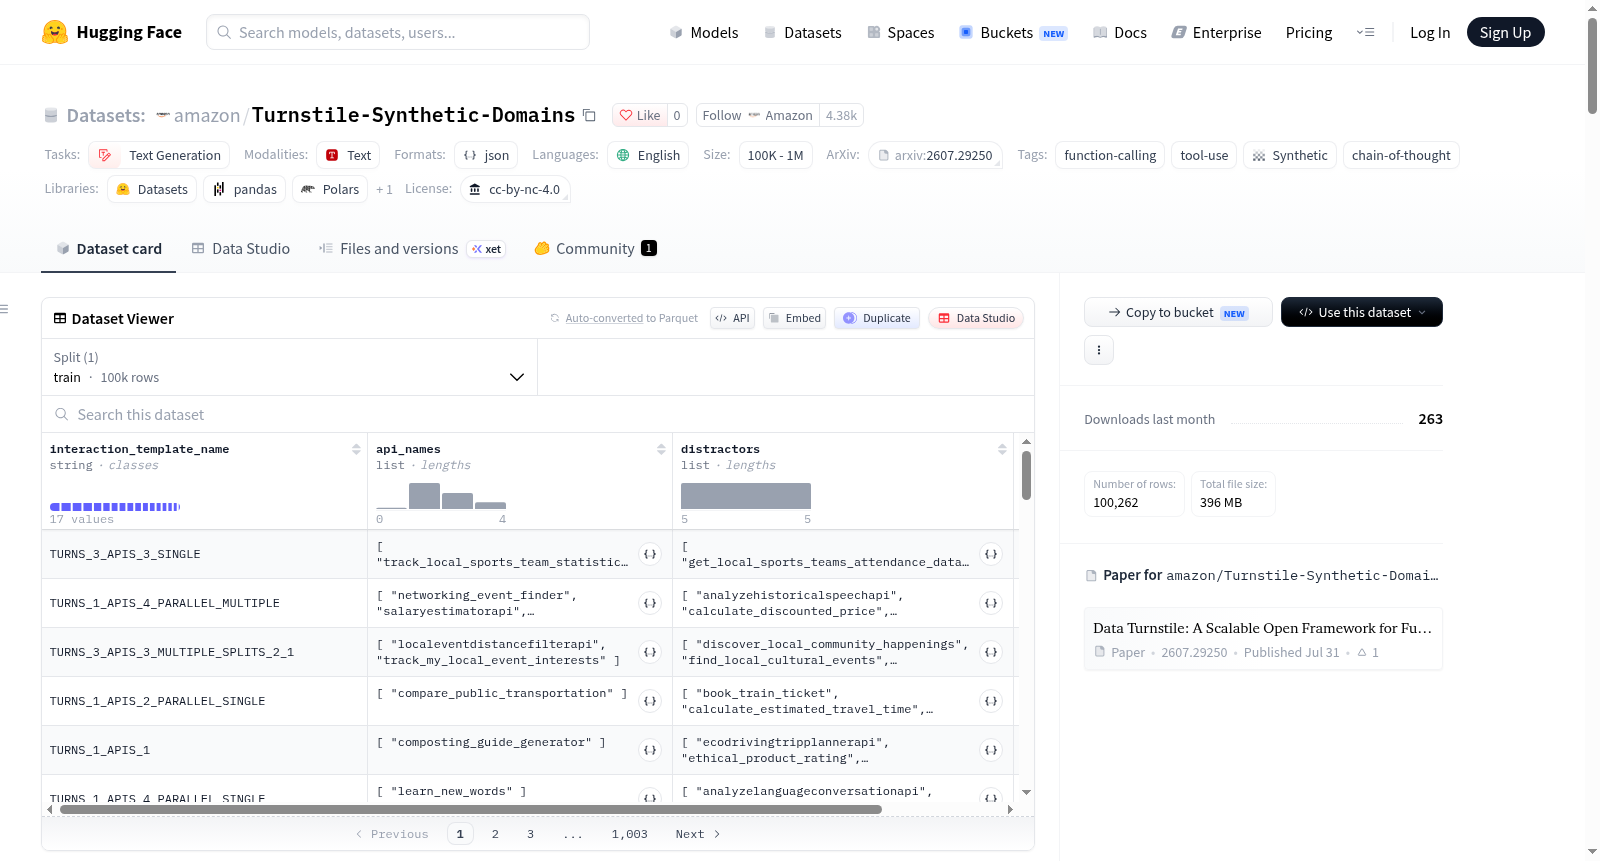
Data Turnstile — Synthetic Domains 是一个大规模合成函数调用数据集,包含链式思维推理轨迹,专为训练小语言模型在工具使用任务上设计。数据集包含100,262个交互,每个交互由角色序列组成,覆盖1,025个唯一API,每个交互含有5个干扰API,并采用17种模板类型来模拟不同的交互结构。平均每个交互包含约10个角色和约972个token,所有内容为英文。数据由Qwen2.5-32B-Instruct通过Data Turnstile框架生成,该框架采用逐角色分解、结构验证、验证-再生成和重试机制确保质量。数据集包含两个文件:data.jsonl和api_definitions.json。每个交互的字段包括:interaction_template_name、api_names、distractors、interaction。角色包括:SYSTEM、USER、THINKING、API_CALL、API_OBS、ASST。该数据集适用于训练模型进行函数调用和工具选择,支持带或不带链式思维(CoT)的训练模式。实验中,在Qwen3-0.6B上微调该数据集(不含CoT)在Berkeley Function Calling Leaderboard (BFCL v3) 单轮基准上总体准确率从58.2%提升至67.4%(+9.2个百分点)。数据集的限制包括:API定义为合成、交互为LLM生成、API响应为模拟、仅英文、存在教师模型偏差。伦理方面:所有姓名、邮箱、电话、地址均为合成,API定义已过滤不适内容,许可证为CC-BY-NC-4.0。
Data Turnstile — Synthetic Domains is a large-scale synthetic function calling dataset with chain-of-thought reasoning trajectories, designed for training small language models on tool-use tasks. The dataset contains 100,262 interactions, each consisting of a sequence of roles, covering 1,025 unique APIs, with 5 distractors per interaction, and 17 template types to simulate different interaction structures. On average, each interaction has about 10 roles and 972 tokens, all in English. The data was generated by Qwen2.5-32B-Instruct using the Data Turnstile framework, which employs role-by-role decomposition, structural validation, verify-regenerate, and retry mechanisms to ensure quality. The dataset includes two files: data.jsonl and api_definitions.json. Fields per interaction include: interaction_template_name, api_names, distractors, and interaction. Roles include: SYSTEM, USER, THINKING, API_CALL, API_OBS, and ASST. The dataset is suitable for training models on function calling and tool selection, supporting training with or without chain-of-thought (CoT). In experiments, fine-tuning Qwen3-0.6B on this dataset (without CoT) improved overall accuracy on the Berkeley Function Calling Leaderboard (BFCL v3) single-turn benchmark from 58.2% to 67.4% (+9.2 percentage points). Limitations include: synthetic API definitions, LLM-generated interactions may not reflect real distributions, simulated API responses, English-only, and bias from the teacher model (Qwen2.5-32B-Instruct). Ethically, all names, emails, phones, addresses are synthetic; API definitions have been filtered for demographics, adult content, weapons, and surveillance; no harmful tool usage; no proprietary data contamination; licensed under CC-BY-NC-4.0.
Data Turnstile — Synthetic Domains 数据集详情
数据集概述
Data Turnstile — Synthetic Domains 是一个大规模合成函数调用(function-calling)交互数据集,包含思维链(chain-of-thought)推理轨迹,专为训练小型语言模型的工具使用(tool-use)能力而设计。
核心统计
| 指标 | 数值 |
|---|---|
| 交互总数 | 100,262 |
| 唯一API数量 | 1,025 |
| 每次交互的干扰项数量 | 5 |
| 模板类型 | 17 |
| 每次交互平均角色数 | ~10 |
| 每次交互平均token数 | ~972 |
| 语言 | 英语 |
| 生成模型 | Qwen2.5-32B-Instruct |
数据集文件
- data.jsonl — 100,262 条交互记录(每行一个JSON对象)
- api_definitions.json — 1,025 个API定义,包含完整参数模式
数据结构与模式
字段说明
| 字段 | 描述 |
|---|---|
interaction_template_name |
描述交互结构的模板类型 |
api_names |
本次交互中实际调用的API列表 |
distractors |
额外5个可用但未使用的API(训练时用于工具选择能力) |
interaction |
有序的角色字典列表 |
角色类型
| 角色 | 描述 |
|---|---|
SYSTEM |
用于交互时间锚定的日期上下文 |
USER |
自然语言用户请求 |
THINKING |
解释API选择和参数映射的思维链推理 |
API_CALL |
Python语法函数调用 |
API_OBS |
模拟的API响应(JSON对象) |
ASST |
面向用户的助手自然语言回复 |
模板类型与分布
单轮(1个用户请求,1-4个API调用):
TURNS_1_APIS_1(8.7%)TURNS_1_APIS_N_PARALLEL_SINGLE系列TURNS_1_APIS_N_PARALLEL_MULTIPLE系列*_SPLITS_X_Y子组拆分变体
多轮(2-3个连续用户请求):
TURNS_2_APIS_2_SINGLE(7.1%)/TURNS_2_APIS_2_MULTIPLE(5.3%)TURNS_3_APIS_3_SINGLE(5.9%)/TURNS_3_APIS_3_MULTIPLE(3.7%)
无关性:
TURNS_1_IRRELEVANCE(2.5%)— 用户请求无法由可用API满足
数据集用途
训练方式
- 含思维链训练:使用包括
THINKING在内的所有角色,训练模型在调用工具前先推理 - 无思维链训练:移除
THINKING角色,进行直接函数调用训练(无推理步骤)
并行调用处理
并行API调用以顺序方式存储(API_CALL → API_OBS → API_CALL → API_OBS),如需分组格式可将连续的API_CALL/API_OBS对合并为单个工具调用轮次。
生成方法论
采用 Data Turnstile 框架生成:
- 角色级分解:每个交互分解为类型化角色的DAG,由教师LLM逐角色生成并验证
- 结构验证:每个角色通过格式检查(JSON解析、API模式符合性、引用一致性)
- 验证后生成:质量门控在继续前检查每个角色的正确性
- 带反馈重试:失败角色在错误上下文中重新生成(最多3次重试)
实验效果
在Qwen3-0.6B上仅使用该数据集微调后,在Berkeley Function Calling Leaderboard (BFCL v3) 单轮基准上:
- 整体准确率从58.2%提升至67.4%(+9.2个百分点)
- 匹配基础模型思考模式的表现,且无思维链推理开销
局限性
- 合成API:API定义为合成生成,非真实服务
- 合成数据:LLM生成,可能无法反映真实使用分布
- 模拟观察:API响应为生成,有时不具代表性
- 仅英文:所有内容均为英语
- 教师偏差:可能继承Qwen2.5-32B-Instruct的模式和偏见
道德考量
- 无真实个人身份信息:所有姓名、邮箱、电话和地址均为合成
- 无攻击性内容:API定义已排除人口统计、成人内容、武器和监控领域
- 无有害工具使用:API不模拟危险或非法活动
- 开源权重生成:使用开源权重模型生成,无专有数据污染
许可证
- 数据集许可证:CC-BY-NC-4.0