marin-qwen36-nemosci-terminus2-b200-parity-artifacts
收藏资源简介:
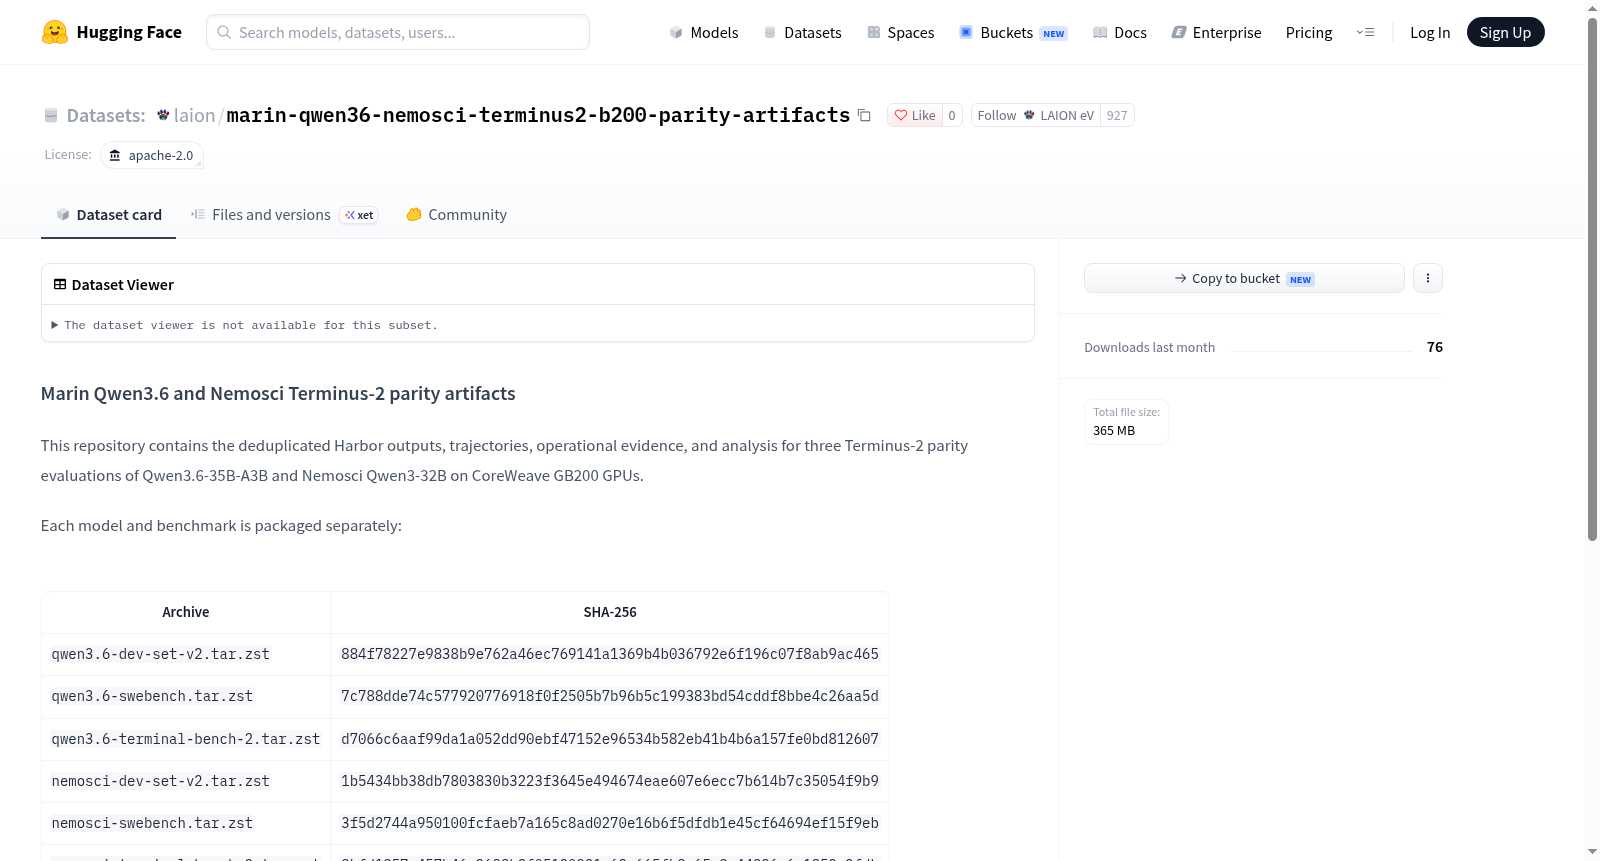
本数据集名为“Marin Qwen3.6 and Nemosci Terminus-2 parity artifacts”,采用Apache-2.0许可证。它包含了Qwen3.6-35B-A3B和Nemosci Qwen3-32B两个模型在CoreWeave GB200 GPU上进行的Terminus-2 parity评估的去重Harbor输出、轨迹、操作证据和分析结果。数据按模型和基准测试分别打包为六个.tar.zst压缩文件,每个文件均提供SHA-256校验和以确保完整性。公开版本已脱敏处理,移除了临时Iris端点能力令牌、基准生成的私钥及类似密钥的基准测试夹具,但保留了试验奖励、异常、配置和轨迹结构。提取压缩文件需使用命令:tar --use-compress-program=unzstd -xf <文件名>.tar.zst。本数据集可用于分析模型在特定硬件上的parity评估结果、复现评估过程或进行进一步的基准测试研究。
This dataset is named "Marin Qwen3.6 and Nemosci Terminus-2 parity artifacts" and is licensed under Apache-2.0. It contains deduplicated Harbor outputs, trajectories, operational evidence, and analysis results of Terminus-2 parity evaluations for two models: Qwen3.6-35B-A3B and Nemosci Qwen3-32B, conducted on CoreWeave GB200 GPUs. The data is packaged into six .tar.zst compressed files, each grouped by model and benchmark, with SHA-256 checksums provided for integrity verification. The public version has been sanitized, removing temporary Iris endpoint capability tokens, private keys generated for benchmarks, and similar key-like benchmark fixtures, while retaining trial rewards, anomalies, configurations, and trajectory structures. To extract the compressed files, use the command: tar --use-compress-program=unzstd -xf <filename>.tar.zst. This dataset can be used to analyze parity evaluation results of models on specific hardware, reproduce the evaluation process, or conduct further benchmark studies.
数据集概述
- 名称: Marin Qwen3.6 与 Nemosci Terminus-2 一致性工件数据集
- 许可证: Apache-2.0
- 来源地址: Hugging Face 数据集页面
内容说明
该数据集包含了在 CoreWeave GB200 GPU 上对 Qwen3.6-35B-A3B 和 Nemosci Qwen3-32B 两个模型进行的三项 Terminus-2 一致性评估的去重 Harbor 输出、轨迹、操作证据和分析结果。
数据组织
数据按模型和基准测试分别打包,共包含 7 个压缩归档文件(.tar.zst 格式),每个归档文件均提供 SHA-256 校验值以确保完整性。具体归档如下:
| 归档文件 | 用途 |
|---|---|
qwen3.6-dev-set-v2.tar.zst |
Qwen3.6 模型的开发集评估结果 |
qwen3.6-swebench.tar.zst |
Qwen3.6 模型的 SWE-bench 评估结果 |
qwen3.6-terminal-bench-2.tar.zst |
Qwen3.6 模型的 Terminal-Bench 2 评估结果 |
nemosci-dev-set-v2.tar.zst |
Nemosci 模型的开发集评估结果 |
nemosci-swebench.tar.zst |
Nemosci 模型的 SWE-bench 评估结果 |
nemosci-terminal-bench-2.tar.zst |
Nemosci 模型的 Terminal-Bench 2 评估结果 |
analysis-and-metadata.tar.zst |
综合分析及元数据 |
使用方法
解压归档文件的命令示例: bash tar --use-compress-program=unzstd -xf qwen3.6-dev-set-v2.tar.zst
内容处理与关联资源
- 公开导出已删除短暂的 Iris 端点能力令牌、基准测试生成的私钥及关键测试文件等敏感信息。
- 保留了试验奖励、异常、配置和轨迹结构等核心评估数据。
- 六个源 Harbor 策略单独发布于关联数据集:laion/marin-qwen36-nemosci-terminus2-b200-parity-configs。