
coat-dataset
收藏官方服务:
资源简介:
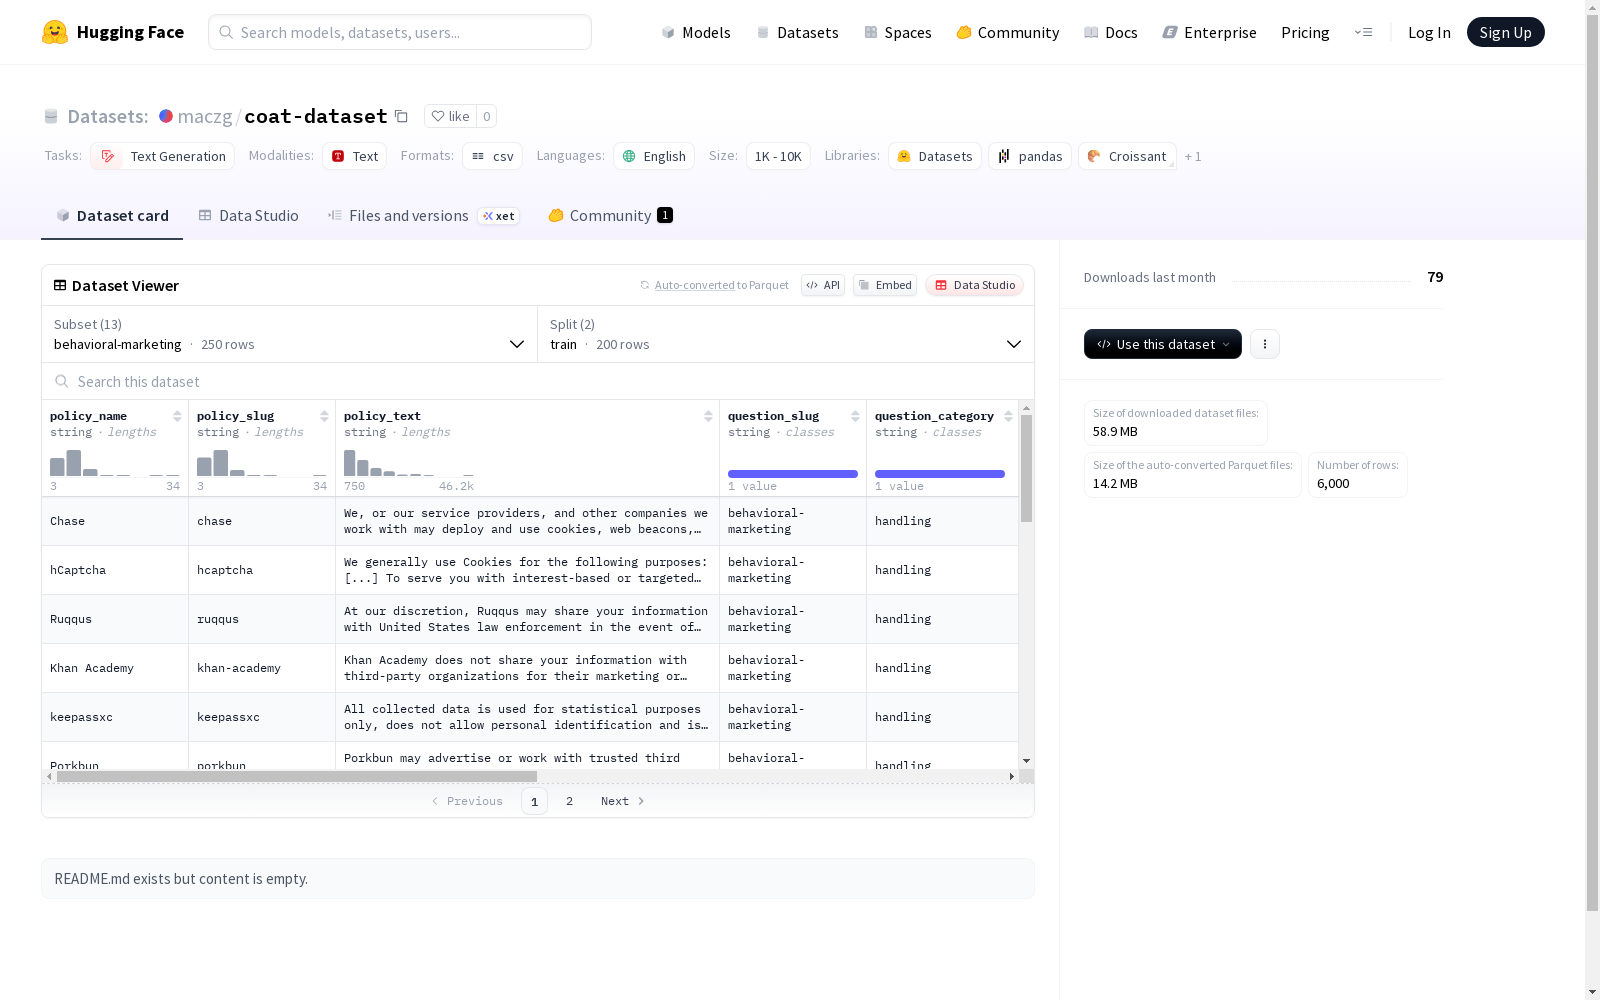
Coats隐私政策数据集包含了关于隐私政策的不同配置的数据,每个配置都有特定的特征和对应的训练及测试数据文件路径。数据集特征涉及政策名称、政策别名、政策文本、问题别名、问题分类、问题文本、问题得分、可用选项以及选定的选项描述、选项键和百分比等信息。这些配置围绕各种隐私相关主题组织。
The Coats Privacy Policy Dataset contains data corresponding to different configurations of privacy policies. Each configuration has specific characteristics, along with the corresponding file paths for training and test data. The features included in the dataset cover policy name, policy alias, policy text, question alias, question category, question text, question score, available options, selected option descriptions, option keys and percentage information. These configurations are structured around various privacy-related topics.
创建时间:
2025-10-16
原始信息汇总
Coats Privacy Policy Dataset 数据集概述
基本信息
- 数据集名称: Coats Privacy Policy Dataset
- 任务类别: 文本生成
- 支持语言: 英语
数据集配置
数据集包含以下13个配置:
完整数据集
- 配置名称: full
- 数据文件: train
行为营销
- 配置名称: behavioral-marketing
- 数据文件: train, test
安全
- 配置名称: security
- 数据文件: train, test
第三方收集
- 配置名称: third-party-collection
- 数据文件: train, test
历史记录
- 配置名称: history
- 数据文件: train, test
数据删除
- 配置名称: data-deletion
- 数据文件: train, test
数据泄露
- 配置名称: data-breaches
- 数据文件: train, test
第三方访问
- 配置名称: third-party-access
- 数据文件: train, test
数据收集原因
- 配置名称: data-collection-reasoning
- 数据文件: train, test
非关键用途
- 配置名称: noncritical-purposes
- 数据文件: train, test
执法部门
- 配置名称: law-enforcement
- 数据文件: train, test
收集列表
- 配置名称: list-collected
- 数据文件: train, test
修订通知
- 配置名称: revision-notify
- 数据文件: train, test
搜集汇总
数据集介绍
构建方式
在隐私政策分析领域,Coats数据集通过系统化的数据采集与标注流程构建而成。该数据集从实际网络隐私政策文档中提取文本内容,按照隐私条款的不同维度进行专业分类,涵盖了行为营销、数据安全、第三方数据收集等核心隐私主题。每个配置都经过严格的数据划分,确保训练集与测试集的独立性,为隐私政策文本生成任务提供了坚实的语料基础。
使用方法
针对隐私政策文本生成的研究需求,该数据集提供了灵活的使用方案。研究者可根据具体研究目标选择完整数据集或特定主题配置进行实验,每个配置都预设了标准的训练测试划分。在自然语言处理应用中,该数据集适用于隐私政策自动生成、条款分类分析等任务,通过加载对应的数据文件路径即可获取经过预处理的结构化文本数据,为隐私政策自动化研究提供了便捷的技术支持。
背景与挑战
背景概述
随着数字隐私保护成为全球性议题,Coats隐私政策数据集应运而生。该数据集由专注于数据治理研究的学术机构构建,聚焦于隐私政策文本的结构化解析与语义理解。其核心价值在于通过多维度分类框架,涵盖行为营销、数据安全、第三方收集等关键隐私领域,为自然语言处理技术在法律文本分析中的应用提供了标准化基准。该资源显著推进了隐私政策自动化评估技术的发展,助力构建透明可信的数字生态系统。
当前挑战
隐私政策文本固有的法律术语复杂性与句式多样性,对机器理解构成首要障碍。数据构建过程中需应对多国法律条款的跨地域差异,以及政策文本频繁更新带来的版本同步难题。标注工作更面临专业法律知识依赖性与主观判断偏差的双重制约,这要求标注者兼具法学素养与语言学知识,从而确保数据标注的准确性与一致性。
常用场景
经典使用场景
在隐私政策分析领域,Coat数据集通过精心标注的隐私政策文本,为自然语言处理模型提供了丰富的训练素材。该数据集特别聚焦于隐私政策中的关键条款识别,涵盖行为营销、数据安全、第三方收集等多个维度,使得研究人员能够构建精准的文本分类和信息提取系统。这些系统能够自动解析复杂的法律文档,识别其中涉及用户数据处理的敏感内容,为后续的隐私保护分析奠定坚实基础。
解决学术问题
该数据集有效解决了隐私政策自动解析中的语义理解难题。传统方法难以准确捕捉法律文本中隐含的数据处理意图和用户权利条款,而Coat数据集通过细粒度的分类标注,为机器学习模型提供了明确的学习目标。这不仅提升了模型对隐私政策关键要素的识别准确率,还推动了法律文本挖掘与自然语言处理交叉领域的方法创新,为构建透明可信的数据治理体系提供了技术支撑。
实际应用
在实际应用层面,Coat数据集支撑的自动化系统正逐步改变企业隐私合规管理的方式。通过训练得到的模型能够快速扫描大量隐私政策文档,识别其中涉及数据删除、安全漏洞、执法访问等关键信息,显著提升了合规审查效率。这些技术还可集成到浏览器插件或移动应用中,帮助普通用户理解复杂的隐私条款,增强个人数据保护意识,促进数字环境中的隐私权实践。
数据集最近研究
最新研究方向
在数字隐私政策分析领域,Coats数据集通过其细分的配置结构推动了自然语言处理技术的深度应用。当前研究聚焦于利用生成式模型解析隐私文本中的法律条款,特别是在行为营销、数据安全与第三方数据共享等热点议题上。随着全球数据保护法规的日益严格,该数据集支撑了自动化合规检测系统的开发,帮助机构快速识别政策漏洞。同时,针对数据泄露通知和执法访问等场景的语义理解研究,正成为保障用户权益的前沿方向,为构建透明化数字生态提供关键技术支撑。
以上内容由遇见数据集搜集并总结生成


