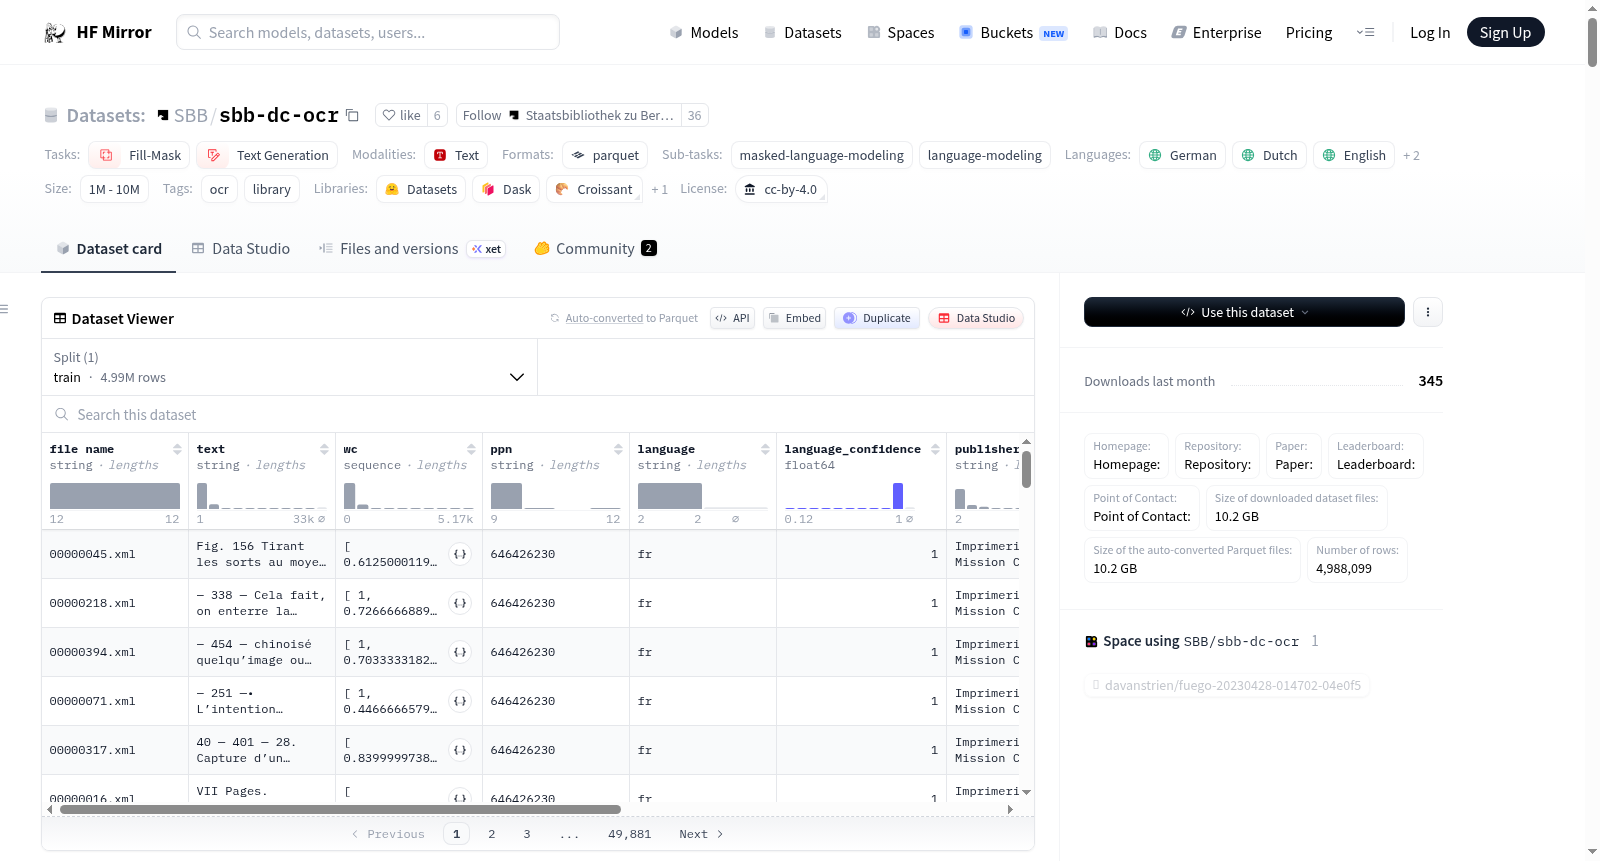
SBB/sbb-dc-ocr
收藏资源简介:
柏林国家图书馆OCR数据集包含了从1470年到1945年期间的153,942份数字化作品。在发布时,已有28,909份作品经过OCR处理,生成了4,988,099页的全文。每页OCR文本的语言通过langid工具进行识别,并包含语言预测的置信度分数。数据集支持的任务包括语言建模和掩码语言建模,适用于训练历史/OCR文本的语言模型。数据集包含多种语言,主要语言为德语、荷兰语、英语、法语和西班牙语。数据集的创建基于柏林国家图书馆数字收藏的OCR全文,并通过一系列数据处理步骤增强其可用性。
The Berlin State Library OCR Dataset contains 153,942 digitized works spanning from 1470 to 1945. At the time of its release, 28,909 of these works had undergone OCR processing, generating full texts across 4,988,099 pages. The language of each page's OCR text was identified using the langid tool, with confidence scores for the language predictions included. The dataset supports tasks including language modeling and masked language modeling, which are suitable for training language models on historical or OCR texts. The dataset covers multiple languages, with German, Dutch, English, French and Spanish as the primary languages. The dataset was developed based on the OCR full texts from the digital collections of the Berlin State Library, and its usability was enhanced through a series of data processing steps.
数据集概述
数据集名称
- 名称: Berlin State Library OCR
- 别名: 柏林州立图书馆OCR数据集
数据集基本信息
- 语言: 多语言(德语、荷兰语、英语、法语、西班牙语等)
- 语言创建方式: 专家生成
- 许可证: Creative Commons Attribution 4.0 International (CC-BY-4.0)
- 多语言支持: 是
- 数据集大小: 1M<n<10M
- 标签: OCR, 图书馆
- 任务类别: 填空, 文本生成
- 任务ID: 掩码语言建模, 语言建模
数据集内容
- 数据实例: 每个实例代表一个OCR处理的文本页。
- 数据字段:
- file name: 原始XML文件名
- text: 该页的OCR文本
- wc: OCR引擎预测的每个令牌的单词置信度
- ppn: 图书馆内部使用的Pica生产编号
- language:
langid.py预测的语言 - language_confidence:
langid.py给出的置信度分数 - 其他: 包括出版商、出版地、日期、标题、作者等元数据信息
数据集创建
- 来源数据: 来自柏林州立图书馆数字收藏的OCR全文
- 数据准备: 使用
dataprep.ipynb脚本处理数据,包括加载CSV文件、添加语言信息和元数据映射 - 注释: 机器生成的注释,包括OCR置信度和语言预测置信度
使用考虑
- 偏见讨论: 由于数据集包含历史材料,文本中可能包含与现代观念不符的观点和态度,使用时需谨慎考虑这些潜在偏见对语言模型的影响。
附加信息
- 数据集创建者: Labusch, Kai; Zellhöfer, David
- 贡献者: @davanstrien
许可证和引用信息
- 许可证: Creative Commons Attribution 4.0 International
- 引用信息: 见README文件中的引用格式
以上信息总结了Berlin State Library OCR数据集的关键特征和使用注意事项,为潜在用户提供了清晰的数据集概览。