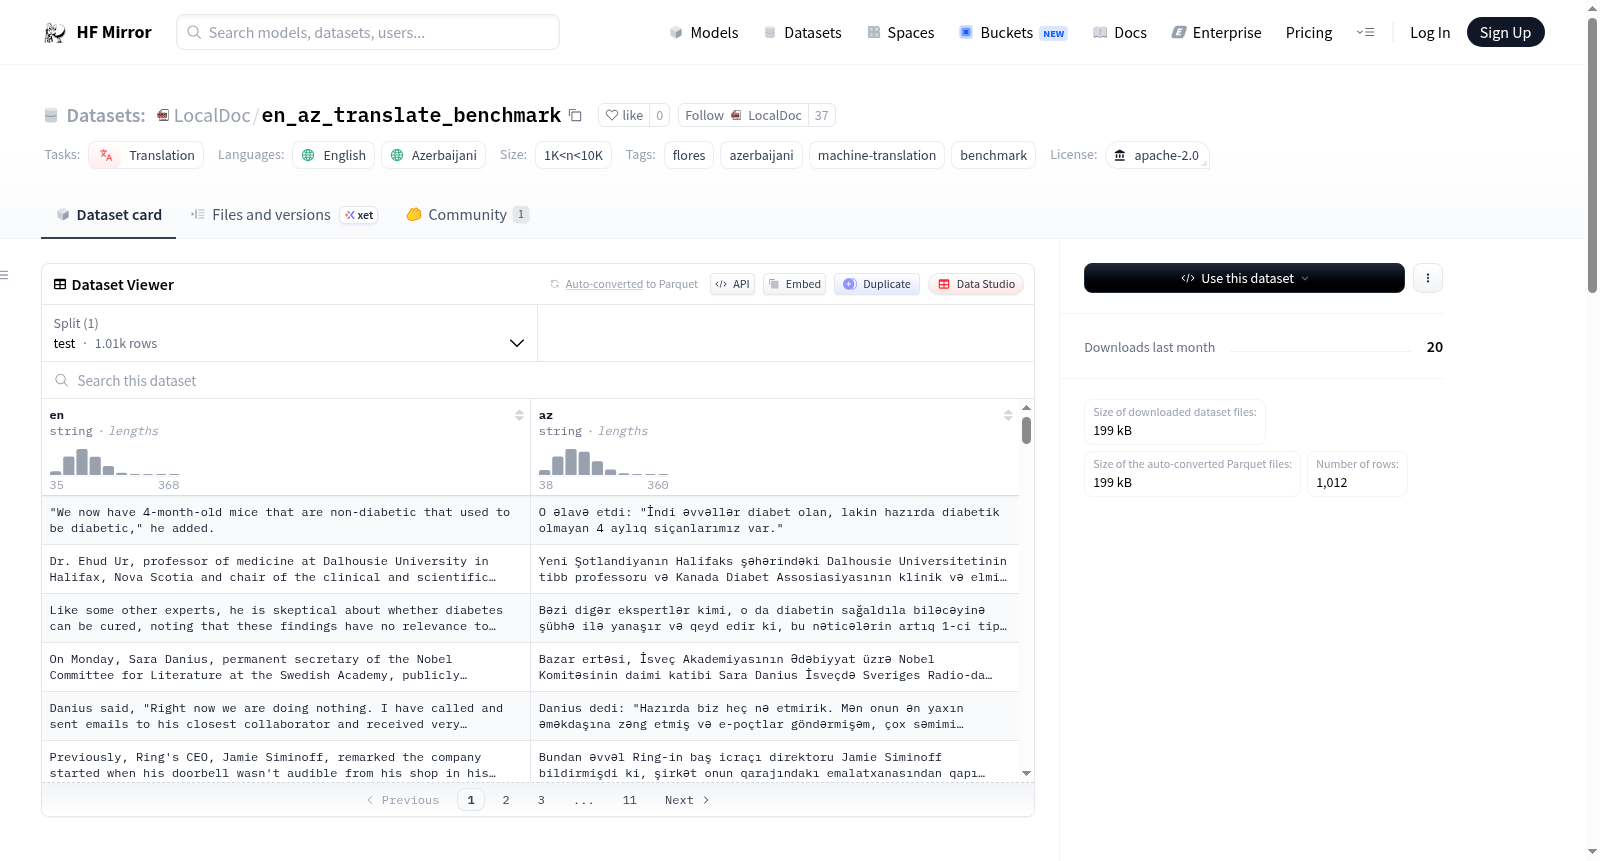
LocalDoc/en_az_translate_benchmark
收藏资源简介:
--- language: - en - az task_categories: - translation size_categories: - 1K<n<10K license: apache-2.0 tags: - flores - azerbaijani - machine-translation - benchmark --- # EN-AZ Translation Benchmark High-quality English-Azerbaijani parallel benchmark for evaluating machine translation systems. ## Overview - **Source**: FLORES-200 devtest English sentences - **Reference translations**: Generated by GPT-5.4 (EN→AZ direction) - **Size**: 1012 sentence pairs - **Purpose**: Evaluation benchmark (NOT for training) ## Why GPT-5.4 references? Original FLORES-200 Azerbaijani references contain systematic errors: - Semantic inaccuracies ("per unit of GDP" translated as "per capita") - Terminology errors ("emissions" → "waste", "the Executive" → "government") - Inconsistencies (same entity translated differently across sentences) GPT-5.4 translations were validated against original FLORES and showed superior semantic accuracy, terminology consistency, and structural clarity. ## Usage ```python from datasets import load_dataset dataset = load_dataset("LocalDoc/en_az_translate_benchmark") test = dataset["test"] # Access pairs for example in test: print(example["en"], "→", example["az"]) ``` ## Intended use This dataset is designed as an **evaluation benchmark** for: - Comparing MT systems (NLLB, Google Translate, custom models) - Computing BLEU, chrF++, COMET scores against high-quality references - Measuring translation quality for EN↔AZ direction ## Columns | Column | Description | |--------|-------------| | `en` | English source sentence (from FLORES-200 devtest) | | `az` | Azerbaijani reference translation (GPT-5.4) | ## Citation Based on FLORES-200 devtest set. Reference translations by GPT-5.4 via OpenRouter API.