voice-pairs-genuineness-vocalburst-blend-human-eval
收藏资源简介:
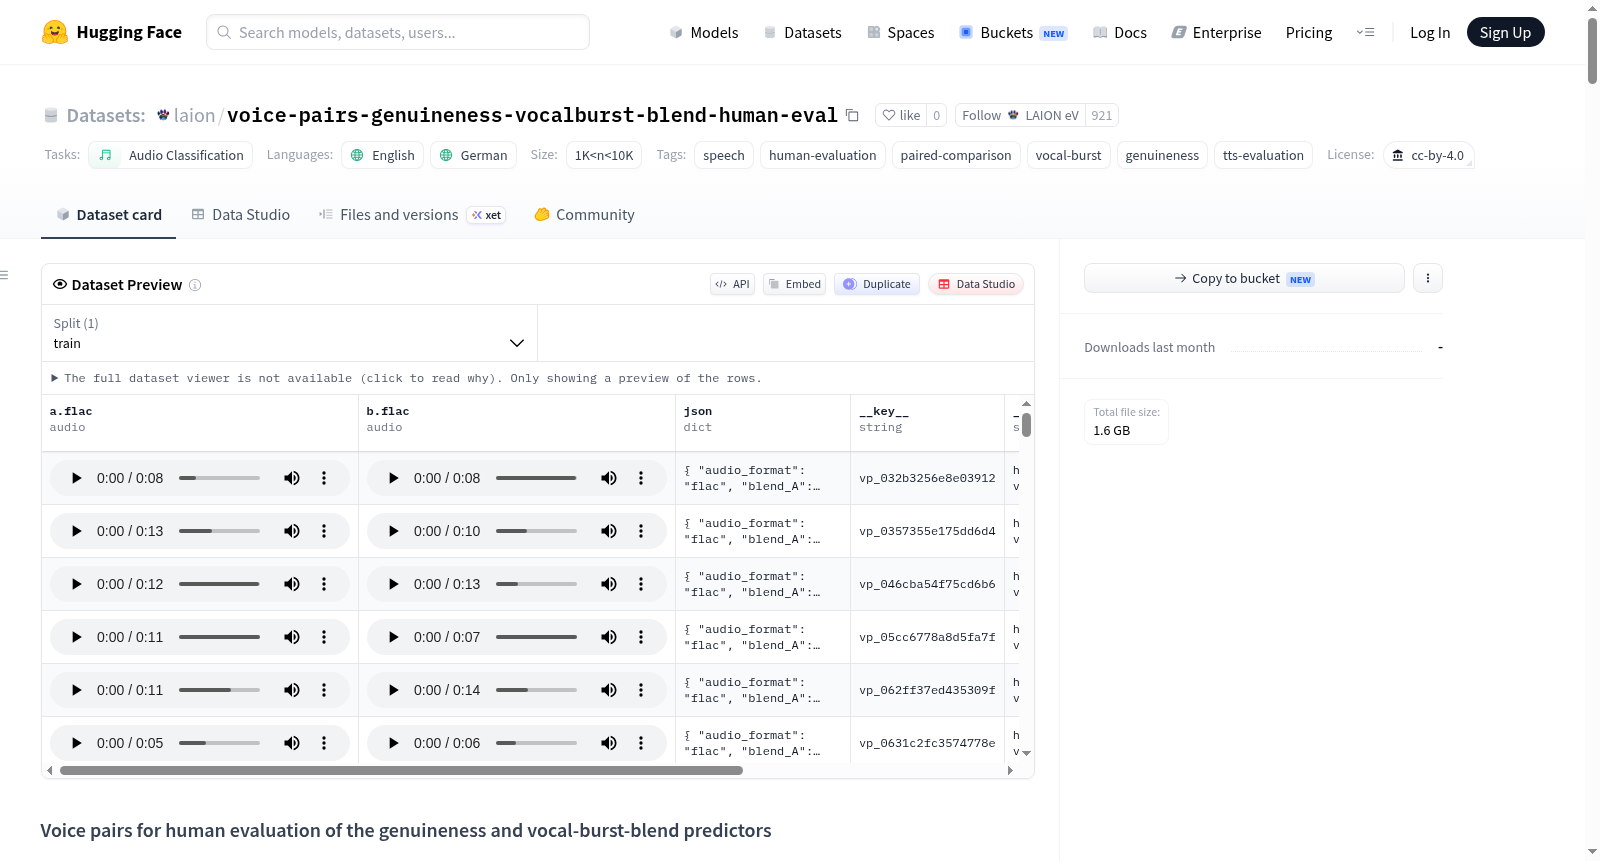
该数据集名为“用于人类评估真实性和爆发音混合预测器的语音对”,旨在支持人类评估两个自动预测器的可靠性。每个样本由一对音频片段组成,标注者需要判断其中哪个片段听起来更真实(sets A 和 B)或哪个片段的非语言爆发音(如笑、哭、叹息等)更自然地融入周围语音(sets C 和 D)。预测器已预先对每对片段做出判断,数据集的目标是收集人类评估,以衡量人类与模型的一致性,尤其是在预测差异较小时。数据集包含总计2000对(4000个独立音频片段),分布在8个WebDataset tar文件中,每个文件包含250对。音频采用FLAC格式,单声道,从MOSS神经编解码器解码而来,无损。元数据字段包括预测器名称、难度(easy/hard)、片段所属半域(合成语音或真实录音)、语言(英语或德语)、说话者标识、预测分数、差异值、正确答案标记(higher_is)等。选择规则严格:同一语言、同一半域、尽可能同一说话者、对于爆发音混合集要求相同爆发音标签、时长差异在4秒内、每个片段时长1.5-20秒。数据集主要用于语音质量评估、预测器验证、人类-模型一致性研究等任务。
This dataset is named "Speech Pairs for Human Evaluation of Authenticity and Burst-sound Mixing Predictors", designed to support human evaluation of the reliability of two automatic predictors. Each sample consists of a pair of audio clips, and annotators need to determine which clip sounds more authentic (sets A and B) or which clips non-verbal burst sounds (such as laughter, crying, sighing, etc.) blend more naturally into the surrounding speech (sets C and D). The predictors have already made judgments on each pair in advance, and the goal of the dataset is to collect human evaluations to measure the consistency between humans and models, especially when the prediction differences are small. The dataset contains a total of 2000 pairs (4000 independent audio clips), distributed across 8 WebDataset tar files, each containing 250 pairs. The audio is in FLAC format, mono, decoded from the MOSS neural codec, lossless. Metadata fields include predictor name, difficulty (easy/hard), half-domain of the clip (synthetic speech or real recording), language (English or German), speaker identifier, prediction score, difference value, correct answer label (higher_is), etc. The selection rules are strict: same language, same half-domain, same speaker as much as possible, for burst-sound mixing sets require the same burst sound label, duration difference within 4 seconds, each clip duration 1.5-20 seconds. The dataset is mainly used for tasks such as speech quality assessment, predictor validation, and human-model consistency research.
数据集概述:voice-pairs-genuineness-vocalburst-blend-human-eval
基本信息
- 许可证:CC-BY-4.0
- 任务类型:音频分类(音频质量人工评估)
- 语言:英语、德语
- 数据规模:1,000–10,000 条样本(具体为 2,000 对音频)
- 标签:语音、人工评估、成对比较、发声爆发、真实性、TTS 评估
数据集目的与定位
本数据集专为人工标注而构建,并非训练集。其核心用途是让人工听者裁决两个自动预测器的判断结果:
| 预测器 | 评分内容 | 原生评分范围 | 模型仓库 |
|---|---|---|---|
| genuineness | 片段听起来像是真实、有生活气息的口语瞬间,而非排练或合成的朗读程度 | 0–6 | laion/voiceclap-commercial-genuineness |
| vocal-burst blend | 非语言爆发(笑、抽泣、喘息、叹息、呻吟、嗤笑)融入周围语音的自然程度 | 0–10 | laion/voiceclap-commercial-vocalburst-blend |
每个样本为一对音频剪辑。标注者需判断哪一段听起来更真实(集合 A、B),或哪一段的发声爆发融入得更自然(集合 C、D)。预测器已预先做出判断,数据集的目的在于了解人类与预测器的一致性,以及当预测差异变小时一致性是否仍然保持。
整体规模:2,000 对 / 4,000 条独立音频剪辑,分布在八个 WebDataset tar 文件中。
规模化选择的难点与解决方案
阈值规则原本表述为:简单对要求“至少 2 的差异”,困难对要求“至少 1、至多 1.5”。这些数字并非源语料库 genuineness/blend 列的 0–1 量纲,而是基于各预测器原生评分范围(literal reading) 直接应用,原始分数从上游源 parquet 中恢复并据 uid 连接回每条语料行(3,147,802 行,0 行未连接)。
各集合的构造规则如下:
| 集合 | 预测器 | 难度 | 规则 | 数量 |
|---|---|---|---|---|
| A | genuineness(0-6) | 简单 | delta ≥ 2.0 | 500 |
| B | genuineness(0-6) | 困难 | 1.0 ≤ delta ≤ 1.5 | 500 |
| C | vocal-burst blend(0-10) | 简单 | delta ≥ 2.0 | 500 |
| D | vocal-burst blend(0-10) | 困难 | 1.0 ≤ delta ≤ 1.5 | 500 |
原语料库列实为分位数排名,而非线性重标定的分数,因此在语料库量纲与评分差异之间不存在线性映射关系。困难区间(1.0–1.5)低于或等于各预测器自身的验证误差(genuineness 验证 MAE 为 1.00/0-6;blend 验证 MAE 为 2.057/0-10),因此 B、D 集合要求人类裁决预测器本身无法可靠分辨的差异,这是数据集有意设计的研究问题。
配对选择规则
为保证预测分数尽可能成为唯一变量,每对配对尽可能控制以下因素:
- 相同语言(英语或德语)
- 相同半区:合成语音档案永不与真实录音配对
- 相同说话人(若有说话人标识,共 1,976/2,000 对;其余 24 对因源数据无语者键,则按预测年龄带和性别带匹配,并在元数据中标注
"speaker_matched": false) - 相同主要爆发标签(仅用于 blend 集合,避免把笑声的融入与抽泣的融入对比)
- 时长相差 4 秒以内,且每个片段在 1.5–20 秒之间
- C/D 集合中每对的两段音频确实包含发声爆发(
burst_labels非空)
配对按(语言 × 性别带 × 年龄带)分层轮询抽取,每声/说话人键最多 6 对,共涵盖 1,169 个不同声/说话人键。整个发布中无任何片段被重复使用 — 2,000 对共 4,000 条独立片段,恰好每对两条。
A/B 顺序随机化: 得分较高的成员在 2,000 对中有 1,012 对(50.6%)排在 A 位;哪个得分更高无法从文件名或排列顺序推断,仅记录在元数据字段 higher_is 中。标注者应仅看到 <pair_id>.a.flac 和 <pair_id>.b.flac,不应接触 JSON 中的其他信息。
文件结构与内容
八个 tar 文件划分如下:
| tar | 对数 | 大小 |
|---|---|---|
| blend-real-easy-000.tar | 250 | 239.1 MB |
| blend-real-hard-000.tar | 250 | 262.0 MB |
| blend-synthetic-easy-000.tar | 250 | 185.1 MB |
| blend-synthetic-hard-000.tar | 250 | 181.5 MB |
| genuineness-real-easy-000.tar | 250 | 190.1 MB |
| genuineness-real-hard-000.tar | 250 | 189.5 MB |
| genuineness-synthetic-easy-000.tar | 250 | 180.0 MB |
| genuineness-synthetic-hard-000.tar | 250 | 173.4 MB |
每对包含三个文件:
<pair_id>.a.flac— 配对中的一个片段<pair_id>.b.flac— 配对中的另一个片段<pair_id>.json— 元数据
音频为 FLAC 格式、单声道,从语料库的 MOSS 神经编解码 token 解码而来,未叠加任何有损编解码器。
元数据字段
| 字段 | 含义 |
|---|---|
pair_id |
稳定 ID,亦为 WebDataset 键 |
set |
A / B / C / D |
predictor |
genuineness 或 blend |
scale |
0-6 或 0-10,预测器的原生范围 |
difficulty |
easy 或 hard |
half |
synthetic(语音档案)或 real(录音) |
score_A, score_B |
预测器分别为 A/B 片段给出的分数(按 scale) |
delta |
两者绝对差 |
higher_is |
"A" 或 "B" — 答案键,不应展示给标注者 |
uid_lower, uid_higher |
按预测排名排序的两个片段 |
lang, voice_key, speaker_matched |
被控制的变量 |
stratum_gender, stratum_age |
抽取配对的层带(见下方注意事项) |
dataset_A, dataset_B |
源语料库标签 |
dur_A, dur_B |
时长(秒) |
burst_A, burst_B, nburst_A, nburst_B |
主要爆发标签及爆发计数 |
gen_A, gen_B, blend_A, blend_B |
两个预测器对两个片段的分数 |
sample_rate, audio_format |
音频参数 |
数据分布构成
半区构成
| 集合 | 半区 | 对数 |
|---|---|---|
| A(真实感,简单) | synthetic / real | 各 250 |
| B(真实感,困难) | synthetic / real | 各 250 |
| C(发声爆发融入,简单) | synthetic / real | 各 250 |
| D(发声爆发融入,困难) | synthetic / real | 各 250 |
语言分布
| 集合 | en | de |
|---|---|---|
| A | 216 | 284 |
| B | 233 | 267 |
| C | 254 | 246 |
| D | 245 | 255 |
年龄与性别来源说明(重要注意事项)
- 合成半区:年龄和性别来自语音档案卡的声明值(可用性:500 个语音档案中有 499 个),分类为十年带。
- 真实半区:这些录音不存在任何声明的年龄或性别。给出的年龄/性别带均为 VoiceNet 预测的感知维度(
AGEV感知语音年龄、GEND感知性别)— 即另一个模型听起来的声音年龄和性别特征,并非说话人的真实人口统计信息。这些数据仅用于样本分层和配对匹配,不得作为人口统计学事实使用或报告。
源数据集构成
| 集合 | 来源 |
|---|---|
| A | emolia=233, kartoffelphon=6, mls=11, voice_profile=250 |
| B | emolia=241, kartoffelphon=6, mls=3, voice_profile=250 |
| C | emolia=237, kartoffelphon=6, mls=7, voice_profile=250 |
| D | emolia=240, kartoffelphon=6, mls=4, voice_profile=250 |
实际实现的预测差异(delta)
| 集合 | 半区 | n | 最小 | 中位 | 均值 | 最大 |
|---|---|---|---|---|---|---|
| A(easy) | synthetic | 250 | 2.00 | 2.38 | 2.59 | 4.93 |
| A(easy) | real | 250 | 2.00 | 2.30 | 2.43 | 4.51 |
| B(hard) | synthetic | 250 | 1.00 | 1.01 | 1.04 | 1.50 |
| B(hard) | real | 250 | 1.00 | 1.15 | 1.18 | 1.50 |
| C(easy) | synthetic | 250 | 2.02 | 3.91 | 4.36 | 9.99 |
| C(easy) | real | 250 | 2.00 | 3.03 | 3.22 | 6.61 |
| D(hard) | synthetic | 250 | 1.00 | 1.18 | 1.21 | 1.49 |
| D(hard) | real | 250 | 1.00 | 1.25 | 1.25 | 1.50 |
排除规则与数据合规性
发布采用已验证 uid 模式的允许列表过滤(而非黑名单)。在 3,147,802 条语料行中,有 929,825 条在筛选前被排除,具体为:
| 排除数量 | 原因 |
|---|---|
| 914,287 | 播客录音:源语料库标记为 dataset = "emolia",但 uid 匹配播客模式(该标签下的行实际为 531,459 条真实 emolia、984,122 条播客、13,871 条无法识别) |
| 15,538 | 标记为 mls 但 uid 不在已核实 MLS 模式内的行(已核实保留 11,900 条) |
不含任何 mediathek 或 evasnippets 录音或转录文本。 源自 mediathek 的语音档案属于合成渲染(音频由 TTS 模型以语音档案为条件生成,非 mediathek 原始录音),因此被包含在范围内。
对全部 4,000 条已发布片段的最终核查结果:
| 核查项 | 结果 |
|---|---|
| 不符合 uid 允许列表的片段 | 0 |
| 已发布真实片段中含播客模式 uid | 0 |
| tar 内含转录成员 | 0(仅含 a.flac、b.flac、json) |
| 已发布元数据中的文本/字幕字段 | 无 |
不随附任何转录文本。 标注任务仅依靠听觉,且故意省略文本以避免任何转载受限转录文本的可能。
加载方式
python import webdataset as wds ds = wds.WebDataset("genuineness-real-easy-000.tar").decode() for s in ds: a, b, meta = s["a.flac"], s["b.flac"], s["json"]
许可与来源
采用 CC-BY-4.0 许可。音频从 LAION 语音语料库的 MOSS 编解码表示解码而来;真实语音半区源出 emolia、kartoffelphon 和 MLS,合成半区来自 LAION 语音档案。本数据集中的分数是上述两个模型的预测输出,而非人工标签— 提供人工标签正是构建此数据集的目的所在。