遇见数据集

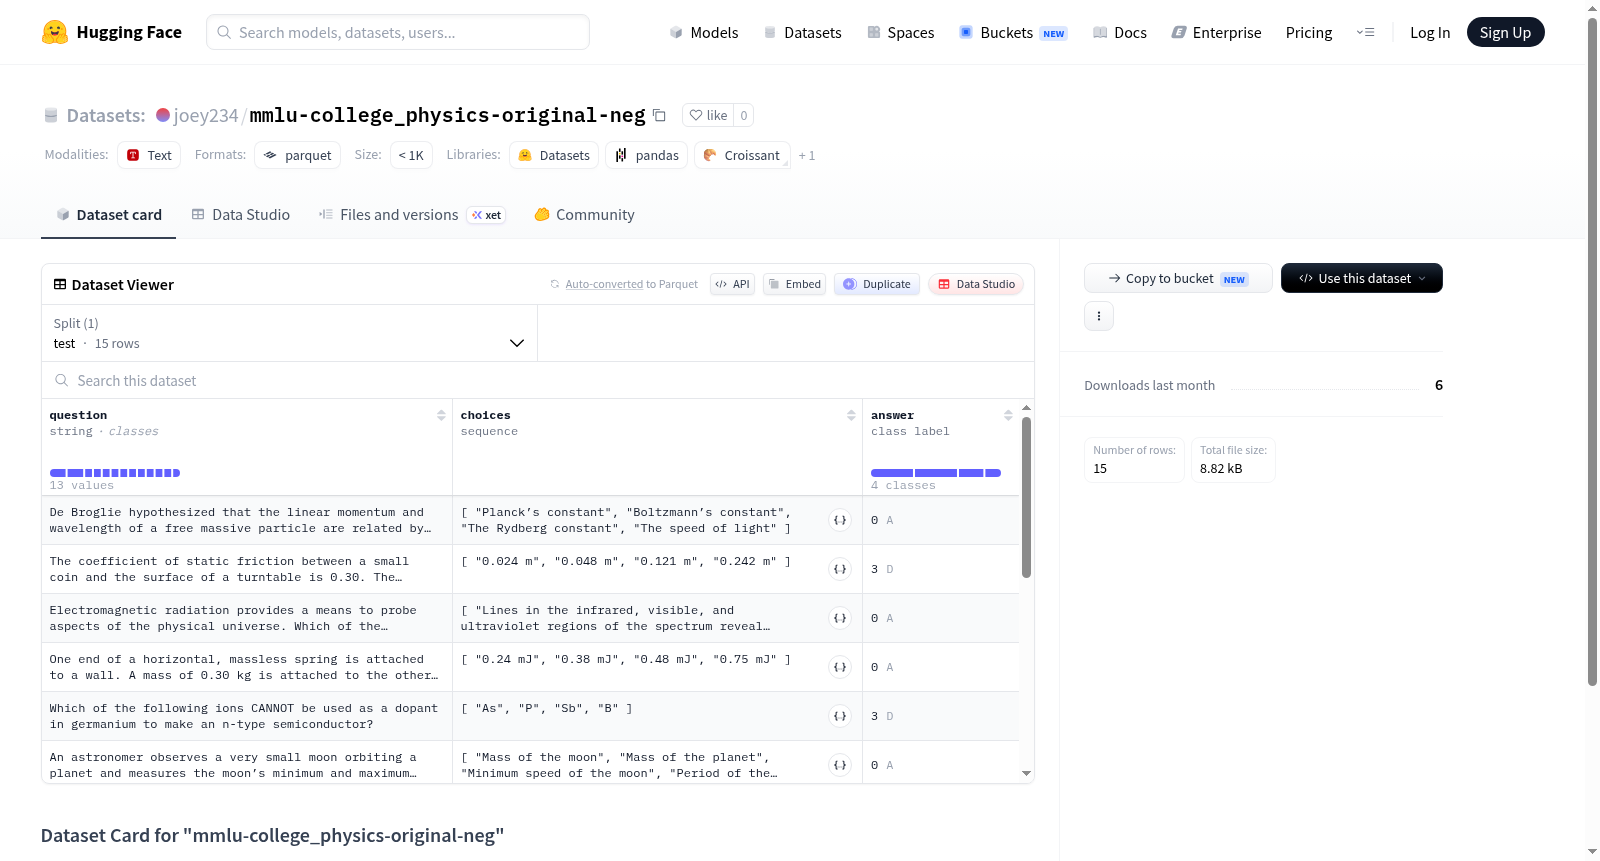
joey234/mmlu-college_physics-original-neg

收藏
Hugging Face2023-05-08 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: question dtype: string - name: choices sequence: string - name: answer dtype: class_label: names: '0': A '1': B '2': C '3': D splits: - name: test num_bytes: 4436.617647058823 num_examples: 15 download_size: 5989 dataset_size: 4436.617647058823 --- # Dataset Card for "mmlu-college_physics-original-neg" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

--- 数据集信息: 特征: - 字段名:问题,数据类型:字符串(string) - 字段名:选项,数据类型:字符串序列(sequence of string) - 字段名:答案,数据类型为分类标签(class_label),其内置标签名称映射为: '0' 对应 A,'1' 对应 B,'2' 对应 C,'3' 对应 D 数据集划分: - 划分名称:测试集(test),数据字节数:4436.617647058823,样本数量:15 下载大小:5989 字节 数据集总大小:4436.617647058823 字节 --- # "mmlu-college_physics-original-neg" 数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
joey234
原始信息汇总

数据集概述

数据集名称

mmlu-college_physics-original-neg

数据集特征

  • 问题(question):字符串类型
  • 选项(choices):字符串序列
  • 答案(answer):分类标签类型,具体标签如下:
    • 0: A
    • 1: B
    • 2: C
    • 3: D

数据集划分

  • 测试集(test):
    • 样本数量:15
    • 数据大小:4436.617647058823字节

数据集大小

  • 下载大小:5989字节
  • 数据集总大小:4436.617647058823字节
搜集汇总
数据集介绍
joey234/mmlu-college_physics-original-neg 数据集图片
构建方式
该数据集源自MMLU(大规模多任务语言理解)基准测试中的大学物理子集,通过特定的负样本采样策略构建而成。原始MMLU数据集包含涵盖多个学科的多选题,而此版本聚焦于大学物理领域,从原始测试集中筛选出15个样本,并保留了题目、四个选项及标准答案的结构。其构建过程强调对原始数据的精简与针对性负例选取,以服务于特定研究需求。
特点
数据集规模极小,仅含15个测试样本,适合作为轻量级评估工具或快速原型验证。每道题目均包含标准的多项选择格式(四个选项),答案标注为A、B、C或D的类别标签。其核心特点在于专注于大学物理领域,且通过负样本设计可能增加了模型推理的挑战性,适用于研究模型在特定科学学科上的鲁棒性与知识边界。
使用方法
使用该数据集时,可将其加载为Hugging Face的Dataset对象,通过'question'字段获取题目文本,'choices'字段获取选项列表,'answer'字段获取正确选项的类别标签。研究者可基于此评估语言模型在物理常识推理上的表现,或结合负样本特性分析模型的错误模式。推荐在模型微调或零样本测试场景中,将其作为领域专精评估的补充数据集。
背景与挑战
背景概述
在自然语言处理与知识推理的交汇领域,大规模多任务语言理解(MMLU)基准测试自2020年由OpenAI等机构提出以来,已成为评估语言模型跨学科知识掌握程度的核心标杆。该数据集聚焦于大学物理这一特定子领域,旨在检验模型对经典力学、电磁学、热力学等基础物理概念的抽象理解与逻辑推导能力。joey234/mmlu-college_physics-original-neg数据集作为MMLU的衍生版本,通过引入否定式样本设计,进一步挑战模型在反事实情境下的知识应用,推动了对模型鲁棒性和深层语义理解的探索。其研究问题直指当前语言模型在专业学科推理中的局限性,为后续改进提供了关键对照。
当前挑战
当前数据集面临的核心挑战在于双重层面:其一,在领域问题层面,大学物理试题要求模型不仅记忆公式,还需理解物理定律的适用条件与边界,而否定式样本的加入加剧了因果推理与错误选项辨识的难度,这对模型的概念抽象能力和逻辑一致性构成严峻考验。其二,在构建过程中,仅有15个测试样本的极小规模限制了统计显著性与泛化评估的可靠性,同时数据来源的原始性(源自MMLU子集)可能引入学科覆盖不均或表述歧义,需谨慎处理噪声与标注偏差。此外,如何确保否定样本的语义合理性而不陷入人为构造的伪反例,亦是数据质量保障的关键瓶颈。
常用场景
经典使用场景
该数据集源自大规模多任务语言理解基准(MMLU)中的大学物理子集,经过负样本处理,专用于评估和提升语言模型在物理学科知识上的推理与判别能力。其经典使用场景聚焦于多选问答任务,模型需从四个选项中精准识别正确物理概念、定律或计算结论,常用于检验预训练模型在科学知识掌握上的鲁棒性与泛化边界。
实际应用
在实际应用中,该数据集可模拟物理教育场景中的自动答题与错题诊断系统,支持智能辅导工具对学习者物理知识薄弱环节的精准定位。同时,它助力科研机构构建更具科学素养的对话助手,在学术文献检索、实验方案验证等场景中辅助专家进行快速决策,降低知识误判风险。
衍生相关工作
该数据集催生了多项经典工作,包括针对科学知识蒸馏的负样本增强训练策略、基于对比学习的物理概念纠错模型,以及融入领域语法的物理问答推理框架。这些工作进一步扩展了MMLU基准在物理子方向上的分析维度,为构建可解释、抗干扰的科学语言模型奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务