hf-model-downloads-by-origin-2022-2026
收藏资源简介:
本数据集名为按来源国统计的Hugging Face模型下载量(2022-2026年),旨在提供按模型来源国聚合的Hugging Face模型年度下载计数,以镜像OpenRouter风格的美国与中国份额图表。数据来源于2022年至2026年期间存档的Hugging Face Hub访问日志,采用与官方模型下载方法一致的计算方式(已验证误差约0.4%),将对特定触发文件(如config.json、.gguf、.mlmodel等)的成功解析请求计为一次下载。核心特征在于其来源国归属逻辑:重新托管或量化版本的下载量被归功于原始模型的来源国,而非重新托管者。归属规则基于可信的第一方组织所在国家,或通过仓库名称检测模型家族(例如,qwen/glm/deepseek系列归为中国,llama/gemma/phi系列归为美国,mistral/flux/stable-diffusion系列归为欧盟等)。没有明确基础模型谱系的社区模型被标记为社区/独立类别。数据集包含多个结构化文件:summary_by_category_year.csv提供按类别(美国/中国/欧盟/社区)和年份的最终聚合下载量;repo_classified.csv提供每年排名前5000的仓库的详细数据,包括仓库名、分配类别和年度下载量;downloads_by_namespace_year.csv提供原始的按命名空间和年份的下载数据(无国家归属);mapping.csv提供命名空间到类别和所有者的映射;classify.py包含可编辑的分类规则脚本;cat_year_origin.json为JSON格式的聚合摘要。数据集中展示了2023年至2026年(部分)美国与中国模型下载量占两者总和的百分比趋势,显示了中国份额从1%增长至18%的变化。需要注意的是,2026年数据仅包含1月至6月;国家/模型家族的映射是尽力而为且可通过脚本修改的;且每年仅统计了前5000个仓库的下载量,这些仓库覆盖了总下载量的95%以上。
This dataset, named HF model downloads by origin country (2022-2026), aims to provide annual download counts for Hugging Face models aggregated by model origin country, mirroring OpenRouter-style US vs China share charts. The data is sourced from archived Hugging Face Hub access logs from 2022 to 2026, using the same calculation method as the official model downloads (with a verified error margin of about 0.4%), counting successful parse requests for specific trigger files (e.g., config.json, .gguf, .mlmodel) as one download. The core feature is its origin country attribution logic: downloads of re-hosted or quantized versions are credited to the origin country of the original model, not the re-hoster. Attribution rules are based on trusted first-party organization countries or model family detection via repository names (e.g., qwen/glm/deepseek series attributed to China, llama/gemma/phi series to the US, mistral/flux/stable-diffusion series to the EU, etc.). Community models without clear base model lineage are labeled as Community/Independent. The dataset includes multiple structured files: summary_by_category_year.csv provides final aggregated downloads by category (US/China/EU/Community) and year; repo_classified.csv provides detailed data for the top 5000 repositories each year, including repository name, assigned category, and annual downloads; downloads_by_namespace_year.csv provides raw download data by namespace and year (without country attribution); mapping.csv provides namespace-to-category and owner mappings; classify.py contains an editable classification rule script; cat_year_origin.json is a JSON-formatted aggregation summary. The dataset shows the trend of US vs China model download shares as a percentage of their total from 2023 to 2026 (partial), indicating Chinas share growing from 1% to 18%. Note that 2026 data only includes January to June; country/model family mappings are best-effort and modifiable via script; and only the top 5000 repositories per year are counted, covering over 95% of total downloads.
数据集概述:HF模型下载量按来源国家统计(2022-2026)
数据集名称:HF model downloads by origin country (2022–2026)
许可证:other
标签:huggingface-internal, analytics, downloads
数据内容与结构
该数据集统计了2022年至2026年间Hugging Face平台上的模型下载次数,按模型仓库和模型来源国家进行聚合,旨在用HF数据呈现类似OpenRouter的“中美份额对比”图表。
数据集包含以下文件:
- summary_by_category_year.csv:按类别(美国/中国/欧盟/社区)和年份汇总的最终下载数据
- repo_classified.csv:每年排名前5000的仓库及其分类、下载量
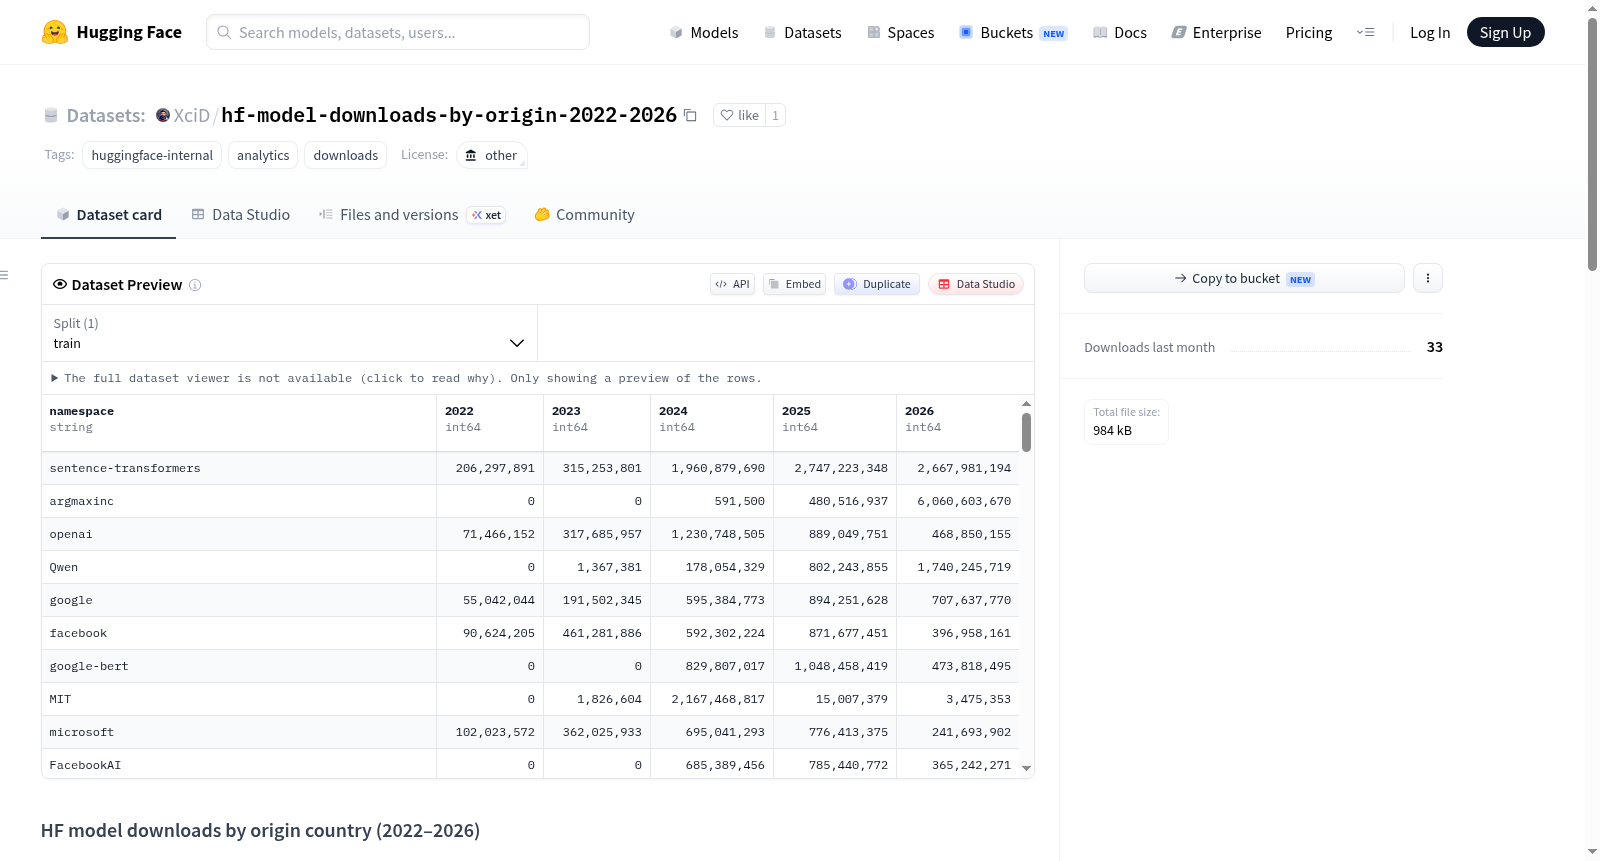
- downloads_by_namespace_year.csv:按命名空间和年份的原始下载量(无国家归属)
- mapping.csv:命名空间 → 类别 → 所有者的映射(首轮组织映射)
- classify.py:组织+模型系列分类规则脚本(可重新运行以重新映射)
- cat_year_origin.json:与summary_by_category_year.csv相同的JSON格式数据
下载计算方式
数据来源为归档的Hub访问日志(通过Athena查询elastic-cloud-archive-db.all_requests_reports),经过验证与官方下载徽章差异约0.4%。
下载定义为:对以下触发文件的GET/HEAD解析请求(状态码200/302/304/307):
config.json,config.yaml,hyperparams.yaml,params.json,meta.yaml- 任何
.gguf/.mlmodel/.llamafile/.tflite/.pte文件
所有请求均经过Hub解析端点,因此Hub日志能捕获完整情况。
来源归属规则
重新托管者或量化版本被归功于原始模型所在国家,而非重新托管者:
unsloth/Qwen2.5-7B-GGUF→ 中国bartowski/Meta-Llama-3.1-8B-GGUF→ 美国
规则:可信第一方组织 → 其所属国家;否则根据仓库名称检测模型系列:
qwen/glm/deepseek→ 中国llama/gemma/phi→ 美国mistral/flux/stable-diffusion→ 欧盟Community/Independent= 没有基础模型谱系的社区模型(如任务分类器、独立嵌入),无来源国家
主要数据(中美对比,占中美下载量百分比)
| 年份 | 美国 | 中国 |
|---|---|---|
| 2023 | 99% | 1% |
| 2024 | 92% | 8% |
| 2025 | 86% | 14% |
| 2026* | 82% | 18% |
*2026年为部分年份(1月至6月),绝对总量较低,份额可比较。转折点出现在2024年(Qwen2/2.5、DeepSeek)。
注意事项
- 2026年仅包含1月至6月数据,为部分年份
- 国家/模型系列映射为尽力而为,可通过
classify.py编辑修改(例如:all-MiniLM/mpnet/e5归为美国,bge归为中国,gte归为中国,bert/gpt2/roberta归为美国) - 仓库级别表格仅保留每年排名前5000的仓库,覆盖约95%以上的下载量