
遇见数据集

Shack870/qwen-air-qpu-mcp-lab

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

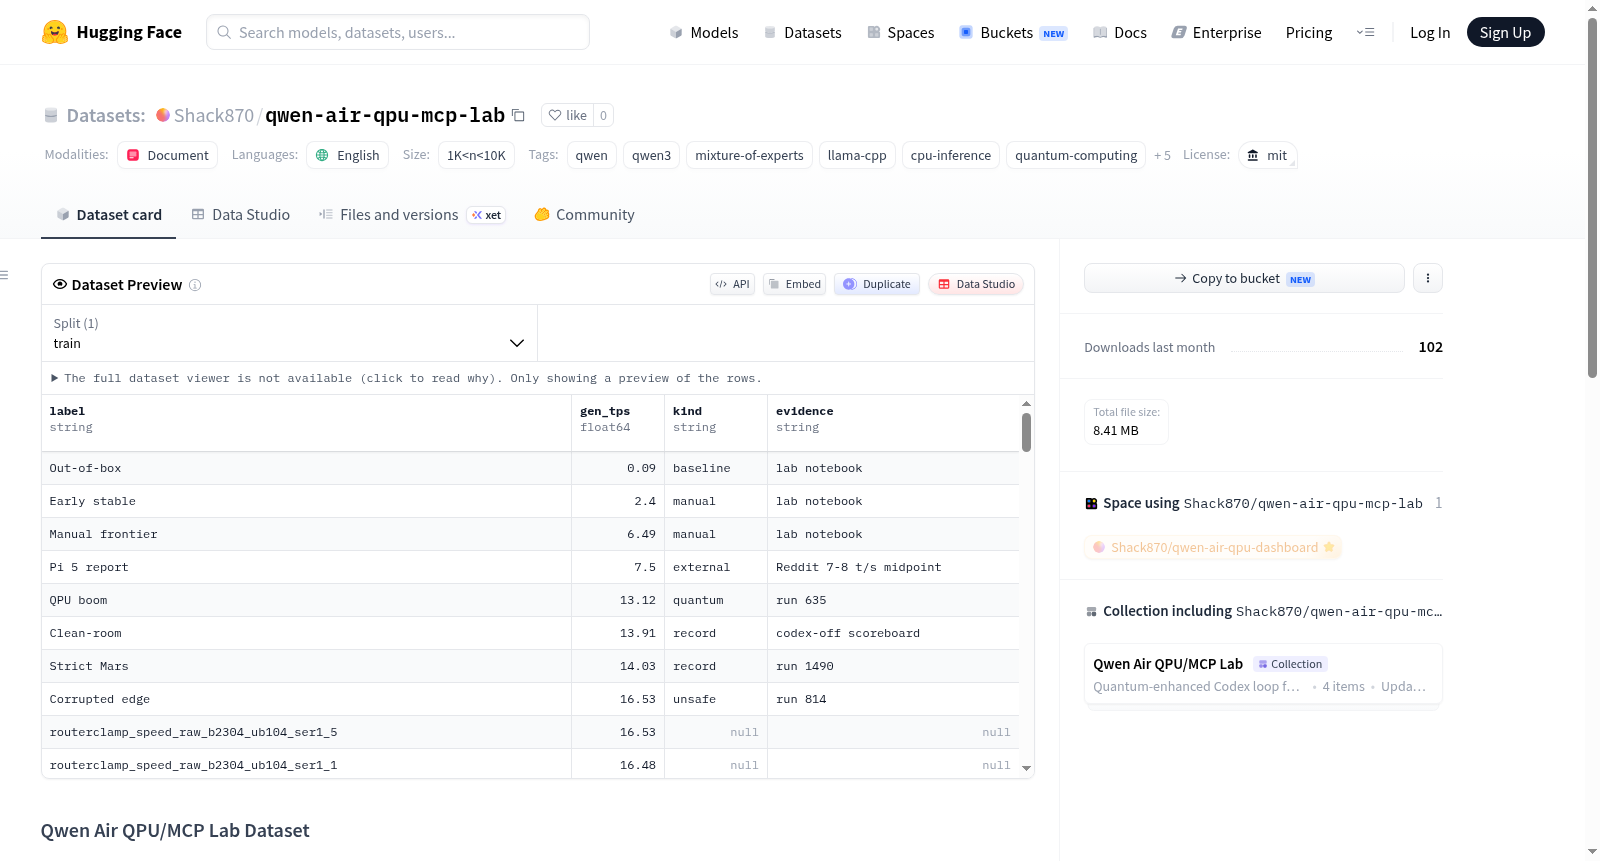
该数据集仓库镜像了Qwen Air QPU/MCP Lab的公共工件:这是一个在2017年Intel MacBook Air(配备8GB RAM)上进行的CPU-only Qwen3 MoE推理优化项目。关键结果是在16,384上下文长度下,使用同步的Codex驱动、IBM Quantum-informed autoresearch循环,将Qwen3-30B-A3B-Instruct-2507-GGUF的生成令牌/秒从约0.09提升到14.03。QPU并未运行Qwen;IBM Quantum在研究循环内采样紧凑的QUBO候选空间,而MacBook通过本地的llama.cpp推理对每个候选进行评估。

This dataset repository mirrors the public artifacts for the Qwen Air QPU/MCP Lab: a CPU-only Qwen3 MoE inference optimization project on a 2017 Intel MacBook Air with 8GB RAM. The headline result is a quality-gated improvement from about 0.09 to 14.03 generation tokens/sec on Qwen3-30B-A3B-Instruct-2507-GGUF at 16,384 context, using a synchronized Codex-driven, IBM Quantum-informed autoresearch loop. The QPU did not run Qwen. IBM Quantum sampled compact QUBO candidate spaces inside the research loop; the MacBook judged each candidate through real local llama.cpp inference.
提供机构:
Shack870
搜集汇总
数据集介绍
Shack870/qwen-air-qpu-mcp-lab 数据集图片
构建方式
该数据集源于一项名为Qwen Air QPU/MCP Lab的创新性研究,旨在探索如何在资源极度受限的硬件环境下,通过量子计算启发式方法与自动化研究循环,显著提升大规模混合专家模型的推理效率。具体而言,研究团队以一台仅有8GB内存的2017年款Intel MacBook Air为核心平台,在完全不依赖图形处理器的情况下,针对Qwen3-30B-A3B-Instruct-2507-GGUF模型进行推理优化。数据集的构建过程嵌入于一个由Codex驱动的同步自动化研究循环中,其中IBM Quantum系统负责对紧凑的QUBO候选空间进行采样,而MacBook则通过本地的llama.cpp推理引擎对每个候选方案进行真实评估与质量筛选。最终,所有经逻辑门控优化的运行记录、基准测试结果以及量子处理器作业日志,被系统性地整理、脱敏后,汇集为公开的SQLite数据库与CSV运行日志,构成了本数据集的核心内容。
使用方法
研究者可通过HuggingFace平台直接访问本数据集,获取其中包含的脱敏SQLite数据库与CSV运行日志,以复现论文中的核心量化结果。数据集的配套文档,如可复现性验证协议与社区基准报告指南,为使用者提供了标准化的实验评估流程。建议用户在本地配置llama.cpp环境,并参照GitHub仓库中的详尽说明,搭建与原始实验一致的推理与评估管线。对于希望深入探索量子增强路径的学者,可结合IBM Quantum平台对数据集中包含的QUBO采样结果进行二次分析。此外,利用HuggingFace Spaces上的交互式仪表盘,用户能够直观地浏览、筛选并可视化不同实验配置下的性能数据,从而快速定位感兴趣的研究切入点。
背景与挑战
背景概述
随着大语言模型规模的急剧膨胀,在资源受限设备上高效部署模型成为前沿研究焦点。Qwen Air QPU/MCP Lab数据集诞生于2025年,由Shack870及其团队主导开发,核心探索在2017年款Intel MacBook Air(8GB RAM)上,利用CPU-only环境优化Qwen3-30B-A3B-Instruct-2507-GGUF混合专家模型的推理效率。研究融合了IBM Quantum量子计算与Codex驱动的自动化研究循环,实现了从0.09到14.03 token/s的生成速度跃升,为边缘设备上的MoE推理开辟了全新路径。该数据集不仅包含了完整的论文、基准数据与可复现性协议,更通过量子启发式空间搜索与经典推理的协同,重塑了资源受限场景下模型优化的方法论,对低功耗AI计算领域具有里程碑式的推动意义。
当前挑战
该数据集主要面临三方面挑战。首先,在领域问题层面,其旨在攻克极端资源约束下大模型的推理瓶颈,传统量化或剪枝技术难以在内存与算力双受限的硬件上实现质的飞跃,而量子优化与传统推理的融合范式尚未有成熟理论支撑。其次,构建过程中,研究人员需在2017年MacBook Air的有限算力上同步运行llama.cpp推理与IBM Quantum的QUBO采样,两者间的数据同步与调度机制极为脆弱;此外,QPU并未直接执行模型推理,仅通过紧凑解空间采样提供优化策略,如何确保量子采样结果对CPU推理的增益具有统计鲁棒性,构成了方法验证的巨大难题。最后,数据集内包含的基准数据库与运行日志需在匿名化处理的同时保留完整复现能力,对数据清洗与隐私保护提出了极高要求。
常用场景
经典使用场景
该数据集承载了在资源高度受限的硬件环境(如2017款Intel MacBook Air,仅8GB内存)下,对大规模混合专家(MoE)模型Qwen3-30B-A3B进行CPU推理优化的完整实验记录。经典使用场景包括验证量子计算与经典推理协同的自动化研究循环(autoresearch loop),其中IBM量子计算机(QPU)负责采样紧凑的二次无约束二元优化(QUBO)候选空间,而本地llama.cpp推理引擎负责对候选方案进行质量评判。通过同步的Codex驱动循环,实现了从0.09到14.03 tokens/sec的生成速度飞跃,上下文窗口达16,384,为低资源设备上的大模型部署提供了可复现的基准测试框架。
解决学术问题
该数据集直面边缘计算中推理效率与资源约束的核心矛盾,系统性地回答了在无GPU加速的遗留硬件上,如何协同量子启发的搜索算法与传统CPU推理以突破MoE模型的吞吐瓶颈。通过公开的SQLite数据库和运行日志,为学术界提供了首个将量子采样嵌入经典大模型推理流水线的可量化证据,揭示了紧凑QUBO空间优化对推理延迟的改善机理。这一工作弥合了量子计算加速与实用大模型推理之间的鸿沟,推动了低熵能效计算范式的理论探索,尤其对轻量化AI部署、绿色计算和量子启发式算法在自然语言处理中的应用具有重要的示范意义。
实际应用
该数据集的实际应用场景聚焦于让大语言模型在老旧或低功耗设备上实现实时推理,例如智能终端、嵌入式系统、教育科研笔记本等无GPU环境。其衍生的验证协议(REPROCESSIBILITY.md)和社区基准报告指南(COMMUNITY_VALIDATION.md)为开发者提供了标准化的性能复现流程,可直接用于评估不同硬件配置下MoE模型的CPU推理优化效果。此外,结合Hugging Face交互式仪表盘,该数据集支持研究人员以零成本复现量子增强的推理流水线,为物联网边缘AI、离线文本生成和知识密集型移动应用开辟了低成本部署的实用路径。
数据集最近研究
最新研究方向
在经典硬件瓶颈与量子计算交汇的前沿,该数据集见证了混合计算范式下轻量级推理优化的突破性探索。研究聚焦于利用IBM量子处理器(QPU)在同步自研循环中采样紧凑QUBO候选空间,从而引导CPU上的Qwen3混合专家模型(MoE)获得千倍级的生成吞吐率提升,从0.09 token/秒跃升至14.03 token/秒。这一成果不仅验证了量子启发式优化在经典语言模型推理加速中的实用潜力,也揭示了低资源设备通过量子-经典协同实现高性能推理的新路径,为边缘智能、可持续AI以及量子退火在NLP工程中的落地提供了里程碑式的实证依据。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

