
electricsheepeurope/europe-ilo-emp-stem-sex-cct-nb-employment-in-stem-occupations-by-sex-and-citizens
收藏数据链接:
官方服务:
资源简介:
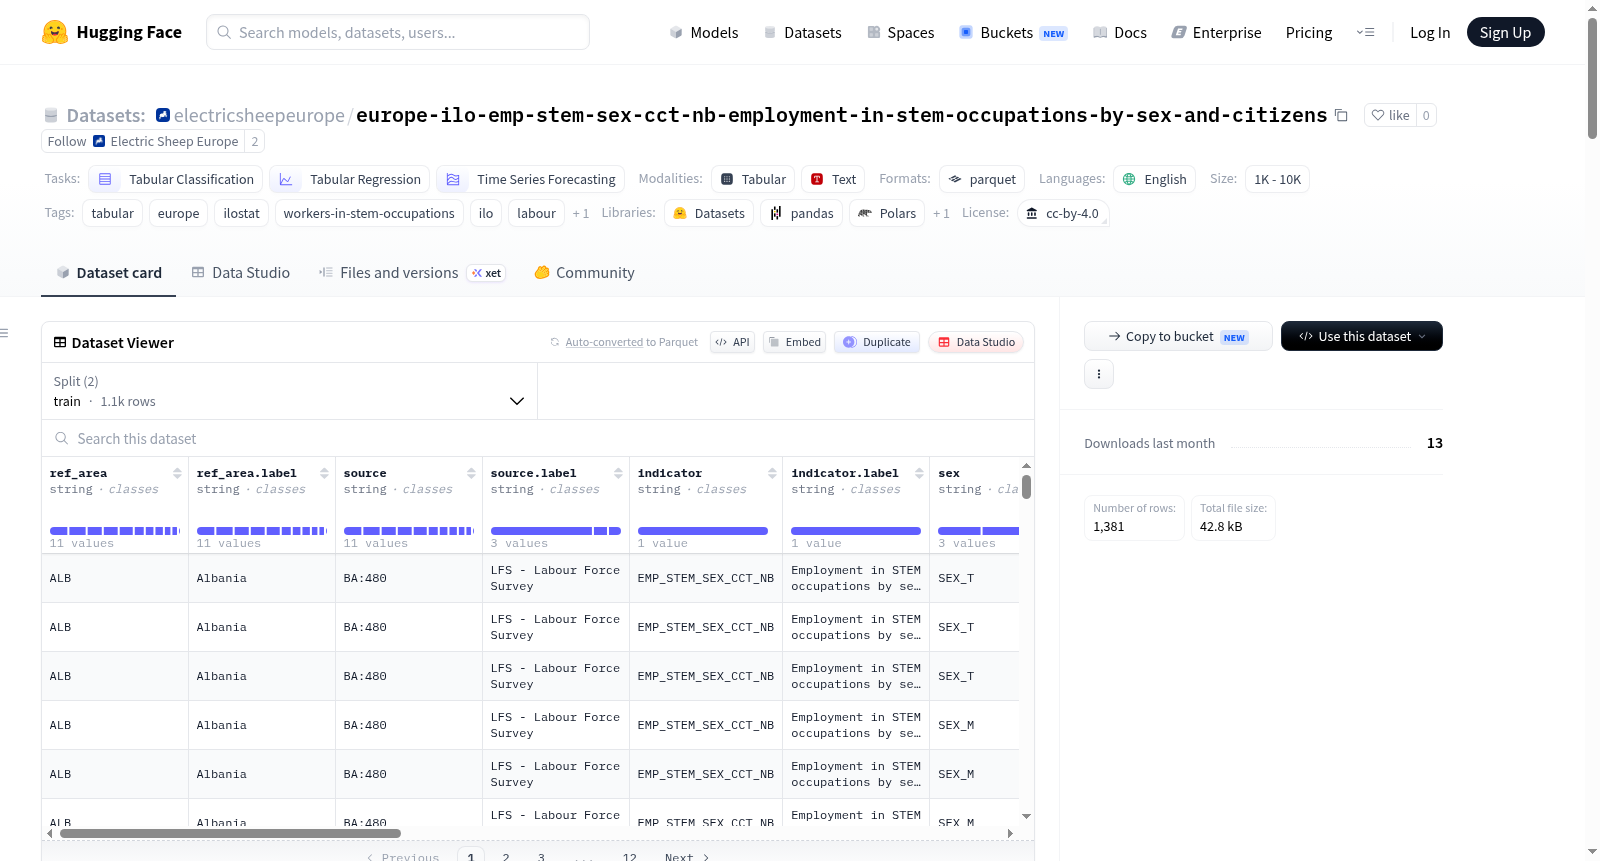
该数据集包含欧洲13个国家从2008年至2025年STEM职业就业的1,381个观测数据,按性别和公民身份分类,单位为千。数据来源于国际劳工组织(ILO)的ILOSTAT数据库,通过标准化处理确保一致性,涵盖单一指标EMP_STEM_SEX_CCT_NB,用于分析欧洲劳动力市场中STEM领域的就业趋势。
This dataset contains 1,381 observations of STEM occupation employment across 13 European countries from 2008 to 2025, disaggregated by sex and citizenship, in thousands. It is sourced from the International Labour Organizations ILOSTAT database, harmonized using international standards, and focuses on the indicator EMP_STEM_SEX_CCT_NB for analyzing employment trends in STEM fields within the European labour market.
提供机构:
electricsheepeurope搜集汇总
数据集介绍
构建方式
该数据集源自国际劳工组织(ILO)的ILOSTAT统计数据库,通过REST API直接获取原始指标“EMP_STEM_SEX_CCT_NB”(按性别和公民身份划分的STEM就业人数,单位:千),并依据欧洲ISO3国家代码进行地理过滤。数据经过ILOSTAT基于国际劳工统计学家会议(ICLS)定义的标准进行统一化处理,以年度频率呈现,涵盖了13个欧洲国家2008至2025年的观测值,共计1,381条记录。数据源类型在source.label字段中标注,以确保可追溯性。
特点
数据集以标准化表格形式组织,包含18个字段,核心指标为STEM领域就业人数。关键的维度拆解包括按性别(总、男、女)和公民身份进行分类,允许用户进行精细化的交叉分析。数据还附带了观测状态标志(如“不可靠”)和方法论修订的断点注释,为数据质量提供了透明度。所有数据均以整数年份(time)为时间轴,形成了适合时间序列分析的结构。
使用方法
该数据集可通过HuggingFace Datasets库便捷加载,使用`load_dataset`函数即可获取并转换为pandas DataFrame进行操作。用户可基于ref_area列按国家筛选,或基于indicator列对特定指标进行时间序列分析,亦可利用pivot_table函数构建国家×年份的矩阵,以支持面板数据分析。推荐在进行建模前,结合obs_status和note_indicator字段对数据质量进行预处理和标注过滤。
背景与挑战
背景概述
该数据集由国际劳工组织(ILO)的统计数据库ILOSTAT于2025年创建,并由Electric Sheep Europe重新整理发布,旨在提供欧洲13个国家2008至2025年间按性别和公民身份划分的STEM(科学、技术、工程和数学)职业就业数据。作为全球劳动统计的权威来源,ILOSTAT通过协调各国劳动力调查、家庭收入调查等微观数据,确保指标的标准化与可比性。这一数据集聚焦STEM领域就业这一核心研究问题,为分析欧洲劳动力市场中性别与公民身份对高技术职业参与的影响提供了关键定量基础,对推动劳动经济学、性别平等研究及移民政策评估具有重要参考价值。
当前挑战
该数据集所解决的领域问题在于,长期以来欧洲STEM职业就业数据分散于各国统计机构,缺乏跨国家、长时间序列的统一可比指标,尤其是按性别和公民身份细分的标准化数据。这阻碍了对高技能劳动力流动、性别差异演变等结构性问题的深入分析。构建过程中面临的主要挑战包括:整合13个来源国不同调查口径的原始数据,处理由方法论修订(如序列中断标注)带来的计量一致性难题;同时需标识不可靠观测值(如‘U’标记)及源数据差异,确保数据质量与追溯性。此外,数据集仅提供年度频率,无法捕捉更精细的季节性或季度波动,且部分国家覆盖年份不完整,限制了其时序分析效力。
常用场景
经典使用场景
在劳动经济学与科技人力资源研究领域,europe-ilo-emp-stem-sex-cct-nb数据集最经典的应用场景是对欧洲各国STEM(科学、技术、工程和数学)领域就业人数的时序分析与跨国比较。研究者可借助该数据集涵盖13个欧洲国家、横跨2008至2025年的1381条观测记录,按性别与国籍维度精细刻画STEM劳动力市场的演变轨迹,例如量化女性在STEM岗位中的参与度变化趋势,或探究不同国籍背景从业者的就业分布格局。
实际应用
在实际应用层面,该数据集能够直接服务于欧盟及其成员国的劳动力政策制定与评估工作,例如用于监测《欧洲技能议程》中关于提升STEM就业目标的执行进展。同时,它也可帮助企业人力资源部门进行区域人才储备分析,辅助跨国公司制定海外研发中心的属地化招聘策略。教育规划机构可依据不同国家与性别的就业数据,调整科学教育与职业培训的资源配置方向。
衍生相关工作
基于该数据集衍生的经典工作主要包括:构建欧洲STEM就业的预测性时间序列模型,用于预判未来十年各国科技人才缺口;开发性别差异分解分析框架,量化教育、职业隔离、社会文化等因素对STEM就业性别差距的贡献度;以及融合移民统计与公民身份维度,建立高技能劳动力跨国流动的引力模型。此外,该数据还被用于验证机器学习方法(如随机森林、LSTM)在劳动经济指标预测中的有效性,推动了计算社会科学方法论的演进。
以上内容由遇见数据集搜集并总结生成


