
Andy2703/items_raw_lite
收藏官方服务:
资源简介:
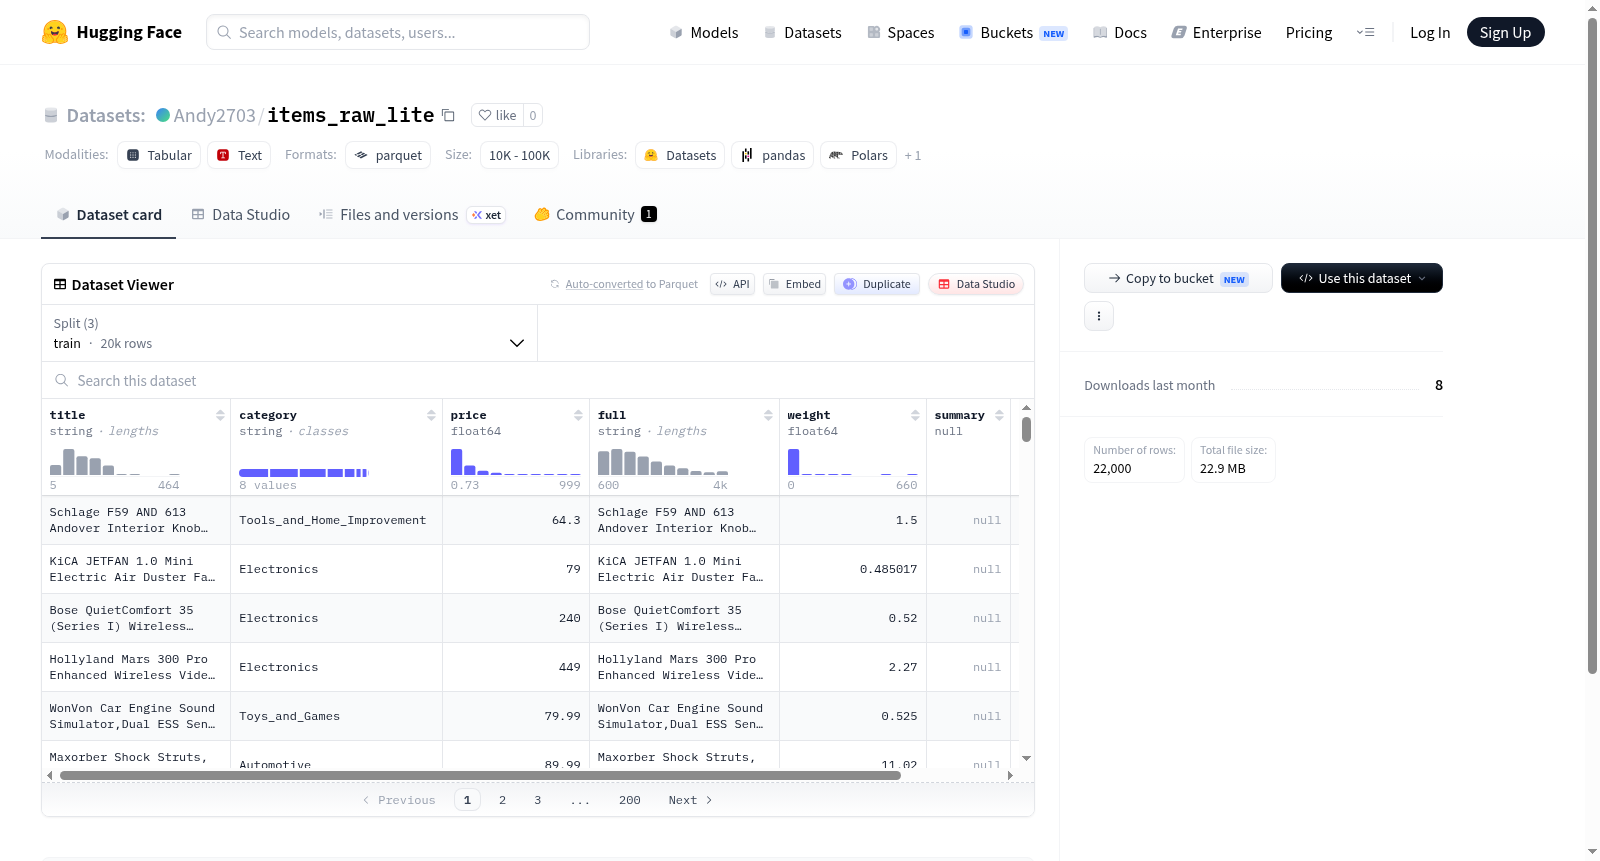
--- dataset_info: features: - name: title dtype: string - name: category dtype: string - name: price dtype: float64 - name: full dtype: string - name: weight dtype: float64 - name: summary dtype: 'null' - name: prompt dtype: 'null' - name: id dtype: 'null' splits: - name: train num_bytes: 36975786 num_examples: 20000 - name: validation num_bytes: 1841220 num_examples: 1000 - name: test num_bytes: 1887839 num_examples: 1000 download_size: 22928335 dataset_size: 40704845 configs: - config_name: default data_files: - split: train path: data/train-* - split: validation path: data/validation-* - split: test path: data/test-* ---
提供机构:
Andy2703搜集汇总
数据集介绍
构建方式
items_raw_lite数据集源自对电子商务领域商品信息的系统性采集与精炼。其构建过程以商品标题为核心,辅以品类标签、价格与重量等结构化数值字段,同时保留包含完整商品描述的全文信息。数据经过清洗与格式化处理,并划分为训练集(20000条)、验证集(1000条)与测试集(1000条),以满足机器学习模型的标准化训练流程。此外,数据集中预留了摘要与提示字段,为后续扩展语义理解任务提供了弹性空间。
特点
该数据集的特点在于其紧凑而多维度的结构设计。它既涵盖了商品标题、品类等基础文本信息,也纳入了价格与重量等连续数值特征,适合开展多模态或混合型数据分析任务。全文描述字段的存在使得模型能够学习丰富的上下文语义,而空缺的摘要与提示字段则暗示了数据集对生成式或问答式任务的潜在适配性。整体上,items_raw_lite以轻量化(约40MB)实现了对商品信息核心维度的覆盖,实现了数据规模与内容深度的平衡。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集,指定default配置即可自动获取划分好的train、validation与test拆分。数据以parquet格式存储,支持通过字段名称(如'title'、'price')直接访问各列信息。典型应用场景包括商品分类、价格预测或基于标题与描述的内容生成。对于需要额外语义信息的任务,用户可利用数据中的'full'字段作为输入,或自行填充'summary'与'prompt'字段以定制下游流程。
背景与挑战
背景概述
在电子商务与智能推荐系统飞速发展的背景下,商品数据的结构化与语义化成为推动相关研究的关键基础。items_raw_lite数据集应运而生,它是一个轻量级的商品信息数据集,包含20000条训练样本、1000条验证样本和1000条测试样本,每条记录涵盖商品标题、类别、价格、完整描述及重量等核心属性。尽管该数据集的创建时间、主要研究人员或机构未在文档中明确提及,但从其精炼的规模与清晰的特征设计来看,它旨在为商品分类、属性抽取、价格预测及文本摘要等任务提供标准化的测试平台。该数据集的影响力体现在其为小样本学习与轻量化模型研究提供了便捷的基准,尤其适合资源受限场景下的算法验证与快速迭代。
当前挑战
该数据集所解决的领域挑战主要集中于电子商务中非结构化商品信息的有效组织与利用。一方面,商品标题与描述往往包含噪声、缩写及多语言混杂,导致语义理解困难,而该数据集通过提供类别标签与结构化字段,为训练鲁棒的分类与信息抽取模型奠定了数据基础。另一方面,数据集构建过程中面临属性完整性不足的难题,例如'full'字段可能缺失,而'summary'与'prompt'字段完全为空,这要求研究者在预处理时需设计缺失值处理策略。此外,仅包含两万条训练样本的轻量级规模,虽降低了使用门槛,但亦限制了模型对长尾商品形态的泛化能力,需结合数据增强或迁移学习来弥补覆盖率的不足。
常用场景
经典使用场景
在电子商务与零售智能领域,items_raw_lite数据集凭借其丰富的商品属性信息,如标题、类别、价格与重量等,成为了构建商品推荐系统与价格预测模型的经典基准。研究者常利用该数据集探索基于商品元数据的用户兴趣建模,通过分析商品类别的分布规律与价格区间,挖掘潜在的市场细分与用户偏好。该数据集为跨模态商品理解提供了轻量级但结构清晰的起点,尤其适合用于验证通用特征提取方法的有效性。
实际应用
在实际产业应用中,items_raw_lite数据集为电商平台的智能运营与商品管理提供了关键支持。基于该数据集训练的分类模型可直接部署于在线商品审核系统,实现自动化商品上架与类别标注。同时,利用价格与重量特征构建的预测模型,能够协助电商企业实现动态定价与库存管理优化。该数据集在供应链优化、个性化营销推荐以及商品合规性检查等场景中展现出广泛的应用潜力。
衍生相关工作
围绕items_raw_lite数据集,学术界已衍生出多个经典研究方向。其中之一是基于商品标题与类别的语义匹配模型,推动了跨域商品检索技术的进步。部分研究利用该数据集的数值型特征,提出了结合统计学习与深度网络的混合架构用于价格预测,显著提升了预测精度。此外,该数据集还催生了关于商品特征标准化与缺失值处理的系统性研究,为后续构建更大规模的电商知识图谱奠定了基础。
以上内容由遇见数据集搜集并总结生成


