RoMo-HML-272
收藏资源简介:
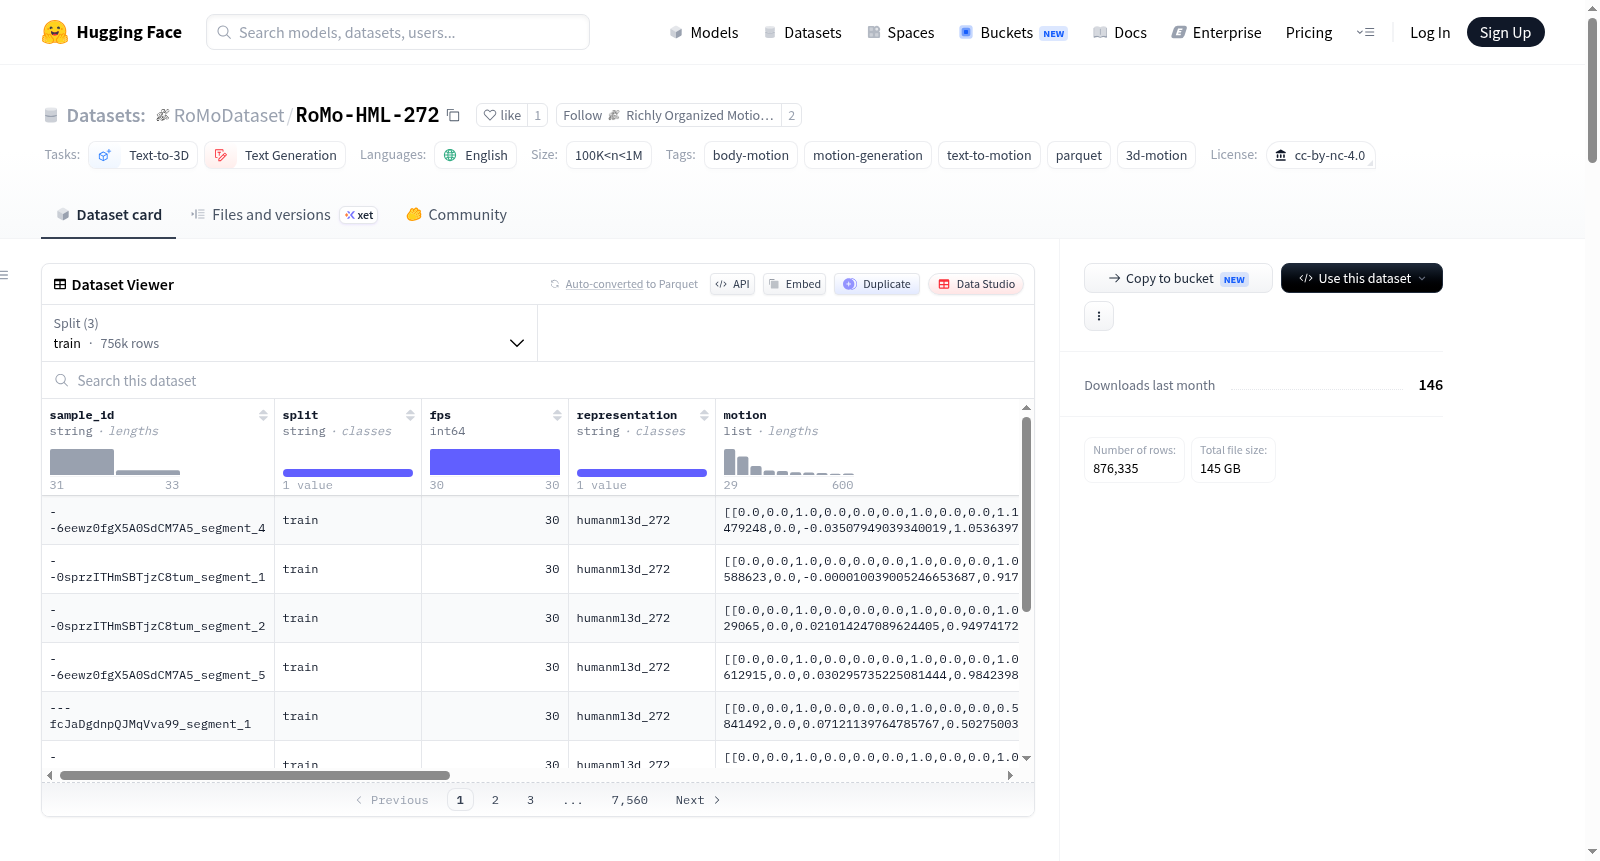
RoMo-HML-272是一个大规模人体动作数据集,采用272维HumanML3D风格的特征表示。该数据集在标准的263维HumanML3D编码基础上,额外增加了9个维度,用于表示绝对3D/接触增强特征,这些特征在近期文本到动作生成方法中被广泛使用。数据集包含约815,000个动作序列,帧率为30 fps。每个动作序列存储为形状(T, 272)的浮点数矩阵,其中T表示时间帧数。每个序列都配有5个不同详细程度的文本描述,从简短的标签(3-5个单词)到详细的段落描述(150-300个单词),这些描述由视觉语言模型自动生成。数据以Parquet格式存储,采用zstd压缩分片。数据集遵循CC BY-NC 4.0许可证,目前为私有/内部状态,将随相关研究论文公开发布。该数据集适用于文本到3D动作生成、动作生成、文本到动作等任务,为研究社区提供了大规模、多模态的人体动作数据资源。
RoMo-HML-272 is a large-scale human motion dataset using a 272-dimensional HumanML3D-style feature representation. It extends the standard 263-dimensional HumanML3D encoding with an additional 9 dimensions for absolute 3D/contact enhancement features, which are widely used in recent text-to-motion generation methods. The dataset contains approximately 815,000 motion sequences at 30 fps. Each sequence is stored as a floating-point matrix of shape (T, 272), where T denotes the number of time frames. Each sequence is accompanied by 5 text descriptions of varying detail levels, ranging from short labels (3-5 words) to detailed paragraph descriptions (150-300 words), automatically generated by a vision-language model. The data is stored in Parquet format with zstd-compressed sharding. It is licensed under CC BY-NC 4.0 and is currently private/internal, to be released publicly with the associated research paper. This dataset is suitable for tasks such as text-to-3D motion generation, motion generation, and text-to-motion, providing a large-scale, multimodal human motion data resource for the research community.
RoMo-HML-272 数据集概述
RoMo-HML-272 是一个大规模的人体动作数据集,包含约 815,000 个动作序列,采用 272维 的运动特征表示。该数据集是对标准 263维 HumanML3D 编码的扩展,额外增加了 9个维度 用于绝对3D/接触增强特征,适用于文本生成运动等任务。数据集以 Parquet 格式(zstd 压缩分片)存储,帧率为 30 fps,许可协议为 CC BY-NC 4.0。
运动表示
- 每个动作存储为
list<list<float32>>格式,形状为(T, 272),其中T为帧数。 - 维度 0–262:遵循 HumanML3D-263 布局,包括根部角速度/线速度、根部高度、局部关节位置/6D 旋转/速度、脚部接触信息。
- 维度 263–271:附加的绝对3D根部/关节增强特征,用于近期文本生成运动研究。
- 仓库根目录提供了完整 272 维特征空间的
Mean.npy和Std.npy文件。 - 仅需 263 维特征的子集可参考 RoMo-HML-263。
文本描述
每个序列包含 5个层级 的文本描述,由视觉语言模型生成:
| 层级 | 列名 | 平均词数 |
|---|---|---|
| 标签 | caption_l0 |
3–5 |
| 简短 | caption_l1 |
8–15 |
| 中等 | caption_l2 |
30–60 |
| 详细 | caption_l3 |
80–150 |
| 段落 | caption_l4 |
150–300 |
数据格式
RoMo-HML-272/ ├── data/ │ ├── train-.parquet │ ├── val-.parquet │ └── test-*.parquet ├── Mean.npy ├── Std.npy ├── README.md └── .gitattributes
加载方式
使用 datasets 库加载,示例代码如下:
python from datasets import load_dataset import numpy as np
ds = load_dataset("RoMoDataset/RoMo-HML-272") sample = ds["train"][0] motion = np.asarray(sample["motion"], dtype=np.float32) # (T, 272)
如需解码为关节位置,可使用 motion_toolbox 中的转换器:
python from motion_toolbox.converters.format_272_converters import Format272ToMotionConverter
cvt = Format272ToMotionConverter() m = cvt.convert({"motion": motion, "is_normalized": False}) positions = m.positions # (T, J, 3) in Y-up world coordinates
数据收集与处理流程
采用与 RoMo 其他版本相同的上游流程:基于 GVHMR 的 SMPL-X 恢复 → 对齐地面Y轴关节 → HumanML3D 风格特征提取 → 多层级标题生成 → 帧清理。额外9个维度(263–271)与263维特征在相同的清理帧范围内计算,因此与 RoMo-HML-263 共享行数和 sample_id。
引用
论文及引用信息即将发布。若使用本数据集,建议同时引用原始 HumanML3D 论文。
许可与联系
- 许可协议:CC BY-NC 4.0。完整文本见
RoMo-SMPLX。 - 联系:如有问题、访问请求或合作意向,请在仓库中提出 Issue。