osm-polygon-web-search
收藏资源简介:
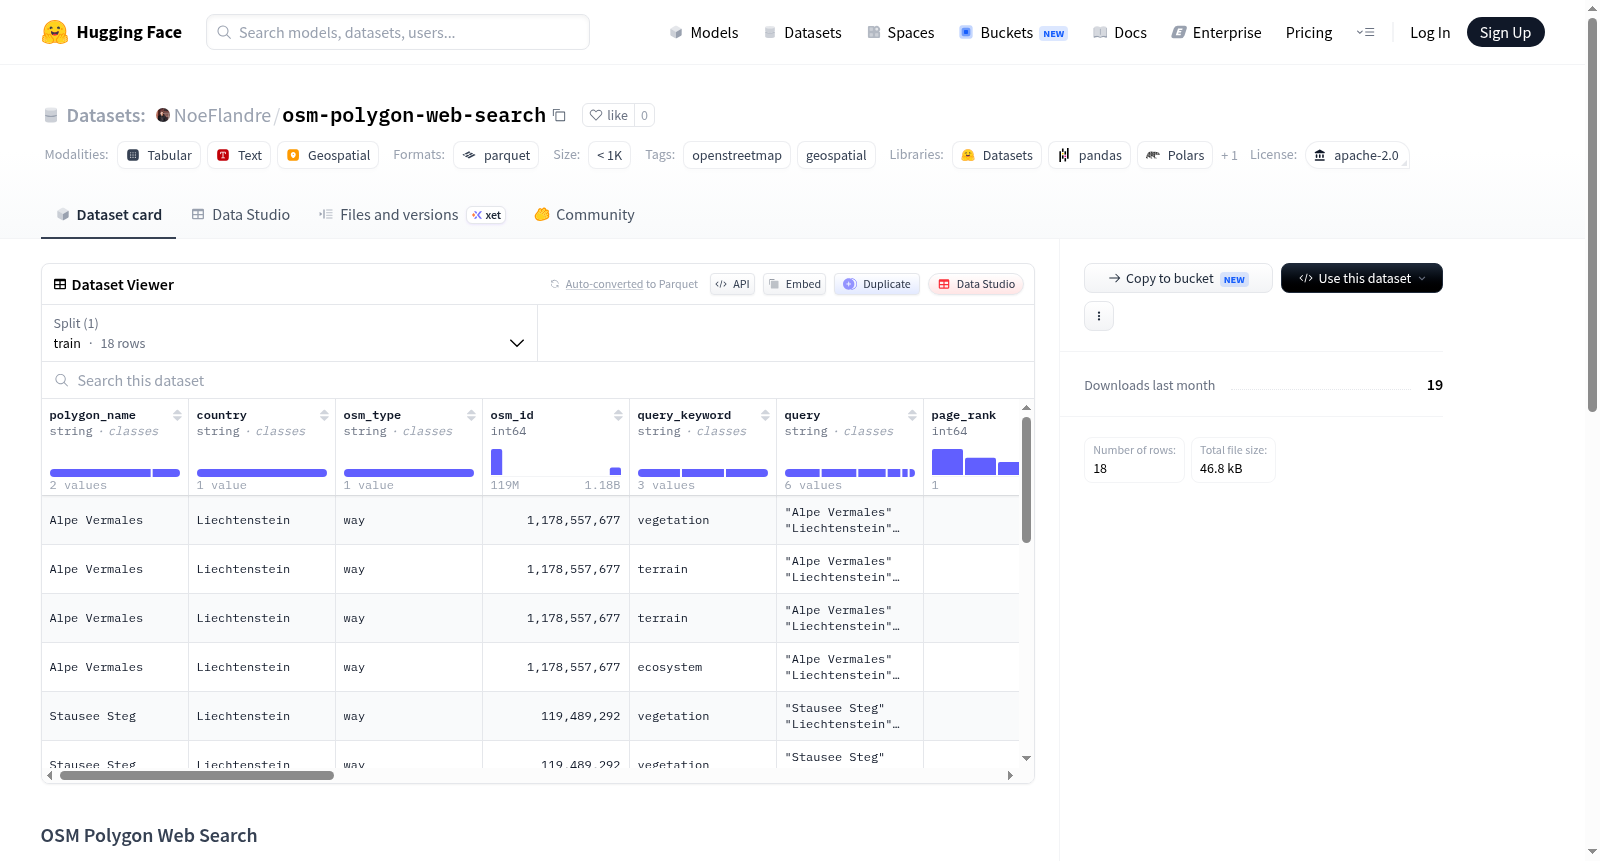
该数据集名为“OSM Polygon Web Search”,是一个公开的 Hugging Face 数据集,包含一个经过明确批准的 POC(概念验证)表 `train.parquet`。表中的每一行对应一个通过 Brave 搜索引擎抓取的网页,并记录了与该网页相关的多边形几何信息、查询关键词、页面元数据以及经过 Trafilatura 工具提取的完整页面文本。数据集覆盖九种查询变体:V1“土地覆盖”、V2“土地利用”、V3“植被”、V4“地形”、V5“土壤表面”、V6“生态系统”、V7“自然地理”、V8“建筑基础设施”和V9“景观环境”。主要字段包括:多边形几何(GeoJSON、质心、边界框)、OSM 标识(多边形名称、国家、OSM 类型、OSM ID、土地利用)、查询信息(关键词、确切查询)、页面元数据(页面排名、标题、URL、HTTP 状态)以及页面文本及其字符数。该数据集专门设计用于 Hugging Face Dataset Viewer,以便用户直接检查抓取结果。注意:提取的证据和标准字段已被省略,但完整解析的文本仍然可用。Apache-2.0 许可证仅适用于项目的原始代码和文档,OSM 派生字段和网络派生文本应遵循其各自来源的条款。
The dataset is named OSM Polygon Web Search, a public Hugging Face dataset containing a POC (Proof of Concept) table `train.parquet`. Each row corresponds to a web page crawled via the Brave search engine, recording polygon geometry information, query keywords, page metadata, and the full page text extracted by the Trafilatura tool. The dataset covers nine query variants: V1 Land Cover, V2 Land Use, V3 Vegetation, V4 Terrain, V5 Soil Surface, V6 Ecosystem, V7 Physical Geography, V8 Built Infrastructure, and V9 Landscape Context. Key fields include: polygon geometry (GeoJSON, centroid, bounding box), OSM identifiers (polygon name, country, OSM type, OSM ID, land use), query information (keyword, exact query), page metadata (page rank, title, URL, HTTP status), and page text along with its character count. The dataset is specifically designed for the Hugging Face Dataset Viewer to allow users to directly inspect the crawled results. Note: Extracted evidence and standard fields have been omitted, but the fully parsed text remains available. The Apache-2.0 license applies only to the original code and documentation of the project; OSM-derived fields and web-derived text should follow the terms of their respective sources.
数据集概述:OSM Polygon Web Search
数据集地址:https://huggingface.co/datasets/NoeFlandre/osm-polygon-web-search
简介
该数据集是一个公开的 Hugging Face 数据集,包含一个经明确批准的 POC(概念验证)表,存储于 train.parquet 文件中,每一行对应一个抓取的网页。数据集专为 Hugging Face Dataset Viewer 设计,公开了多边形几何信息、Brave 搜索查询、网页 URL、标题、HTTP 状态码以及通过 Trafilatura 解析的完整页面文本。
数据内容
- 查询变体:共覆盖 9 种查询变体,包括:
- V1:
land cover - V2:
land use - V3:
vegetation - V4:
terrain - V5:
soil surface - V6:
ecosystem - V7:
physical geography - V8:
buildings infrastructure - V9:
landscape environment
- V1:
主要字段说明
| 字段名 | 用途 |
|---|---|
polygon_geojson、centroid、bounding-box 字段 |
多边形几何和地图上下文 |
polygon_name、country、osm_type、osm_id、landuse |
OSM 实体标识和标签 |
query_keyword、query |
批准的查询关键词短语及实际使用的 Brave 查询语句 |
page_rank、title、page_url、http_status |
检索到的页面元数据 |
text、text_char_count |
由 Trafilatura 提取的完整页面文本及其长度 |
数据说明与限制
- 本版省略了提取的证据和标准字段,但保留了完整的解析文本(
text)以供检查。 - 原始 PBF 文件和本地中间产物仅存于本地,上传表中仅包含
source_pbf字段(PBF 文件名),不含本地路径、原始 HTML 或提供方的响应内容。 - 为便于在 Viewer 中检查结果,本 POC 明确包含了完整的页面解析文本。
许可说明
- 该数据集采用 Apache-2.0 许可证,适用于项目原始代码和文档。
- OSM 派生字段和网页派生文本保留其来源特定的条款,不应视为 Apache-2.0 授权内容。