ovos-tts-bench-intents-for-eval-prompts
收藏资源简介:
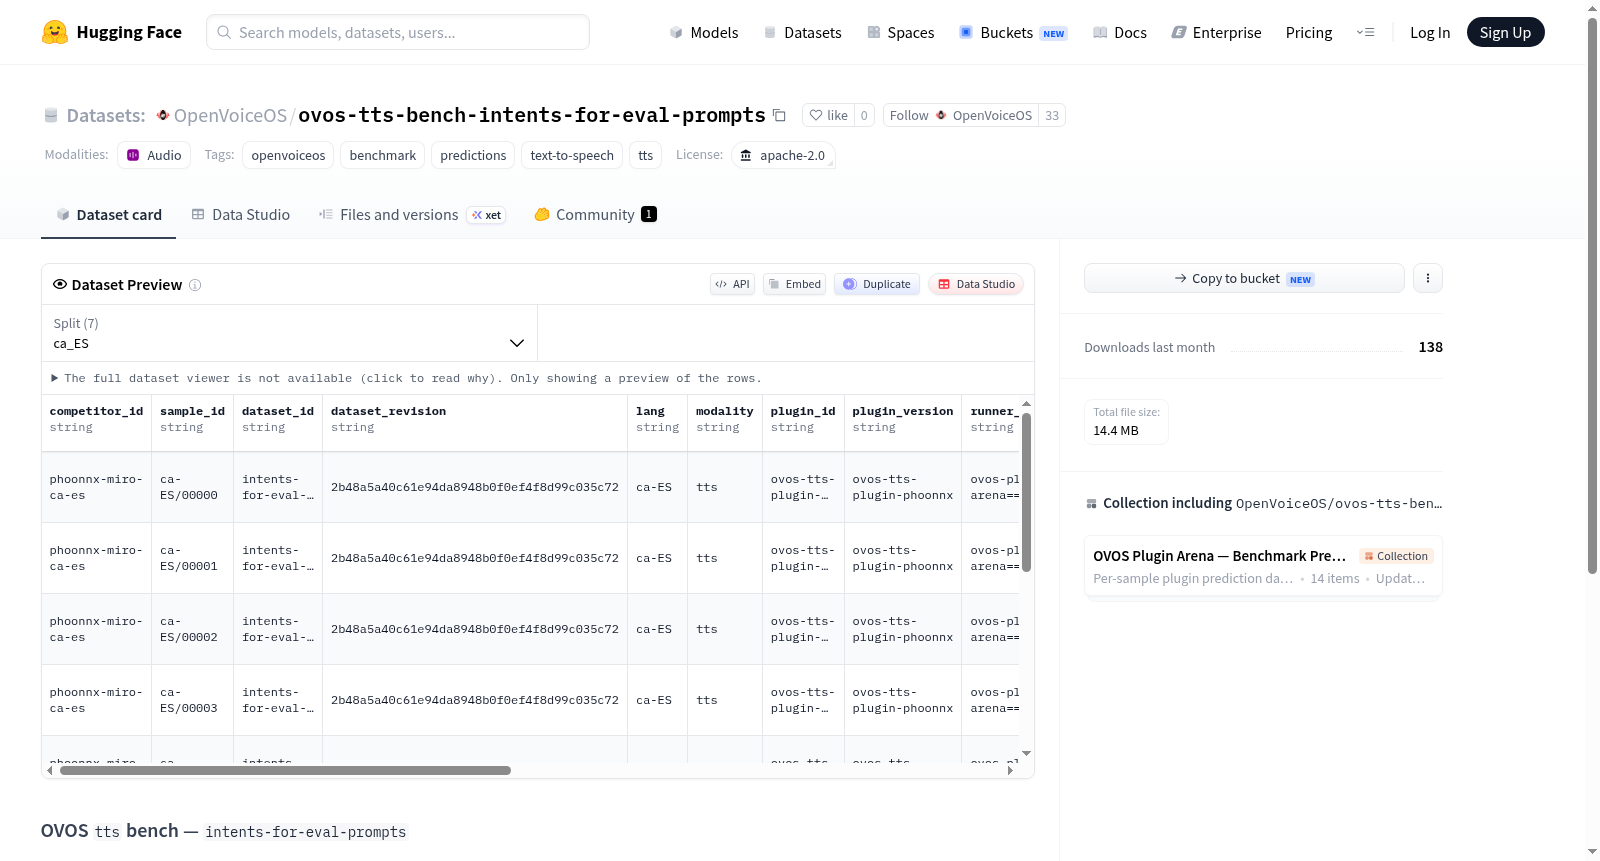
该数据集名为OVOS tts bench — intents-for-eval-prompts,是一个用于文本到语音(TTS)系统基准评估的预测结果集合。它基于OpenVoiceOS/intents-for-eval数据集中的提示,生成了在OVOS Plugin Arena平台上注册的多个TTS模型(称为fighters)的合成音频片段预测,每个提示对应一个音频片段。数据按语言组织,每个语言(如加泰罗尼亚语ca_ES、英语en_US、西班牙语es_ES等)作为一个独立的数据分割,存储为JSONL文件,每个文件对应一个TTS模型竞争者。数据行遵循固定的基准合约,包含数据集版本(dataset_revision)、插件版本(plugin_version)和延迟时间(latency_ms)等字段。数据集通过可复现的基准测试脚本生成,用于构建TTS模型的排行榜、盲测池和基于基准的ELO评分梯子。该数据集由NGI0 Commons Fund/NLnet通过欧盟下一代互联网计划资助,适用于TTS模型性能比较、基准测试和语音合成研究。
The dataset named OVOS tts bench — intents-for-eval-prompts is a collection of predictions for benchmarking text-to-speech (TTS) systems. It is based on prompts from the OpenVoiceOS/intents-for-eval dataset, generating synthetic audio segment predictions for multiple TTS models (referred to as fighters) registered on the OVOS Plugin Arena platform, with each prompt corresponding to an audio segment. Data is organized by language, with each language (e.g., Catalan ca_ES, English en_US, Spanish es_ES, etc.) as a separate data split, stored as JSONL files, each file corresponding to a TTS model competitor. Data rows follow a fixed benchmark contract, including fields such as dataset version (dataset_revision), plugin version (plugin_version), and latency time (latency_ms). The dataset is generated through reproducible benchmark scripts and is used to build leaderboards, blind test pools, and ELO rating ladders for TTS models. It is funded by the NGI0 Commons Fund/NLnet through the European Unions Next Generation Internet program and is suitable for TTS model performance comparison, benchmarking, and speech synthesis research.
数据集概述
数据集名称:OVOS tts bench — intents-for-eval-prompts
许可证:Apache-2.0
标签:openvoiceos, benchmark, predictions, text-to-speech, tts
数据集内容与用途
- 数据集包含针对 OVOS Plugin Arena 注册的 TTS(文本到语音)模型生成的合成音频片段,每个提示(prompt)对应一个片段。
- 数据集基于
OpenVoiceOS/intents-for-eval数据集的提示生成。 - 每个模态对应一个专用仓库;每个语言对应一个数据集划分(split);每个参赛者(fighter)对应一个 JSONL 文件,存放于
predictions/<lang>/<competitor_id>.jsonl。
数据划分与文件结构
- 配置名称:
default - 数据文件路径:
ca_ES:predictions/ca-ES/*.jsonlda_DK:predictions/da-DK/*.jsonlen_US:predictions/en-US/*.jsonles_ES:predictions/es-ES/*.jsonleu_ES:predictions/eu-ES/*.jsonlgl_ES:predictions/gl-ES/*.jsonlpt_PT:predictions/pt-PT/*.jsonl
数据格式与来源
- 每一行数据遵循 Arena 第 3.2 节的约定,包含
dataset_revision、plugin_version、latency_ms字段。 - 数据由可复现的基准测试脚本在 Arena 仓库中生成。
- Arena 的
assemble工作流将这些数据转换为基准排行榜、盲测池和基于基准的 ELO 排名榜。
资金来源
由 NGI0 Commons Fund(通过 NLnet,欧盟资助协议 No 101135429)资助,隶属于欧盟 Next Generation Internet 计划。