
遇见数据集

justtherightsize/it-slama-4

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

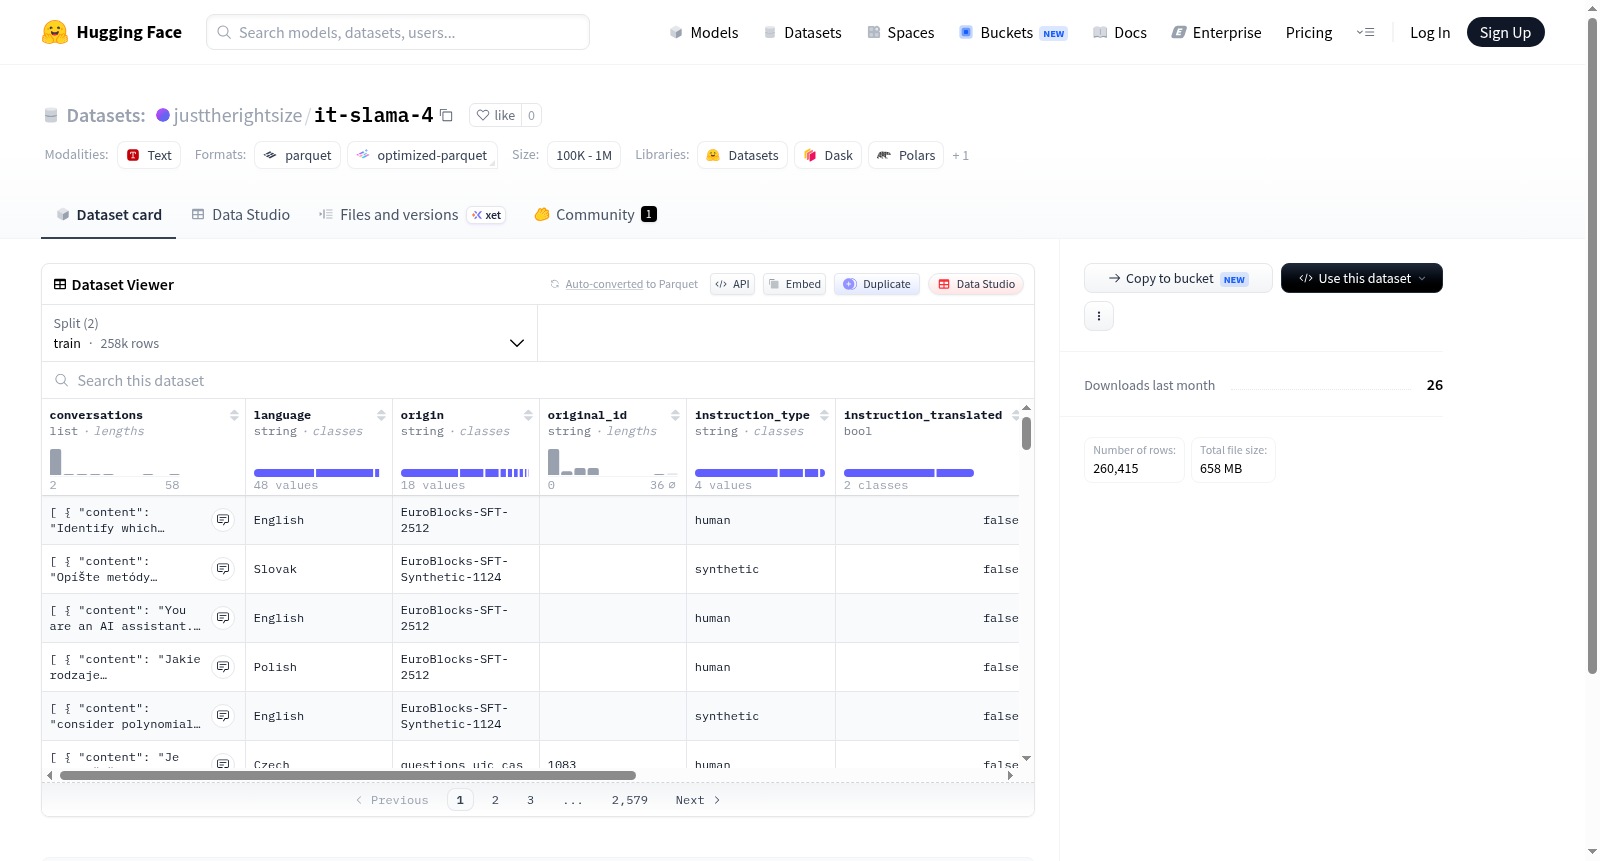
该数据集是一个多语言对话数据集,包含254,637个训练样本和2,573个测试样本,总大小约为674.8 MB。数据集特征包括对话内容(conversations),其中每条对话包含content(文本内容)和role(角色,如用户或助手)字段;language(语言标识);origin(来源信息);original_id(原始ID);instruction_type(指令类型,如提问、编码等);instruction_translated(指示指令是否被翻译);output_type(输出类型);output_translated(指示输出是否被翻译);origin_dataset(原始数据集来源,涵盖多个子集如EuroBlocks-SFT-2512、EuroBlocks-SFT-Synthetic-1124系列、ask_library、bactrian-x-alpaca等);以及lang_group(语言组)。数据集支持多种任务,如问答、创意写作、数学推理、编码等,并可能涉及多语言翻译内容。

This dataset is a multilingual dialogue dataset comprising 254,637 training examples and 2,573 test examples, with a total size of approximately 674.8 MB. The features include conversations (with content and role fields), language, origin, original_id, instruction_type (such as asking for advice, coding, etc.), instruction_translated (indicating whether the instruction is translated), output_type, output_translated (indicating whether the output is translated), origin_dataset (covering multiple subsets like EuroBlocks-SFT-2512, EuroBlocks-SFT-Synthetic-1124 series, ask_library, bactrian-x-alpaca, etc.), and lang_group. The dataset supports various tasks, including question answering, creative writing, mathematical reasoning, coding, and may involve multilingual translated content.
提供机构:
justtherightsize
搜集汇总
数据集介绍
justtherightsize/it-slama-4 数据集图片
构建方式
该数据集名为it-slama-4,是一个意大利语指令微调数据集,其构建融合了多元来源与系统性转换。构建过程中,从众多公开数据集中筛选并整合了涵盖广泛任务类型的指令数据,包括EuroBlocks-SFT系列、bactrian-x、chatcorpus、muri-it系列等三十余个来源,确保了数据的多样性与代表性。每个样本均被转化为统一的对话格式,包含角色与内容字段,并标注了原始来源、指令类型、输出类型、语言及翻译状态等元数据。此外,通过机器翻译将指令与输出转换为意大利语,并对翻译质量进行了标记,形成了大规模的训练集与测试集。
特点
该数据集的核心特点在于其高度结构化与多元化的标签体系。每个样本不仅包含对话内容,还附带了语言、原始数据集标识、指令类型、翻译状态及语言分组等丰富信息,便于进行细粒度的数据筛选与分析。数据集覆盖了从开放问答、头脑风暴到代码生成、数学推理等二十余种指令类别,充分反映了真实应用场景的多样性。其规模可观,训练集含257,810个样本,测试集含2,605个样本,总数据量超过670MB,为意大利语自然语言处理模型的训练提供了坚实的数据基础。
使用方法
使用该数据集时,研究者可直接利用HuggingFace数据集库加载训练与测试分割,进行模型的指令微调或性能评估。其丰富的元数据字段支持灵活的数据过滤,例如可根据语言分组或指令类型选取特定子集,或依据翻译状态识别并排除非人工翻译的样本。数据集的对话格式设计使其可直接适配大多数基于Transformer的指令微调框架,如HuggingFace的Trainer或SFTTrainer,简化了预处理流程。此外,测试集可用于衡量模型在意大利语指令跟随任务上的泛化能力,为模型迭代与对比提供标准化的评估基准。
背景与挑战
背景概述
it-slama-4数据集诞生于多语言自然语言处理与指令微调模型快速发展的背景下,由意大利语社区及研究人员于2024年构建,旨在缓解意大利语高质量指令数据匮乏的瓶颈。该数据集整合了EuroBlocks、Muri-it等多个来源,涵盖超过25万条对话样本,覆盖从开放性问答、代码生成到数学推理等多元任务类型,并辅以语言标注与翻译状态标记,以支持多语言与跨语言模型训练。其核心研究问题聚焦于如何高效聚合异构指令数据,提升意大利语大语言模型的指令遵循能力。作为SLAMA项目的重要组成,该数据集为意大利语模型微调、多语言对齐及低资源语言NLP研究提供了关键基准,对推动意大利语AI生态建设具有里程碑意义。
当前挑战
该数据集面临的挑战多维且复杂。在领域问题层面,其核心难题在于如何通过数据整合提升意大利语模型在指令理解与生成上的泛化能力,涵盖多任务类型(如推理、编码、创意写作)的语义保持与风格一致性,以及跨语言知识迁移中的质量保障。在构建过程中,挑战尤为显著:首先,需从30个异构来源中融合数据,处理格式差异、标签不统一及噪声干扰,确保数据质量;其次,指令翻译需兼顾语言准确性与文化适配性,避免因直译导致的语义偏差;再次,数据规模庞大(约677MB)且类别分布不均,需设计高效过滤策略以平衡各任务占比;最后,测试集与训练集的比例分配需精心划分,以可靠评估模型性能并防止数据泄露。这些挑战共同决定了数据集在支撑鲁棒、可信赖的意大利语指令微调中的效用与局限。
常用场景
经典使用场景
该数据集为意大利语指令微调领域提供了大规模、多样化的对话样本,其核心应用场景聚焦于大语言模型的指令跟随与多轮对话能力训练。研究者可利用其包含的25万余条训练实例,针对意大利语低资源场景进行模型微调,以增强模型在母语语境下的语义理解与生成质量。数据集覆盖广泛的主题,从日常咨询到代码生成,为构建多任务学习基准提供了坚实基础,是评估模型跨任务泛化能力的重要资源。
实际应用
在实际应用中,该数据集可用于开发意大利语智能客服系统、多语言对话代理及本地化内容生成工具。企业可基于此数据微调模型,实现精准的意大利语问答、文档摘要及创意写作辅助,从而提升产品在多语言市场的用户体验。此外,其对于构建教育辅导、信息抽取等垂直应用亦具显著价值,有助于弥补商业模型在意大利语服务上的不足,加速语言技术产业化落地。
衍生相关工作
该数据集衍生出了系列关于多语言指令微调、低资源语言模型增强的研究工作。例如,研究者基于其标注结构探索数据筛选策略,以优化训练子集选择;或借鉴其混合数据构造方法,开发适用于其他罗曼语族语言的类似资源。同时,该数据集常被用作基准,对比不同微调策略(如全参数微调与LoRA)在意大利语上的效果,催生了关于参数高效迁移学习的新见解。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

