
ezhoureal/aura_style
收藏搜集汇总
数据集介绍
构建方式
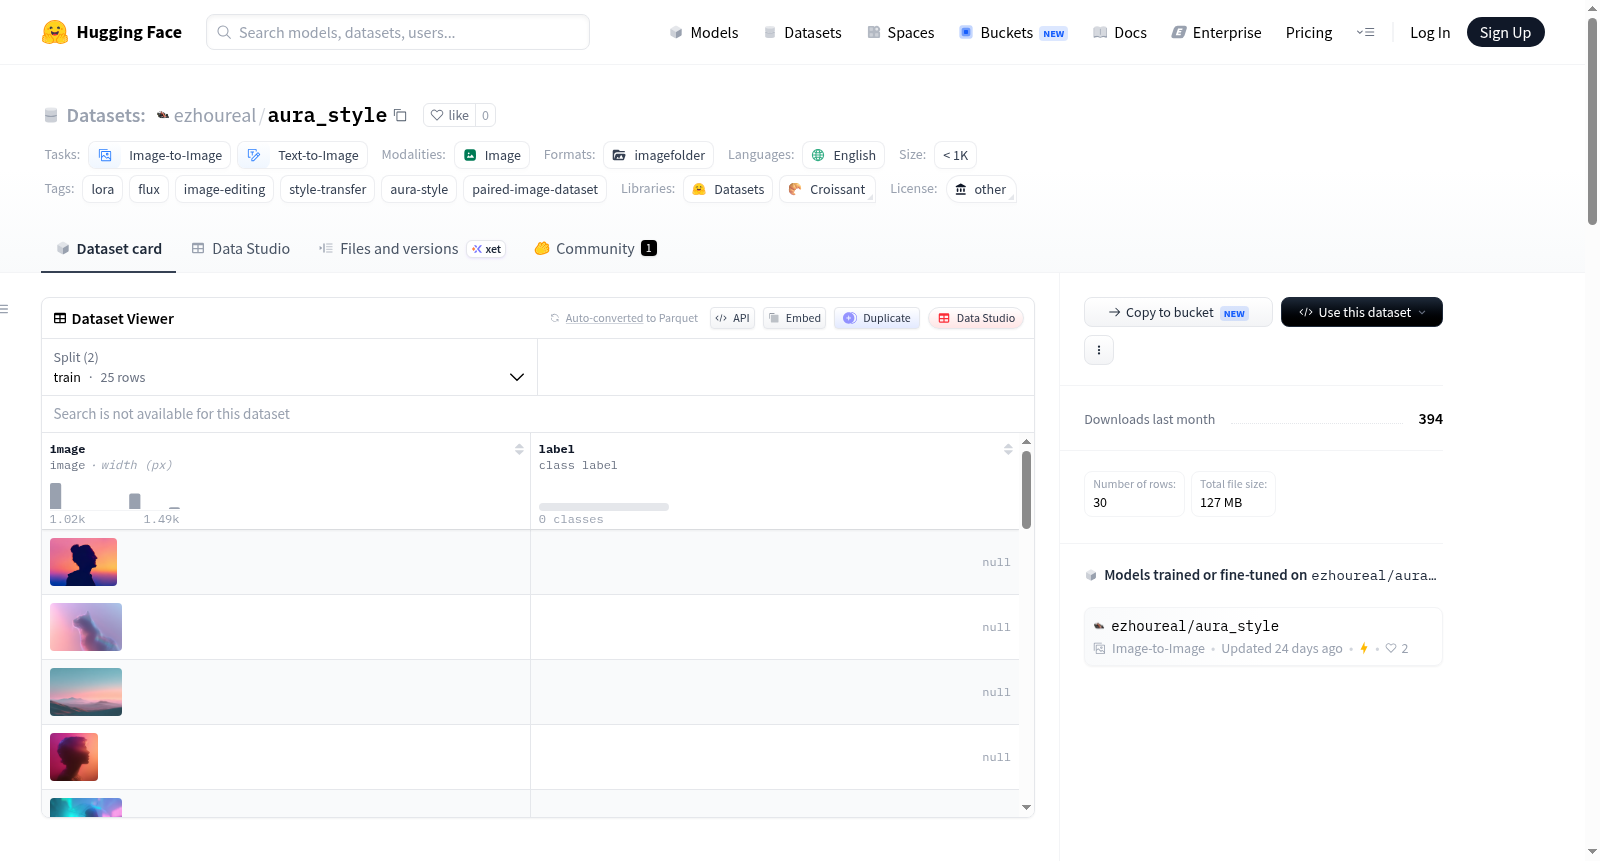
Aura Style配对图像数据集专为风格迁移任务设计,包含25组精心挑选的配对样本。每组数据由三部分组成:位于conditioning文件夹中的原始条件图像、train文件夹中对应的风格化目标图像,以及描述目标风格的文本提示。数据集采用标准化的JSONL格式记录元数据,每行包含文件名、提示词、记录类型及条件图像的相对路径,便于程序化访问与处理。图像尺寸涵盖1024×1024、1344×896及1486×1058等多种分辨率,以适应不同训练需求。
特点
该数据集的核心特色在于其聚焦于一种独特的发光光环照明风格,旨在学习将普通图像转换为充满色彩渐变、朦胧薄雾、轮廓光晕及电影般光辉的艺术效果。尽管规模较小,但每对样本都经过精心设计,确保风格一致性。数据集中标注了配对类型和来源标签,为训练LoRA或图像编辑模型提供了清晰的结构化信息,特别适合在小样本条件下实现稳定的风格迁移效果。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,使用load_dataset函数即可获取训练集。对于条件图像的加载,需根据元数据中的conditioning_path字段,结合PIL库从相对路径读取。推荐将其作为ImageFolder数据集使用,通过accelerate启动LoRA训练脚本,并指定caption_column参数为prompt。该数据集专为LoRA微调与风格迁移实验设计,适合进行快速原型验证与可控的图像编辑研究。
背景与挑战
背景概述
在图像生成与风格迁移领域,基于文本引导的图像编辑技术近年来备受关注,尤其是通过低秩适应(LoRA)等方法实现特定风格的高效迁移。Aura Style配对图像数据集由研究者ezhoureal创建,旨在支持模型学习将源图像转化为一种具有辐射光晕风格的图像,该风格以鲜艳色彩渐变、朦胧雾气、轮廓光及电影般辉光为特征。数据集包含25对训练样本,图像分辨率涵盖1024×1024、1344×896及1486×1058,为控制性风格迁移实验提供了精炼的数据基础。该数据集虽规模小巧,但在LoRA训练与图像编辑模型的针对性调优中展现出独特价值,推动了特定美学风格在生成式模型中的可控表达。
当前挑战
该数据集面临的挑战主要体现在两个层面。在领域问题层面,它致力于解决风格迁移中特定光照效果(如光晕风格)的难以精确复现与泛化问题,现有模型常因缺乏配对数据而难以捕捉光源方向、色彩渐变与轮廓光等细腻特征。在构建过程中,数据集规模仅25对样本,远低于通用数据集,限制了模型对复杂场景的泛化能力;同时,图像尺寸不一(从1024×1024到1486×1058),需在设计训练流程时适配不同分辨率带来的计算与对齐复杂性;此外,数据集依赖手动配对与标注,确保源图像与目标风格图像在语义上的一致性也是一大挑战,尤其是面对非标准光照条件下的样本时,标注的可靠性直接影响训练效果。
常用场景
经典使用场景
Aura Style配对图像数据集专为图像到图像与文本到图像的风格迁移任务而设计,其核心应用在于训练LoRA或图像编辑模型以生成具有辐射光晕风格的图像。该数据集包含25组配对样本,每组由条件图像、目标风格图像及描述性提示词构成,覆盖1024x1024至1486x1058等多种分辨率,为风格迁移模型的微调提供了精准的监督信号。在学术研究与工程实践中,研究者可基于此数据集构建从普通图像到光晕美学风格的映射关系,探索梯度渐变、雾状光晕、轮廓光效与电影般发光效果等视觉特征的合成机制,从而推动受控风格迁移领域的发展。
解决学术问题
该数据集有效解决了风格迁移研究中高质量配对数据稀缺的难题,特别是在辐射光晕这类高度风格化且非写实的视觉效果领域。通过提供对齐精确的条件-目标图像对,它使得研究能够聚焦于模型对光影动态、色彩渐变与空间氛围的感知与重构能力,而非数据预处理。该数据集的公开促进了LoRA微调技术在轻量化风格迁移中的实证研究,为验证模型在有限样本下的泛化性能与过拟合抑制策略提供了标准化基准,对理解扩散模型中的风格编码与条件控制机制具有重要学术意义。
衍生相关工作
该数据集衍生了一系列基于LoRA与扩散模型的风格迁移研究工作,包括探索不同基础模型(如FLUX架构)在Aura Style上的适配能力,以及针对少量配对样本开发的数据增强与正则化技术。同时,相关研究拓展了数据集的规模与多样性,通过合成生成与人工标注构建了更大规模的光晕风格集合,进而催生了多风格融合与可控强度调节的模型变体。此类工作不仅验证了Aura Style作为风格迁移测试床的有效性,也为图像编辑领域的下游任务如语义引导光效叠加、跨图像风格一致性保持等奠定了方法基础。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


