遇见数据集

alea-schema-mapping

收藏
Hugging Face2026-10-31 更新2026-11-01 收录
官方服务:

资源简介:

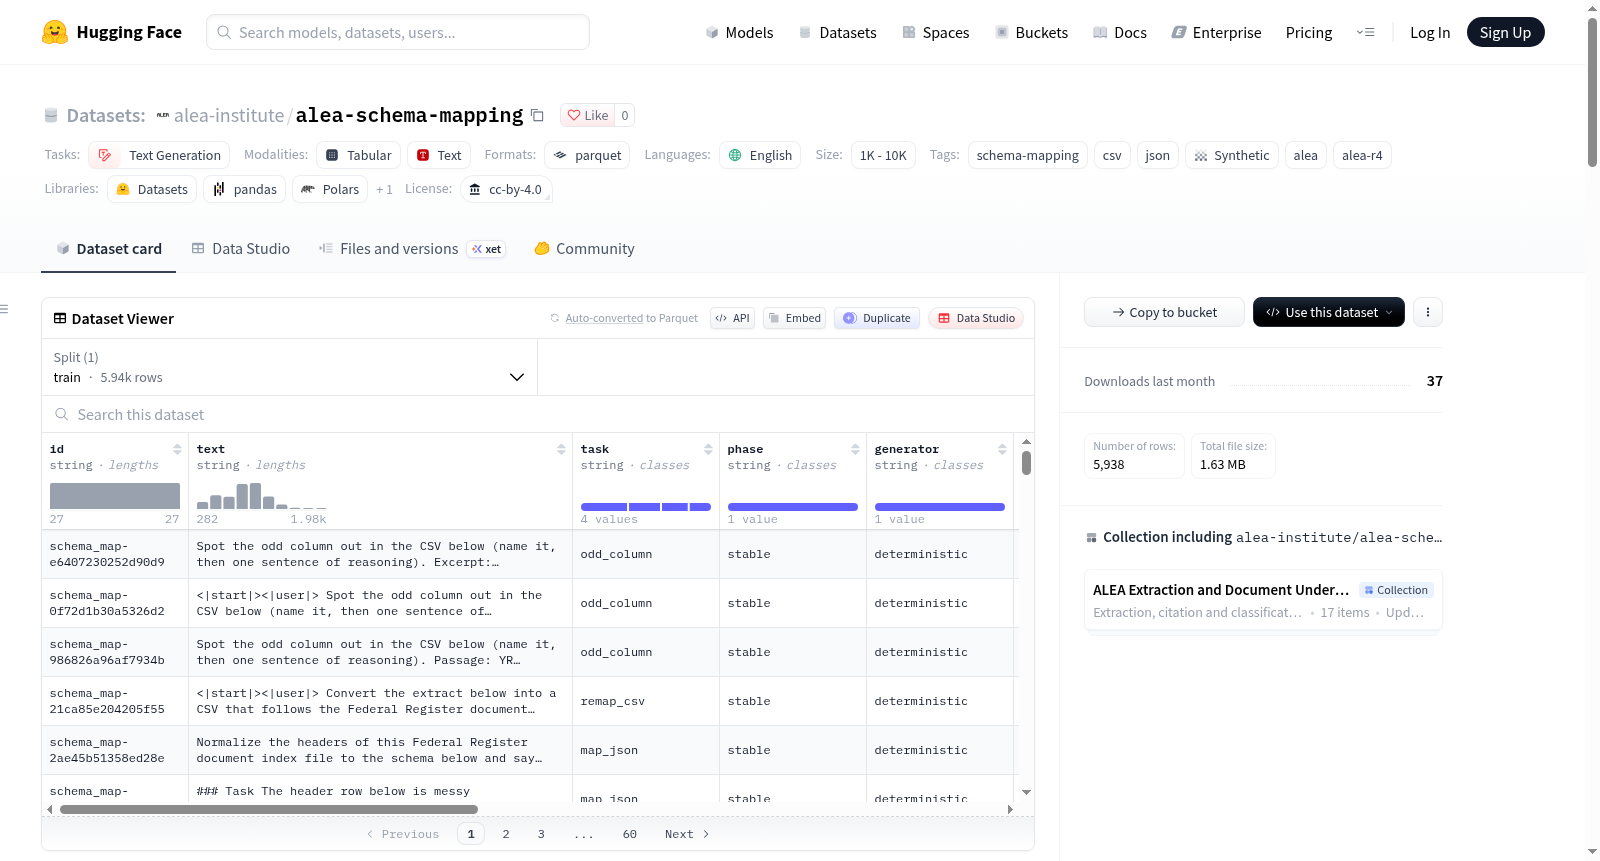
ALEA schema mapping 是一个用于模式映射任务的合成数据集。其目标是将混乱的电子表格列(包括大小写和分隔符变体、拼写错误、重新排序、多余列和缺失列)映射到八种虚构公共部门记录类型的目标模式:法院案件、合同授予、建筑许可、拨款、食品安全检查、房产税、联邦公报索引和车队车辆。数据集包含四种任务:将列映射为JSON(含缺失字段)、将CSV重写为模式、将表单映射为含空值的模式JSON、从无关记录类型中识别列。数据由确定性代码从类型化记录生成,未使用语言模型;源数据是带有手工编写字段别名的虚构类型化记录。最终版本有5,938份文档、1,964,391个token(使用ALEA R4分词器alea-v2b-sw32k计数,包含每文档开始和结束token)。数据集经过两次修订:最初22,755份文档、8,816,405 token,第一次修订为8,979份文档、3,061,177 token,第二次修订为5,938份文档、1,964,391 token。移除的行含生成器名称池中的姓氏、组织名称和虚构地名,这些名字在数百到数千份文档中重复;移除原因是防止模型学习名称而非任务;移除仅检测,整行删除,无文本编辑,剩余行与原始发布字节相同。最终任务分布:map_json 2,162份,form_map 1,046份,remap_csv 1,483份,odd_column 1,247份;8,069份文档使用ALEA聊天模板。字段包括:id(生成器行ID,可能不唯一)、text(训练文本,聊天文档使用ALEA聊天模板,控制token以文本形式出现)、task(任务类型)、phase(stable,表示在R4稳定预训练混合中训练)、generator(写入行的方法,deterministic表示仅代码)、group_id(源段落/记录组,同组变体共享)、prompt_chars(请求部分字符长度,纯文档为0,未记录为null)、n_tokens(alea-v2b-sw32k下token数,含开始和结束token)、text_sha256(text的SHA-256)、meta(JSON,含生成器结构化字段:源、呈现、答案形式、金标值、检查)。该数据集属于ALEA R4训练混合,包含R4模型在稳定预训练混合中训练过的该家族文档(第二阶段,每个一次通过),每行与训练文本字节相同。验证包括:重写CSV答案解析回并与类型化记录比较;别名在每个模式内唯一;去污染:移除与留出评估项共享词13-gram的训练行及重叠ALEA评估集的行;抽样记录由独立审查者盲审,重新计算或推导答案,缺陷在最终构建前修复或删除。已知限制:文档为生成式,比自然文本更重复。许可:汇编和生成文本为CC-BY-4.0;公共领域和公共记录源文本保持其状态;Wikidata为CC0;OpenGloss和SHELF为CC-BY-4.0。由ALEA Institute发布。HuggingFace任务类别为text-generation,语言为英语,标签包括schema-mapping、csv、json、synthetic、alea、alea-r4。

ALEA schema mapping is a synthetic dataset for schema mapping tasks, designed to map messy spreadsheet columns (including case and delimiter variants, typos, reordering, extra and missing columns) to target schemas of eight fictional public-sector record types: court cases, contract awards, building permits, grants, food safety inspections, property taxes, Federal Register indices, and fleet vehicles. It contains four tasks: mapping columns to JSON (with missing fields), rewriting CSV to schema, mapping forms to schema JSON with null values, and identifying columns from unrelated record types. The dataset is generated deterministically by code from typed records, without using language models; source data are fictional typed records with hand-written field aliases. The final version contains 5,938 documents and 1,964,391 tokens (counted with the ALEA R4 tokenizer alea-v2b-sw32k, including start and end tokens per document). It was revised twice: originally 22,755 documents and 8,816,405 tokens, the first revision reduced this to 8,979 documents and 3,061,177 tokens, and the second revision further reduced it to 5,938 documents and 1,964,391 tokens. Removed rows contained names from the generator name pools (surnames, organization names, and fictional place names), which repeated across hundreds to thousands of documents; the removal was to prevent models from learning names rather than tasks. Removal was detection-only: entire rows were deleted with no text edits, and remaining rows are byte-identical to the original release. Final task distribution: map_json 2,162, form_map 1,046, remap_csv 1,483, and odd_column 1,247. The README notes that 8,069 documents use the ALEA chat template. Columns include: id (generator row ID, may not be unique), text (training text; chat documents use the ALEA chat template; control tokens appear as text), task (task type), phase (stable, indicating training in the R4 stable pretraining mix), generator (method used to write the row; deterministic means code only), group_id (source passage/record group; variants from the same group share it), prompt_chars (character length of the request part; 0 for pure documents; null if not recorded), n_tokens (token count under alea-v2b-sw32k, including start and end tokens), text_sha256 (SHA-256 of text), meta (JSON containing structured generator fields: source, presentation, answer form, gold value, checks). The dataset belongs to the ALEA R4 training mix and contains documents from this family that the R4 model was trained on in the stable pretraining mix (second stage, each seen once); each row is byte-identical to the training text. Validation includes: rewritten CSV answers are parsed back and compared with typed records; aliases are unique within each schema; decontamination removes training rows that share word 13-grams with held-out evaluation items and rows overlapping ALEA evaluation sets; sampled records are blind-reviewed by independent reviewers, answers recomputed or derived, and defects fixed or removed before final build. Known limitation: documents are generative and more repetitive than natural text. License: the compilation and generated text are under CC-BY-4.0; public domain and public record source texts remain their status; Wikidata is CC0; OpenGloss and SHELF are CC-BY-4.0. Published by the ALEA Institute. HuggingFace task category is text-generation, language is English, and tags include schema-mapping, csv, json, synthetic, alea, and alea-r4.

创建时间:
2026-10-20
原始信息汇总

ALEA schema mapping 数据集概述

基本信息

  • 数据集页面:https://huggingface.co/datasets/alea-institute/alea-schema-mapping
  • pretty_name:ALEA schema mapping
  • 许可证:cc-by-4.0
  • 语言:en
  • 任务类别:text-generation
  • 大小类别:10K<n<100K
  • 标签:schema-mapping、csv、json、synthetic、alea、alea-r4
  • 配置:config_name 为 default;split 为 train;训练分片文件模式为 https://huggingface.co/datasets/alea-institute/alea-schema-mapping/tree/main/data/train-*.parquet

数据集内容与任务

  • 将混乱电子表格列映射到目标 schema,列包含大小写和分隔符变体、拼写错误、重排、额外和缺失列。
  • 面向八种虚构公共部门记录类型:法院案件、合同授予、建筑许可、拨款、食品安全检查、财产税、联邦公报索引、车队车辆。
  • 任务类型:
    • 含缺失字段的 JSON 列映射。
    • CSV 重写为 schema。
    • 表单到含 null 的 schema JSON。
    • 从无关记录类型中识别列。
  • 最终版本规模:5,938 个文档,1,964,391 个 token。
  • token 使用 alea-v2b-sw32k,即 ALEA R4 tokenizer,并计入每个文档的开始和结束 token。

修订记录

2026-10-31 第一次修订

  • 文档数从 22,755 减少至 8,979。
  • token 数从 8,816,405 减少至 3,061,177。
  • 移除文本中包含 65 个填充姓氏或 1,575 个组织名称,以及姓氏 Olander 的行;这些名称来自小固定池并在数据中重复。
  • 原因:被移除文档使用来自小固定池的虚构组织和人物。
  • 任务文档数变化:
task before after
map_json 8,458 3,039
remap_csv 5,988 2,093
form_map 4,179 2,243
odd_column 4,130 1,604
  • 移除方式为仅检测:整行删除,不编辑文本,剩余行与最初发布行字节一致。
  • 早期版本仍可在数据集历史中获取。
  • 卡片其他地方描述全集的计数和数字指原始发布,除非在修订章节重述。

2026-10-31 第二次修订

  • 文档数从 8,979 减少至 5,938。
  • token 数从 3,061,177 减少至 1,964,391。
  • 移除文本中包含生成器名称池中名称的行,作为完整单词匹配;名称池包括姓氏、组织名称和虚构地名,来自小固定列表并跨许多文档重复。
  • 名称池为数据集生成器池的并集,减去真实公共记录文本中常见的姓氏。
  • 原因:每个池名称在数百到数千个文档中重复,模型会学习名称而非任务。
  • 剩余行不包含这些池名称;剩余文本未被编辑。
  • 任务文档数变化:
task before after
map_json 3,039 2,162
form_map 2,243 1,046
remap_csv 2,093 1,483
odd_column 1,604 1,247
  • 移除方式为仅检测:整行删除,不编辑文本,剩余行与最初发布行字节一致。
  • 早期版本仍可在数据集历史中获取。

ALEA R4 训练混合

  • 该数据集包含 ALEA R4 模型在其稳定预训练混合中训练的这个家族的文档;该混合为第二数据阶段,各一遍。
  • 每行与训练文本字节一致;text_sha256 是 text 的 SHA-256。
  • 由相同代码生成的留出评估项不在此发布中。

组成(原始发布)

task documents tokens
map_json 8,458 3,550,764
remap_csv 5,988 3,017,250
form_map 4,179 1,230,645
odd_column 4,130 1,017,746
  • 8,069 个文档使用 ALEA 的 chat template。

制作方式

  • 由确定性代码从 typed records 编写。
  • 未使用语言模型。
  • 每个 frame 说明其 null、empty、drop 约定。

来源

  • 带有手写字段别名的发明 typed records。

验证

  • 重写 CSV 答案被解析回并与 typed records 比较;别名在每个 schema 内唯一。
  • 去污染:与留出评估项共享词 13-gram 的训练行被移除;与 ALEA 评估集重叠的行被移除或记录,依据 ALEA 的去污染政策。
  • 抽样记录由独立评审员盲审,重算或重新推导答案;评审中发现的缺陷模式在最终构建前在生成器中修复,或删除受影响行。

列

column content
id 生成器中的行 id;不总是唯一:少数家族跨变体复用 id,少量完全重复文档被训练两次并出现两次
text 与训练完全一致的文档;chat 文档使用 ALEA 的 chat template,控制 token 作为文本出现:`<
task 任务类型
phase stable,表示在 R4 稳定预训练混合中训练
generator 编写该行的组件;deterministic 表示仅代码
group_id 源 passage 或 record group;一个组的所有变体共享该值
prompt_chars text 中请求部分的字符长度;普通文档为 0;未记录处为 null
n_tokens 在 alea-v2b-sw32k 下的 token 数,包括文档开始和结束 token
text_sha256 text 的 SHA-256
meta JSON:生成器的结构化字段,包括 source、presentation、answer form、gold values、checks

已知限制

  • 文档是生成的,比自然文本更重复。

许可与发布

  • 本编译和生成文本的许可证:CC-BY-4.0。
  • 公共领域和公共记录源文本保持其状态。
  • Wikidata 为 CC0。
  • OpenGloss 和 SHELF 为 CC-BY-4.0。
  • 发布者:ALEA Institute,https://aleainstitute.ai
搜集汇总
数据集介绍
alea-schema-mapping 数据集图片
构建方式
在异构公共记录与规范数据模式之间建立可靠映射,构成数据治理与语义集成的关键环节。该数据集由确定性代码从虚构类型化记录中生成,全程未调用语言模型;八类公共部门记录涵盖法院案件、合同授予、建筑许可、资助、食品安全检查、财产税、联邦公报索引与车队车辆,手写字段别名支撑模式映射、CSV重写、表单转模式JSON及无关列识别。生成器逐帧申明空值、空缺与丢弃约定。两轮修订依姓氏、组织名及虚构地名池实施整行检测删除,余留行保持字节一致;该家族被纳入ALEA R4稳定预训练混合,并经过重写回读比对、别名唯一性与13元词去污染核验。
特点
面向模式映射的合成语料,其价值深植于真实公共数据整合中列名歧义、拼写差异与结构错位等症结。当前版本含5,938份文档与1,964,391个alea-v2b-sw32k词元,覆盖map_json、remap_csv、form_map、odd_column四类任务;部分文档采用ALEA聊天模板,并以id、text、task、phase、generator、group_id、prompt_chars、n_tokens、text_sha256及meta等字段记录来源、呈现形式、答案形态与校验信息。经两轮姓名池过滤与去污染处置,数据重复性趋降且与评估集重叠受控,然其合成属性令文本较自然语料更显规整复现。
使用方法
围绕文本生成范式,该数据集适用于模式映射、列语义对齐与结构化答案生成模型的训练及评测。使用时可直接读取train分区的Parquet文件,以text字段作为模型输入,按task区分映射JSON、重写CSV、表单转模式JSON与异常列识别等目标;若采用ALEA聊天模板,需保留<|start|>、<|system|>、<|user|>、<|assistant|>、<|eot|>、<|end|>等控制标记。meta字段载有金标值与检查信息,便于监督解析与答案回验。鉴于其已参与R4稳定预训练,评估应严格排除训练行,并遵循CC-BY-4.0许可与去污染约定。
背景与挑战
背景概述
在公共部门记录自动化与表格理解研究中,ALEA schema mapping由ALEA Institute发布,并于2026年10月31日经历两轮修订,作为ALEA R4稳定预训练配方的组成部分。其核心研究问题在于把八类虚构公共部门记录(法院案件、合同授予、建筑许可、拨款、食品安全检查、财产税、联邦公报索引与车队车辆)的杂乱电子表格列映射至目标模式,涵盖列映射JSON、CSV重写、表单到模式JSON及无关列识别等任务。该数据集以确定性代码生成,共5,938份文档、1,964,391词元,为模式映射与结构化文本生成提供可控且可复现的训练资源,并推动表格语义对齐研究。
当前挑战
面向异构电子表格的模式映射需应对列名大小写与分隔符变体、拼写错误、列重排以及多余或缺失列,目标模式又要求模型在JSON、CSV与表单表示间保持语义一致,这构成其解决的核心领域问题。构建过程中,生成器使用小型固定姓名与机构池,导致模型易记忆名称而非习得映射规则,故两轮修订移除含池名行,文档由22,755降至8,979再降至5,938,且保持剩余行字节不变。数据还须经CSV回解校验、别名唯一性检查、13-gram去污染与盲审复核;生成文本相对自然语料更重复、模式固定,亦为泛化评估带来限制。
常用场景
经典使用场景
在异构表格集成与模式匹配的研究脉络中,alea-schema-mapping 的经典使用场景聚焦于将杂乱电子表格列映射至目标模式。该数据集覆盖法院案件、合同授予、建筑许可、拨款、食品安全检查、财产税、联邦公报索引与车队车辆八类虚构公共部门记录,任务包括以 JSON 输出含缺失字段的列映射、将 CSV 重写为既定模式、把表单转换为带 null 值的模式 JSON,以及识别来自无关记录类型的异常列。模型需处理大小写与分隔符变体、拼写错误、列重排、多余或缺失列,从而学习稳健的列对齐与结构化生成。其文本即 ALEA R4 稳定预训练混合的逐字节训练内容,亦可用作监督微调与评测基准。
解决学术问题
面对开放政府数据与数据湖中普遍存在的模式异质性,alea-schema-mapping 回应了自动化模式匹配中标注稀缺、语义歧义与鲁棒性评估不足等问题。传统规则或字典方法难以应对列名变体、拼写噪声、字段缺失和跨记录类型干扰,而该数据集以确定性代码从类型化记录生成大规模监督样本,提供字节级可复现文本与结构化元数据,便于研究模型的列映射、CSV 重写、表单规范化与异常检测能力。其意义在于把模式映射从人工启发式推向可训练、可测度的语义解析任务,并为减少公共记录整合中的人工成本、提升跨系统互操作与数据质量提供实验基础。
衍生相关工作
围绕 alea-schema-mapping 的衍生工作,最直接者是其作为 ALEA R4 稳定预训练混合组成部分所支撑的 ALEA R4 模型,该模型在第二阶段以单遍方式学习这些逐字节训练文本。数据集还提供同源代码生成的留出评估项,虽未随发布释出,却构成同源评测与去污染流程的基础。其四类任务设计亦启发后续表格语义解析、列类型推断、CSV 到模式重写及表单规范化研究,成为比较模式匹配方法与结构化生成模型的参考资源。在开放数据与记录管理领域,这些衍生工作推动可复现基准与自动化数据集成工具的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

