cbasu/Med-EASi
收藏资源简介:
Med-EASi(医学文本精细和抽象简化数据集)是一个独特的众包和精细标注的数据集,用于监督简化短篇医学文本。它包含1979对专家-简化文本对,涵盖了4478个UMLS概念,并标注了四种文本转换:替换、扩展、插入和删除。数据集可用于直接生成简化医学文本或生成具有可控性的简化文本。数据集结构包括训练集、验证集和测试集,并提供了多种度量指标。数据集创建过程中使用了专家-外行-AI协作的方式进行标注。
Med-EASi(医学文本精细和抽象简化数据集)是一个独特的众包和精细标注的数据集,用于监督简化短篇医学文本。它包含1979对专家-简化文本对,涵盖了4478个UMLS概念,并标注了四种文本转换:替换、扩展、插入和删除。数据集可用于直接生成简化医学文本或生成具有可控性的简化文本。数据集结构包括训练集、验证集和测试集,并提供了多种度量指标。数据集创建过程中使用了专家-外行-AI协作的方式进行标注。
Dataset Card for Med-EASi
Dataset Description
- Repository: https://github.com/Chandrayee/CTRL-SIMP
- Paper: https://arxiv.org/pdf/2302.09155.pdf
- Point of Contact: Chandrayee Basu
Dataset Summary
Med-EASi (Medical dataset for Elaborative and Abstractive Simplification) is a crowdsourced dataset containing 1979 expert-simple text pairs in the medical domain, with 4478 UMLS concepts. It is annotated with four textual transformations: replacement, elaboration, insertion, and deletion.
Supported Tasks
The dataset supports the generation of simplified medical text and controllability over individual transformations.
Languages
English
Dataset Structure
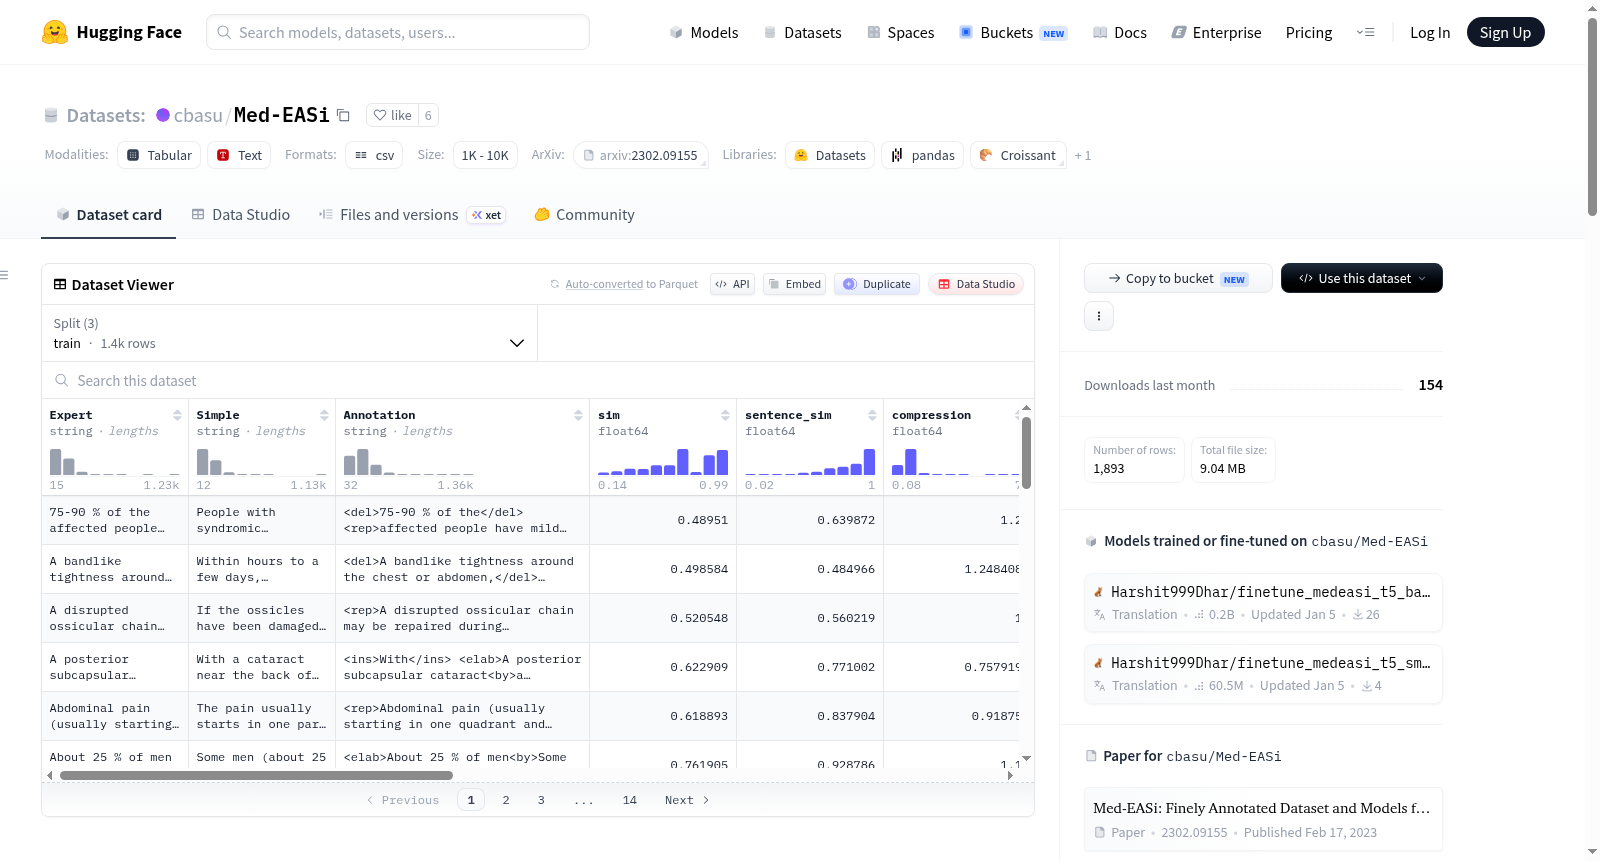
- train.csv: 1397 text pairs (5.19 MB)
- validation.csv: 197 text pairs (1.5 MB)
- test.csv: 300 text pairs (1.19 MB)
Metrics provided include Levenstein similarity, SentenceBERT embedding cosine similarity, compression ratio, Flesch Kincaid readability grade, and automated readability index for each text pair.
Data Instances
Example of an annotated text pair showing transformations.
Data Fields
- Expert
- Simple
- Annotation
- sim (Levenstein Similarity)
- sentence_sim (SentenceBERT embedding cosine similarity)
- compression
- expert_fk_grade
- expert_ari
- layman_fk_grade
- layman_ari
- umls_expert
- umls_layman
- expert_terms
- layman_terms
- idx (original data index before shuffling, redundant)
Data Splits
75% train, 10% validation, and 15% test.
Dataset Creation
Created by annotating 1500 SIMPWIKI data points and all MSD data points using expert-layman-AI collaboration.
Personal and Sensitive Information
No personal or sensitive information is included.
Considerations for Using the Data
Discussion of Biases
Contains biomedical and clinical short texts.
Other Known Limitations
Expert and simple texts were extracted and aligned using automated methods with inherent limitations.