
pleaseconnectwifi/3DQA
收藏官方服务:
资源简介:
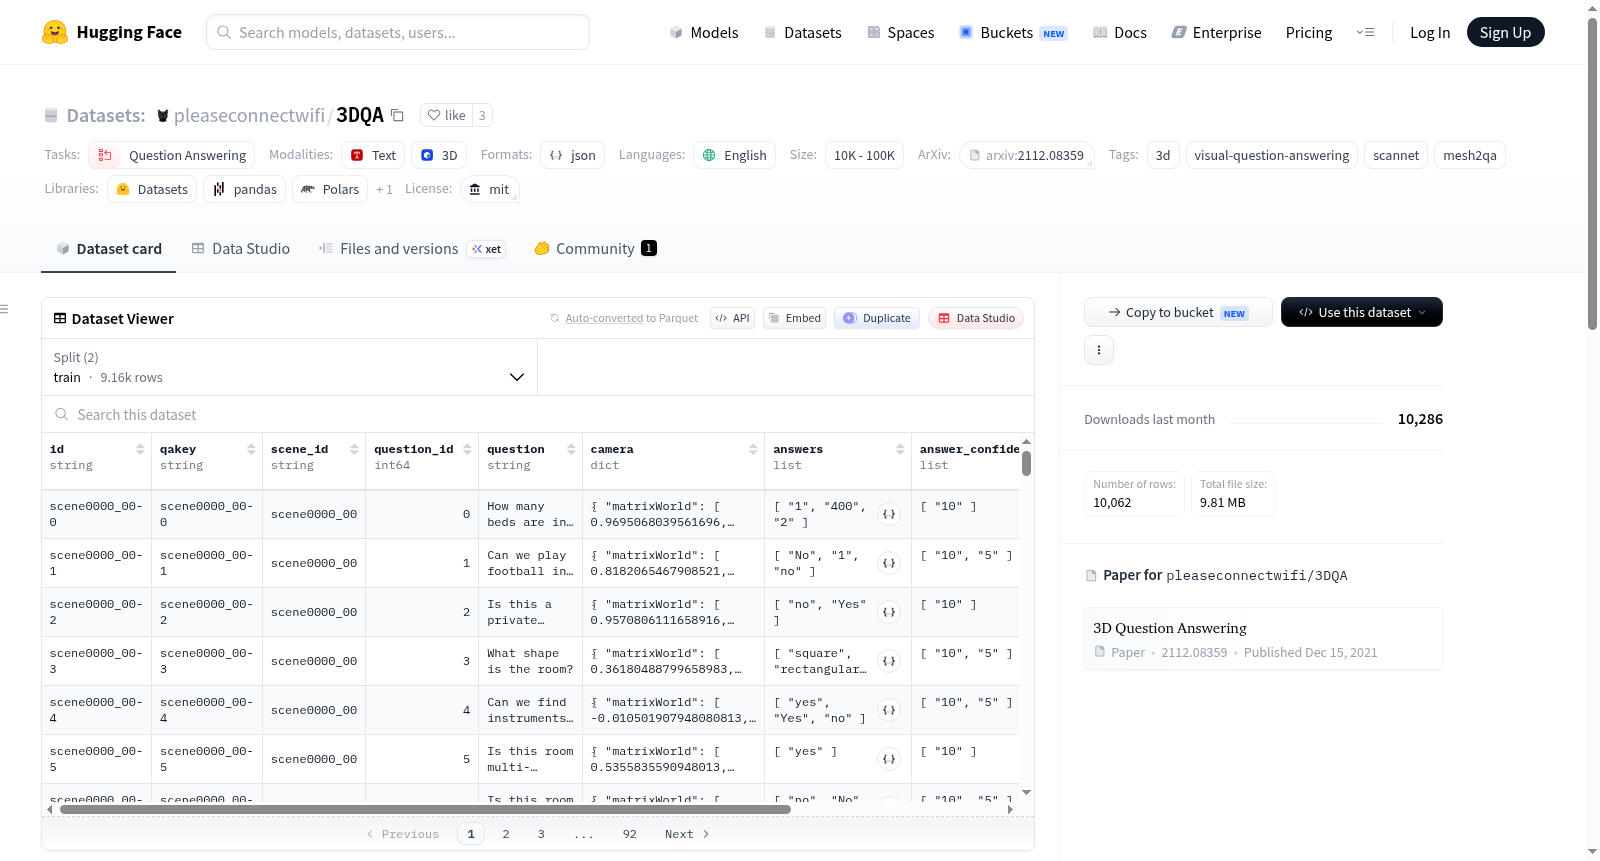
这是一个Hugging Face数据集查看器就绪的JSONL导出,用于Shuquan Ye、Dongdong Chen、Songfang Han和Jing Liao的3D问答项目。该数据集基于ScanNet场景,支持3D视觉问答任务,包含问题和答案数据,用于训练和测试模型。
This is a Hugging Face Dataset Viewer-ready JSONL export for the 3D Question Answering project by Shuquan Ye, Dongdong Chen, Songfang Han, and Jing Liao. It is based on ScanNet scenes and supports 3D visual question answering tasks, including question and answer data for training and testing models.
提供机构:
pleaseconnectwifi搜集汇总
数据集介绍
构建方式
3DQA数据集源自Shuquan Ye等人提出的3D Question Answering项目,旨在推动三维视觉与自然语言处理的交叉研究。该数据集基于ScanNet场景构建,通过将原始训练集与验证集合并,形成包含9160个样本的训练分片,涵盖scene0000_00至scene0706_00的场景序列;测试分片则包含902个样本,来自scene0707_00至scene0806_00。数据以JSONL格式存储,每条记录包含唯一标识符、场景ID、问题元数据、视角信息、答案及置信度等字段,确保多模态问答任务的完整性。
特点
该数据集的核心特点在于其三维视觉问答的专门化设计:每个样本关联一个具体的ScanNet三维场景,并通过问题-答案对的形式检验模型对空间、物体关系及上下文的推理能力。数据集中包含多个视角的相机参数和答案标注,支持从单一视角到多视角的评估范式。此外,由于部分云文件丢失,训练与验证集无法严格区分,但整体保持了与原始项目一致的场景划分策略,测试块独立而训练与验证合并,增强了数据利用的灵活性。
使用方法
使用3DQA数据集时,用户可通过Hugging Face Datasets库加载默认配置,直接获取train和test两个分片的JSONL文件。每条样本中的问题字段可供模型输入,答案及置信度字段用于监督学习或评估。开发者可结合项目官方代码(GitHub)中的处理管道,将三维场景特征与问题嵌入融合,进行端到端的问答训练。建议注意视角元数据的使用,以支持多视角推理实验,并参考原始论文中的评估指标来验证模型性能。
背景与挑战
背景概述
3D视觉问答任务旨在使机器能够理解三维场景并回答与之相关的自然语言问题,是计算机视觉与自然语言处理交叉领域的前沿方向。该数据集由舒权叶、陈冬冬、韩松芳和廖静等研究人员于2021年创建,基于ScanNet场景数据构建,核心研究问题在于如何让模型在三维空间中感知物体、空间关系及语义信息,并据此生成准确答案。3DQA数据集填补了三维视觉问答领域标注数据的空白,为评估和推动模型在复杂三维环境下的推理能力提供了关键基准,对促进智能机器人、增强现实等应用的发展具有重要意义。
当前挑战
该数据集面临的挑战主要体现在三方面:首先,三维视觉问答本身需解决从三维点云或网格中提取几何与语义特征、并与自然语言问题对齐的跨模态难题,这比二维图像问答更具复杂性。其次,构建过程中面临标注困难,三维场景的问答对需要精细的空间关系定义和人类标注,且数据量有限(训练集约9160例,测试集902例),难以覆盖所有复杂场景。此外,由于部分云端文件丢失,原始训练集与验证集无法区分,需合并处理,这增加了模型性能评估的不确定性。
常用场景
经典使用场景
在三维视觉与自然语言处理交叉领域,3DQA数据集作为首个大规模三维场景问答基准,经典使用场景聚焦于引导模型在复杂室内环境中理解空间语义与物体关系。研究者利用ScanNet场景中的网格数据,结合多样化的问答对,训练模型回答涉及物体识别、空间定位、属性判别及行为推理等类型的问题。该数据集为三维场景理解引入了语言交互维度,使得模型不仅需感知三维结构,还需对齐视觉信息与文本表征,从而推动了多模态感知与推理能力的深度融合。
实际应用
在实际应用层面,3DQA数据集为智能机器人导引、增强现实交互及无障碍辅助系统等场景提供了关键支撑。例如,服务机器人可通过该数据集训练的模型,回答用户关于环境中物体位置与状态的实时询问,实现更加自然的指令理解。在室内导航与辅助生活中,模型能够基于三维场景的问答对生成路径指引或物体操作建议,降低人机交互门槛。此外,该数据集还可赋能虚拟现实内容设计,使得虚拟助手能依据用户的语言查询自动解析三维空间布局,提升沉浸式体验的交互智能性。
衍生相关工作
3DQA数据集的发布催生了诸多衍生工作,如ScanQA、SQA3D及EmbodiedScan等后续基准,它们分别从场景问答、具身推理与全景感知等角度扩展了原始框架。部分研究借鉴其视角无关与视角相关问题的分类设计,进一步探索多视角融合与空间记忆机制。同时,基于该数据集涌现出大批针对三维语言理解的结构化推理方法,包括图神经网络、Transformer架构与预训练语言-视觉对齐模型。这些工作不仅验证了3DQA作为验证工具的有效性,更将其问题范式延伸至动态场景理解与交互式问答领域,奠定了三维常识推理研究的基础。
以上内容由遇见数据集搜集并总结生成


