
yiyangdenanzi/LingxiDiag-16K-unofficial-mirror
收藏官方服务:
资源简介:
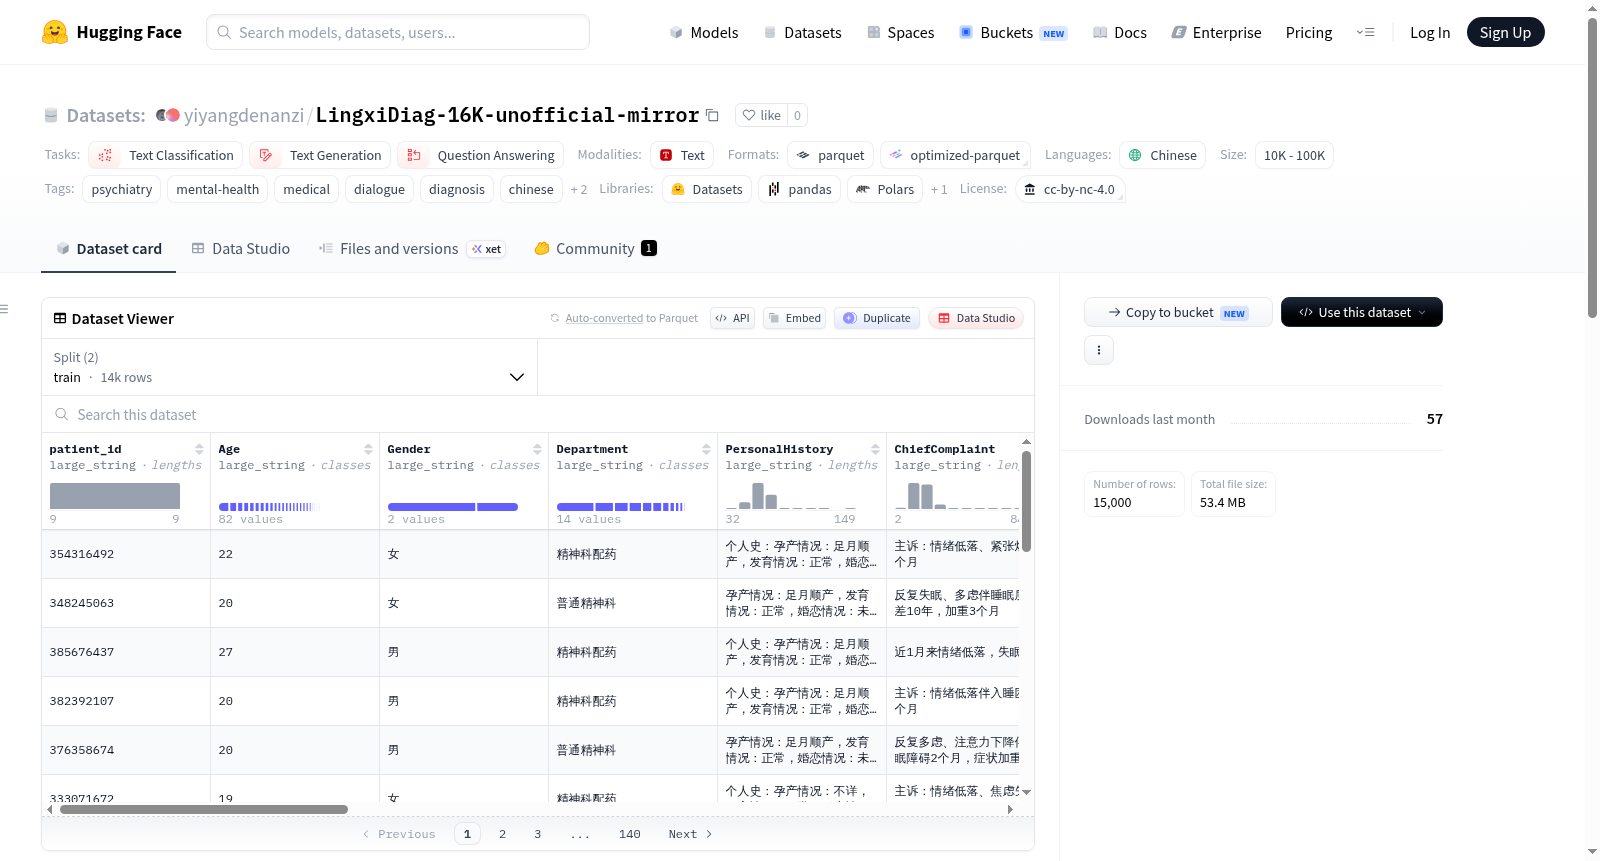
LingxiDiag-16K 是一个中文合成精神病学对话数据集,包含电子医疗记录和医患咨询对话。
LingxiDiag-16K is a Chinese synthetic psychiatric dialogue dataset containing electronic medical records and doctor-patient consultation dialogues.
提供机构:
yiyangdenanzi搜集汇总
数据集介绍
构建方式
LingxiDiag-16K-unofficial-mirror是一个面向精神健康领域的中文合成精神科对话数据集,作为原始数据集XuShihao6715/LingxiDiag-16K的非官方备份镜像而存在。该数据集隶属于LingxiDiagBench项目,旨在为精神疾病智能诊断研究提供数据基础。其构建过程基于电子病历和医患咨询对话的合成生成技术,通过模拟真实临床场景,汇集了超过一万六千条医患对话实例,覆盖精神科常见病症的诊疗流程,确保数据在内容逻辑与表达风格上贴近临床实际。镜像版本未对原始数据进行任何修改,仅在托管平台上进行备份,以保障非商业研究场景下的数据可获取性与可复现性。
特点
该数据集的主要特点体现在其专业性与结构独特性上。作为精神医学领域的中文对话数据,它包含了完整的电子病历描述与结构化的医患互动内容,为精神健康相关的文本分类、文本生成及问答任务提供了高质量的训练素材。其合成性质保证了隐私合规性,同时通过系统化设计维持了临床诊断场景的复杂性与真实性。数据集规模介于1万至10万条之间,标注信息丰富,适用于大语言模型在专业医疗领域的微调与评估。
使用方法
使用者可通过HuggingFace平台的datasets库便捷加载该备份镜像,以支持各类精神健康NLP任务的开发与研究。加载命令已集成至标准接口中,仅需调用load_dataset函数并指定镜像仓库名称即可获取完整数据。该数据集以CC BY-NC 4.0协议发布,明确禁止商业用途,仅限非商业性学术探索。建议研究者在引用时同时注明原始出处及镜像来源,以维护数据溯源与学术诚信。加载完成后,数据可直接用于模型训练、诊断对话生成、病历分析等下游任务。
背景与挑战
背景概述
在精神健康领域,高质量的医患对话数据对于构建智能诊断系统至关重要,但真实临床数据的稀缺性与隐私保护问题长期制约着研究进展。LingxiDiag-16K数据集由灵犀精神健康团队于2023年创建,旨在通过合成技术生成大规模中文精神科诊疗对话语料。该数据集包含约16,000条结构化电子病历与医患对话记录,覆盖抑郁症、焦虑症等多种常见精神障碍的核心诊断场景。作为LingxiDiagBench基准测试项目的核心数据资源,它为中文精神健康领域的对话系统、意图识别与诊断推理等任务提供了标准化训练与评估基础,显著推动了相关研究方向的发展。
当前挑战
该数据集所解决的领域问题在于精神科诊疗数据的高度敏感性与获取难度,传统方法依赖真实临床记录,不仅涉及患者隐私合规风险,且标注成本高昂。LingxiDiag-16K通过合成对话策略,在规避隐私泄露的同时模拟了复杂多变的诊疗流程,为文本分类、问答与生成任务提供了可复现的基准。构建过程中面临的挑战包括:确保合成对话的临床真实性与术语准确性,避免生成误导性医学内容;平衡典型病例与边缘案例的分布,以提升模型在少样本场景下的泛化能力;数据规模虽达到16K级别,但相较于真实临床语料的多样性仍有局限,如何持续优化合成策略以逼近真实数据分布仍是关键难题。
常用场景
经典使用场景
LingxiDiag-16K作为首个大规模中文精神科合成对话数据集,其经典使用场景聚焦于精神心理健康领域的对话系统研发与评估。研究人员可基于该数据集构建能够模拟医患交互的心理咨询对话模型,涵盖初始问诊、症状询问、病史采集及初步诊断建议等完整流程。数据集包含结构化的电子病历与自由对话两种形式,为训练具备临床推理能力的对话代理提供了丰富的语料资源。在精神卫生资源严重短缺的背景下,这一数据集尤其适合用于开发面向中文人群的初步心理评估与筛查工具,为后续精准干预奠定基础。
解决学术问题
该数据集精准回应了精神心理健康领域数据稀缺的关键瓶颈。由于精神科诊疗涉及高度隐私与伦理敏感信息,真实医患对话数据获取极为困难,导致相关学术研究长期受限于小规模、低质量样本。LingxiDiag-16K通过合成数据方法,在保障患者隐私的前提下,构建了涵盖多种常见精神障碍(如抑郁症、焦虑症等)的标准化对话样本,解决了领域内缺乏大规模、高质量中文训练数据的核心难题。这一突破使得基于深度学习的端到端诊断模型训练成为可能,显著推动了计算精神病学与自然语言处理交叉学科的发展,为构建可解释、可靠的智能心理评估系统提供了坚实的实验基础。
衍生相关工作
LingxiDiag-16K作为标志性资源,催生了一系列具有重要影响的衍生工作。原始项目LingxiDiagBench构建了基于该数据集的基准评测框架,系统评估了多种大规模语言模型在精神科诊断任务中的表现,揭示了当前模型在严谨医学推理与情感理解方面的优势与局限。后续研究者在此基础上拓展了多维度对话评估指标,从诊断准确性、对话流畅性、共情表达等角度细化了模型能力的量化考察。该数据集还被用于推动面向特定人群(如青少年、老年人)的适应性对话生成研究,以及探索多轮对话中的诊断逻辑追踪与解释生成。这些工作共同构筑了中文精神健康人工智能研究的基础生态,持续激发着模型架构创新与跨学科协作。
以上内容由遇见数据集搜集并总结生成


