遇见数据集

VibeSearchBench

收藏
github2026-05-28 更新2026-05-30 收录
官方服务:

资源简介:

VibeSearchBench是一个用于模糊多轮主动搜索的数据集,包含200个任务,分为专业研究和日常生活两个子集,涵盖20个领域。每个任务包括一个模糊的初始查询和真实的知识图谱,支持基于人物角色的渐进式披露评估。数据集包含qid、question、user_persona、nodes和triples等字段,并通过三元组F1作为主要评估指标。

VibeSearchBench is a dataset designed for fuzzy multi-turn proactive search. It consists of 200 tasks divided into two subsets: professional research and daily life, covering 20 domains. Each task includes an ambiguous initial query and a real knowledge graph, supporting progressive disclosure evaluation based on user personas. The dataset contains fields such as qid, question, user_persona, nodes, and triples, with triplet F1 as its primary evaluation metric.

创建时间:
2026-05-20
原始信息汇总

VibeSearchBench 数据集概述

核心特性

VibeSearchBench 是一个专注于多轮主动搜索的基准测试数据集,包含 200 个任务,覆盖 20 个领域。其核心定位体现在三个关键词上:

  • Hardest(最难):模糊的多轮主动搜索任务,模拟真实场景
  • Verifiable(可验证):基于无模式知识图谱的评估体系
  • Long-horizon(长周期):基于人物画像的渐进式信息披露

任务类别

数据集分为两个子集,各包含 100 个任务:

子集 数量 描述
pro 100 专业研究类任务——文献综述、市场分析、技术尽职调查
daily 100 日常生活类任务——购物、旅行、生活方式(带偏好演变)

每个任务由一条模糊的初始查询和一个对应的真实知识图谱组成。

数据集字段

数据集托管于 Hugging Face:VibeSearchBench/VibeSearchBench

字段 描述
qid 唯一任务标识符
question 完整的带约束研究查询
user_persona 用于渐进式信息披露模拟器的人物画像
nodes / triples 真实知识图谱(节点和三元组)

评估指标

采用两阶段的 LLM-as-judge 评估方法:

  1. 节点匹配:LLM 将预测实体与真实实体匹配(支持别名/翻译感知)
  2. 三元组匹配:对匹配的实体对,LLM 判断关系语义等价性

主要指标:三元组 F1 值。当前最佳成绩为 30.3(Claude Opus 4.6, OpenClaw)。

完整排行榜可在项目页面查看:https://vibebench.github.io/VibeSearchBench.github.io/leaderboard.html

项目结构

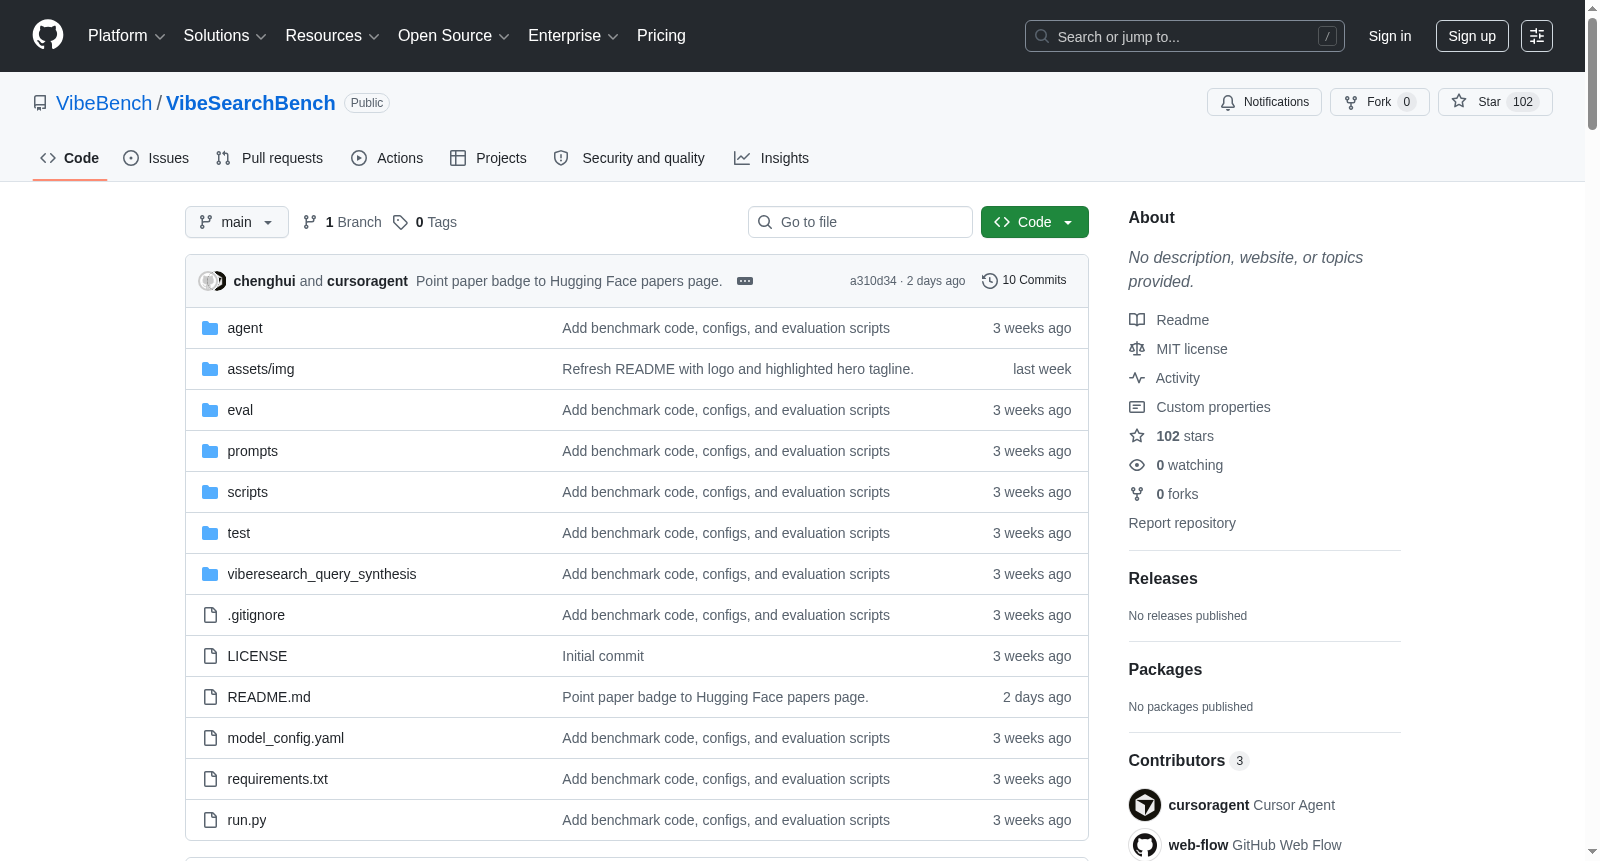
VibeSearchBench/ ├── agent/ # 智能体实现 │ ├── general_agent.py # 通用智能体(OpenAI 兼容) │ ├── openclaw_agent.py # OpenClaw 智能体封装 │ ├── llm.py # LLM 客户端工具 │ ├── prompts.py # 提示模板 │ └── toolkit.py # 工具集(搜索/访问/Python) ├── eval/ # 评估模块 │ ├── grader.py # 评分客户端 │ └── evaluator.py # KG 评估(节点F1、三元组F1) ├── scripts/ # 运行脚本 ├── viberesearch_query_synthesis/ # 查询合成模块 ├── website/ # 静态站点模板 ├── tasks/ # 任务 JSON 文件 ├── results/ # 输出目录 ├── model_config.yaml # LLM 模型配置 └── run.py # 主入口

依赖项

openai aiohttp httpx tqdm transformers json_repair

许可证

本项目采用 MIT 许可证

搜集汇总
数据集介绍
VibeSearchBench 数据集图片
构建方式
VibeSearchBench的构建旨在模拟真实世界中用户意图模糊且逐步明确的多轮主动搜索场景,填补现有基准测试在此维度的空白。数据集包含200个任务,均匀分布于专业研究(如文献综述、市场分析)与日常生活(如购物、旅行)两大子集,覆盖20个领域。每个任务均以一段模糊的初始查询起手,并配套一个由用户画像驱动的渐进式暴露模拟器,以及一个由预定义节点和三元组构成的标准答案知识图谱。构建过程通过精心设计的人物角色与查询约束,确保搜索任务既具挑战性又高度逼真。
特点
该数据集的核心特质在于其三重设计维度:最难模式突出了模糊的多轮主动搜索,要求代理在信息不完整时主动追问并逐步收敛;可验证性通过免模式的知识图谱评估实现,利用大语言模型作为裁判进行节点对齐与三元组语义等价判断,确保了评测的客观与全面;长时程性则体现为人设驱动的渐进式信息暴露,模拟用户需求在对话过程中的自然演变,使得评测能全面捕捉代理的长期推理与探索能力。
使用方法
使用者可通过两种主要代理模式进行评测:基于大语言模型的通用代理(GeneralAgent)兼容OpenAI接口,支持单代理与多代理并行搜索;基于命令行的OpenClaw代理则提供了轻量级替代方案。用户可通过丰富的环境变量与配置项自定义模型、工具集(如搜索、访问、代码执行)及评测后端(如Gemini)。评测流程支持先推理后评估的分离模式,最终通过LLM-as-judge生成节点和三元组的精确率、召回率与F1分数,并以平均与最优聚合方式呈现排行榜。
背景与挑战
背景概述
VibeSearchBench诞生于2025年,由Rednote-Hilab与Unipat AI联合打造,旨在解决现有网络搜索基准测试中意图明确、问题单一的局限性。在现实世界中,用户搜索行为往往呈现模糊、多轮且逐步暴露需求的特征,然而现有基准多基于静态、明确查询设计,难以评估智能体在动态交互中的真实能力。VibeSearchBench构建了200个涵盖专业研究与日常生活的任务,每个任务配有渐进式暴露的用户画像与可验证的知识图谱真值,核心研究问题聚焦于如何评测智能体在长程交互中通过主动追问实现双向意图收敛。该数据集一经推出,便以其最高难度、可验证性与长程互动特性引发广泛关注,并已吸引多个顶尖模型参与评测,成为衡量通用智能体搜索交互能力的权威标杆。
当前挑战
VibeSearchBench所解决的领域挑战核心在于真实世界搜索的意图模糊性与渐进性。传统基准假设用户查询明确且一次性给出,但现实中用户常以模糊意图启动搜索,并在交互中逐步细化需求,智能体需具备主动追问与动态调整搜索策略的能力。此外,该数据集构建过程中面临两大挑战:一是生成逼真的用户画像与渐进式暴露逻辑,需在真实性与可复现性间取得平衡;二是设计无模式的知识图谱评估方法,避免由于实体别称、语义等价导致的结构比对偏差,为此引入了基于大语言模型的节点对齐与三元组语义等价判定机制。最终,当前最优模型在三元组F1上仅达到30.3,表明该任务的艰巨性,也凸显了现有智能体在复杂交互搜索中的显著能力短板。
常用场景
经典使用场景
VibeSearchBench是面向多轮主动搜索场景的基准数据集,聚焦于用户在真实世界中意图模糊、偏好渐进的复杂搜索任务。其经典使用场景涵盖专业领域研究(如文献综述、市场分析、技术尽职调查)与日常生活搜索(如购物、旅行、生活方式)两大类别,共包含200个精心设计的任务。每个任务均以一句模糊的初始查询为起点,结合渐进式披露的用户画像模拟器,引导智能体在多次交互中逐步澄清需求、收集信息,最终构建完整的知识图谱。该数据集强调“寻找感”(VibeSearch)的交互本质,要求智能体能够主动提问、迭代搜索,并在长时间跨度的对话中维持上下文连贯性,为评估多轮信息检索与推理能力提供了高难度的标准化测试平台。
衍生相关工作
VibeSearchBench的发布催生了一系列具有影响力的后续研究工作。在方法层面,研究者围绕其核心挑战提出了包括多智能体协作搜索架构、基于强化学习的对话策略优化、以及渐进式信息整合的知识增强生成等创新方案。例如,利用GPT类大语言模型驱动的通用Agent与基于命令行交互的OpenClaw Agent两种范式已被纳入基准框架作为标准基线。在评估层面,其首创的LLM-as-Judge两阶段知识图谱对齐方法(节点匹配与三元组语义等价判断)为后续工作提供了可复现的评估范式,启发了多位学者将其扩展到多语言、多模态等更复杂的搜索场景。此外,该数据集的公开排行榜已成为活跃的社区协作平台,持续推动着搜索智能体在真实世界复杂任务上的性能突破与理论深化。
数据集最近研究
最新研究方向
VibeSearchBench聚焦于真实世界中模糊的多轮主动搜索场景,构建了涵盖专业研究与日常生活两大领域的200个任务,通过渐进式信息揭示策略模拟用户意图的动态演变。该基准采用无模式知识图谱评估方法,以三元组F1为核心指标,衡量智能体在长期交互中构建结构化知识的能力。当前前沿研究围绕大语言模型驱动下的多步网络搜索、代码执行与工具编排展开,最佳报告三元组F1分数仅为30.3,凸显出该任务的高度挑战性。VibeSearchBench的提出为评估智能体在复杂信息需求下的主动探索与推理能力提供了标准化测试平台,推动了搜索智能体从简单问答向双向协同进化方向的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务