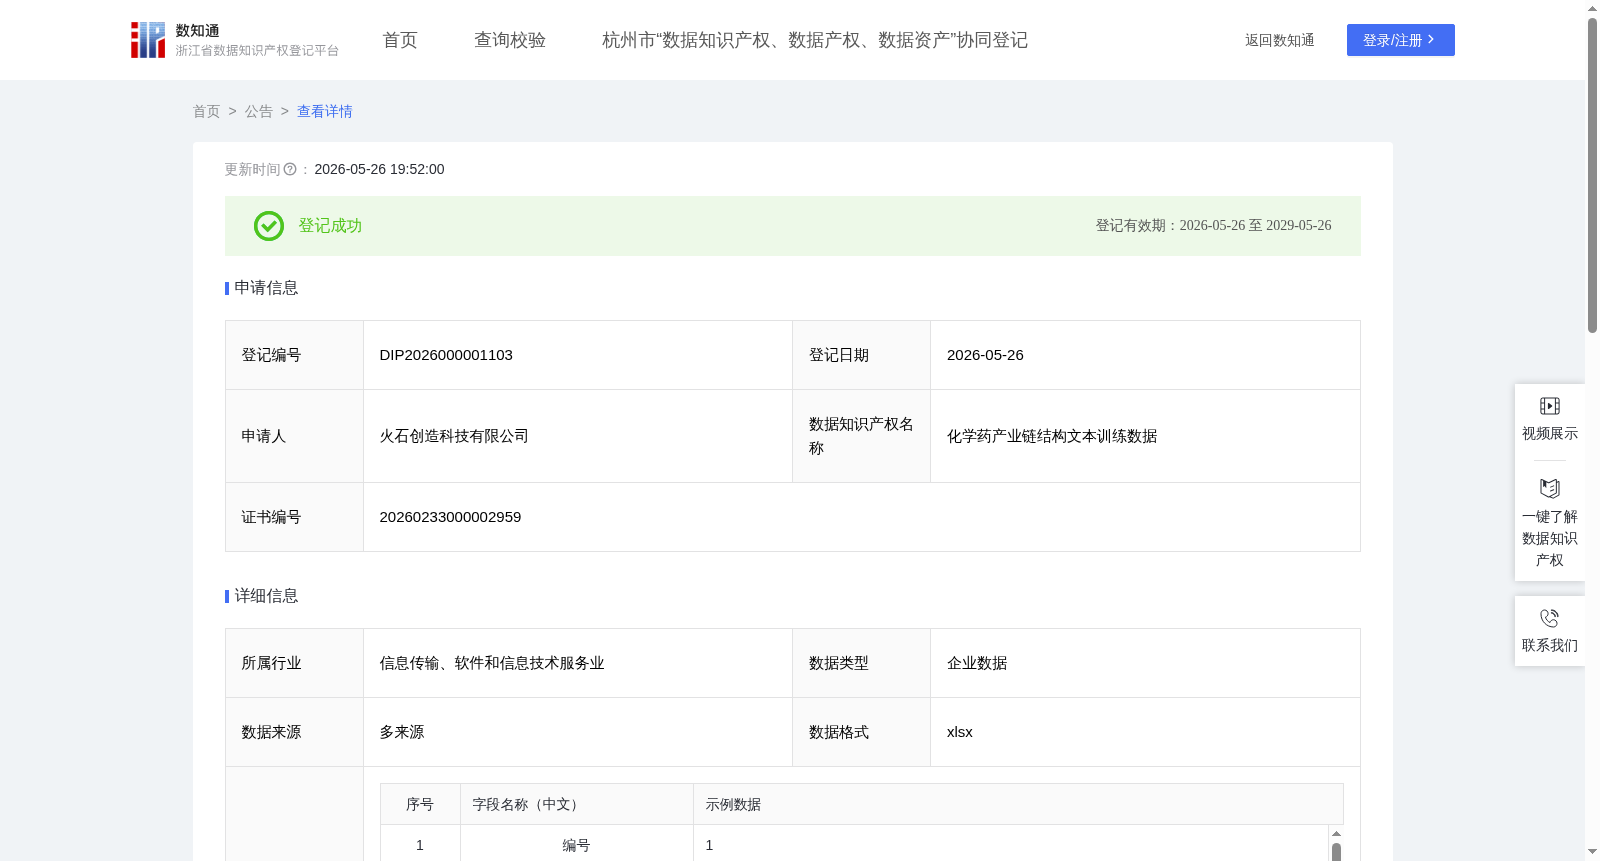
化学药产业链结构文本训练数据
收藏资源简介:
本数据集服务于化学药产业链智能分类与研发图谱构建模型的训练与开发,通过关联企业文本与药品分类标签,为医药产业研究与决策提供数据工具。其主要应用于:产业布局与政策规划:辅助政府及产业园区,分析区域在创新药、仿制药、原料药等不同领域的研发布局与生产能力,识别产业优势与短板,为制定医药产业扶持政策提供依据。投资标的筛选与赛道分析:赋能投资机构,按治疗领域、研发阶段或产业链环节对医药企业进行精准分类与筛选,深入分析细分赛道的竞争格局与投资价值。一、加工前数据说明 本数据集旨在构建用于化学药产业链智能分析的人工智能模型训练语料。在加工前,数据已进行严格的匿名化与去标识化处理。原始企业名称被统一替换为不可逆的规范标识符,并彻底移除所有的个人及商业敏感信息,确保数据完全符合隐私保护与安全合规要求,为模型训练提供了洁净、可靠的输入基础。 二、数据处理规则 数据处理严格遵循 “体系先行、业务匹配、特征抽取” 的核心规则,形成了一套从分类框架构建到最终标签生成的完整流程:1.首先,依据国家药品监督管理局药品分类标准及医药行业惯例,预先定义了以“化学药”为一级节点,按“药理作用分类”和“药品注册分类”两个维度构建二级分类体系,并进一步细分为三级具体药品类别的树状分类架构。该体系兼顾了药品的治疗用途属性与研发生产属性,为多维标注提供了结构化框架。2.业务匹配:采用“自动化规则匹配与人工校验相结合”的策略。首先,依托Spark大数据处理框架,对海量企业简介文本进行分布式清洗、分词与关键词匹配,通过预构建的化学药产业语义规则库自动计算并推荐初步分类节点。随后,由具备医药行业知识的标注专家进行审核与最终判定,确保企业归入最贴切的药品分类节点。3.特征抽取:在完成业务匹配的同时,从同一段企业简介文本中,系统性地抽取代表其核心产品、研发方向与技术能力的关键术语与名词性短语,经过去重与标准化格式化,组合成“正向词”特征串,并归纳其“产业标签”,共同作为对分类标签的精准语义补充。 三、加工后数据内容 加工后的数据集为一条条结构化的“文本-标签”数据。每条数据均包含经过脱敏处理的原始企业描述文本,以及与之对应、经人工校验的完整分类标签(一至三级节点)、高度细化的业务特征词(正向词)与产业标签。数据内容全面覆盖了化学药领域的抗肿瘤药、抗微生物药、激素类药物、镇痛抗炎药等多个治疗领域,以及创新药、仿制药、原料药、医药中间体等多个研发生产环节,形成了一个分类体系专业、业务特征鲜明、可直接用于化学药产业分析、研发能力评估与投资标筛选等模型训练与评估的高质量专用数据集。