
遇见数据集

capemox/denseon-pretrain-50m

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

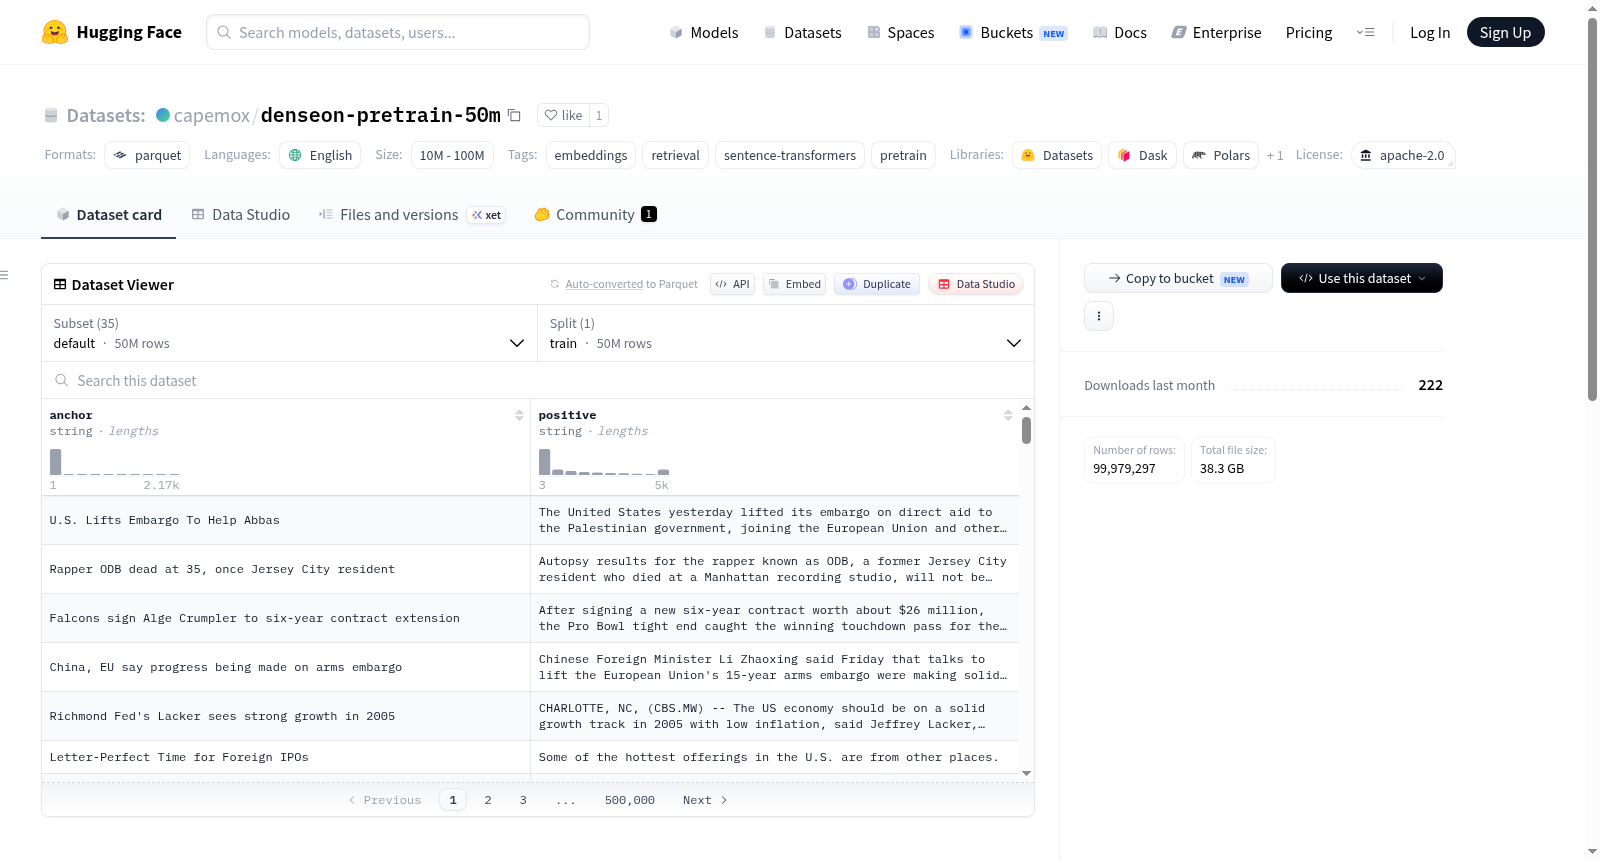
denseon-pretrain-50m 是一个用于嵌入预训练的大规模数据集,包含5000万个(查询,文档)对。这些对是从源数据集 lightonai/embeddings-pre-training-curated 的34个子集中均匀随机采样的,覆盖了多种领域,如新闻、学术论文、问答平台和用户生成内容。采样策略确保每个子集按其原始大小比例贡献数据,并通过均匀伯努利采样(种子42)选择,保留包括困难正例在内的完整质量范围。数据集模式包括两列:anchor(查询或问题)和positive(相关文档或答案)。该数据集旨在支持句子嵌入、检索和预训练任务。

denseon-pretrain-50m is a large-scale dataset for embedding pre-training, consisting of 50 million (query, document) pairs. These pairs are uniformly randomly sampled from 34 source subsets of the lightonai/embeddings-pre-training-curated dataset, covering diverse domains such as news, academic papers, Q&A platforms, and user-generated content. The sampling strategy ensures each subset contributes proportionally to its size in the full corpus, with pairs selected via uniform Bernoulli sampling (seed 42) — not filtered by similarity score — preserving the full quality range including hard positives. The dataset schema includes two columns: anchor (query or question) and positive (relevant document or answer). It is designed to support sentence embeddings, retrieval, and pre-training tasks.
提供机构:
capemox
搜集汇总
数据集介绍
capemox/denseon-pretrain-50m 数据集图片
构建方式
在自然语言处理领域,高质量的文本对数据对于训练稠密检索模型至关重要。denseon-pretrain-50m数据集从包含34个子集的lightonai/embeddings-pre-training-curated语料库中,采用均匀伯努利抽样策略(种子42)随机抽取了5000万个(查询,文档)对。每个子集的采样数量与其在完整语料中的规模成比例,且未根据相似度分数进行过滤,从而完整保留了包括困难正样本在内的全质量范围样本,确保了数据的多样性和代表性。
特点
该数据集最显著的特点在于其规模宏大且覆盖广泛,汇聚了来自新闻、学术论文、问答社区、百科知识、电商评论等34个不同领域的数据源。每一条记录包含anchor(查询/问题)和positive(相关文档/答案)两个字段,结构简洁清晰。通过保留原始数据中的困难正样本,该数据集特别适合用于训练需要高判别力的句嵌入和检索模型。
使用方法
使用denseon-pretrain-50m数据集极为便捷,可通过HuggingFace的datasets库直接加载。用户既可以一次性加载全部5000万对数据作为训练集,也可以根据需要选择特定的子集进行针对性训练,例如单独加载msmarco子集。这种灵活的加载方式使得研究者能够根据任务需求快速获取数据,极大提升了实验效率。
背景与挑战
背景概述
denseon-pretrain-50m数据集由Lighton AI团队于2024年创建,旨在为密集嵌入(dense embeddings)和检索任务提供大规模预训练语料。该数据集从包含34个子集的源数据集lightonai/embeddings-pre-training-curated中均匀随机采样5000万对(查询,文档)样本,覆盖新闻、问答、学术论文、社区讨论、百科等多种文本类型。其核心研究问题在于如何通过大规模、多样化的训练样本提升句子嵌入与信息检索模型的泛化能力。作为目前公开可用的最大规模嵌入预训练数据集之一,它为领域内的对比学习和检索模型训练提供了重要基准,显著推动了自然语言处理中语义匹配与稠密检索技术的发展。
当前挑战
数据集的构建面临多重挑战。首先,在领域问题层面,传统稀疏检索方法依赖关键词匹配,难以捕捉深层语义关联,而高质量嵌入模型的训练需要海量、多样且语义丰富的正样本对。其次,构建过程中需从665M总对中高效采样以保持子集代表性,采用均匀伯努利采样而非基于相似度过滤,虽保留了硬正例的多样性,但引入了噪声和低质量匹配的风险。此外,整合34个异构源的数据格式、确保跨域一致性并避免偏差累积,对数据处理流水线提出了严苛要求。最终数据的存储与高效加载也需优化,以支持50M级别样本的分布训练。
常用场景
经典使用场景
在深度文本嵌入与语义检索的研究领域,如何在海量异构文本数据上预训练一个泛化能力强的双编码器模型始终是核心挑战之一。denseon-pretrain-50m 数据集为此提供了理想的数据基础,其最经典的使用场景是作为 sentence-transformers 架构的预训练语料。研究者常利用该数据集中的五千万个(查询,相关文档)配对样本,通过对比学习损失函数训练模型掌握文本间的语义相似性度量,从而为下游任务提供高质量的初始化权重。该数据集涵盖新闻、问答社区、学术论文和百科等34个不同来源的子集,其多样性使得预训练模型能够广泛捕获不同领域的语言模式。
实际应用
在实际应用领域,基于 denseon-pretrain-50m 数据集训练的文本嵌入模型已深度融入各类信息检索系统。在搜索引擎与文档检索场景中,该数据集支撑的模型能够将用户查询与百万级文档库进行高效语义匹配,显著超越传统关键词匹配方法的召回率。在企业级知识管理系统中,它被用于构建智能问答机器人和内部文档的语义检索服务,帮助员工快速定位技术方案。此外,在电商平台的商品搜索与推荐环节,利用该数据集训练的模型可以精准理解用户意图与商品描述的语义关联,提升商品排序的相关性与转化效率,为大规模商业化检索系统提供了关键的底层技术支撑。
衍生相关工作
denseon-pretrain-50m 数据集的发布催生了一系列具有影响力的模型与方法创新。在经典工作方面,它直接支撑了 DenseON 系列嵌入模型的训练与迭代,此类模型在 MTEB 等主流文本嵌入基准上展示了卓越的检索与聚类性能。许多后来提出的改进型对比学习策略,如优化难负样本挖掘算法和多阶段预训练框架,皆在此数据集上进行了验证与消融实验。同时,该数据集也激发了针对跨领域语义对齐的研究,促进了对统一文本嵌入空间构建的探讨,衍生出如自适应混合训练、领域权重均衡采样等学术贡献,进一步推动了语义检索与自然语言理解技术的进步。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

