
Shaer-AI/shaer-eval-raw-ashaar-model
收藏官方服务:
资源简介:
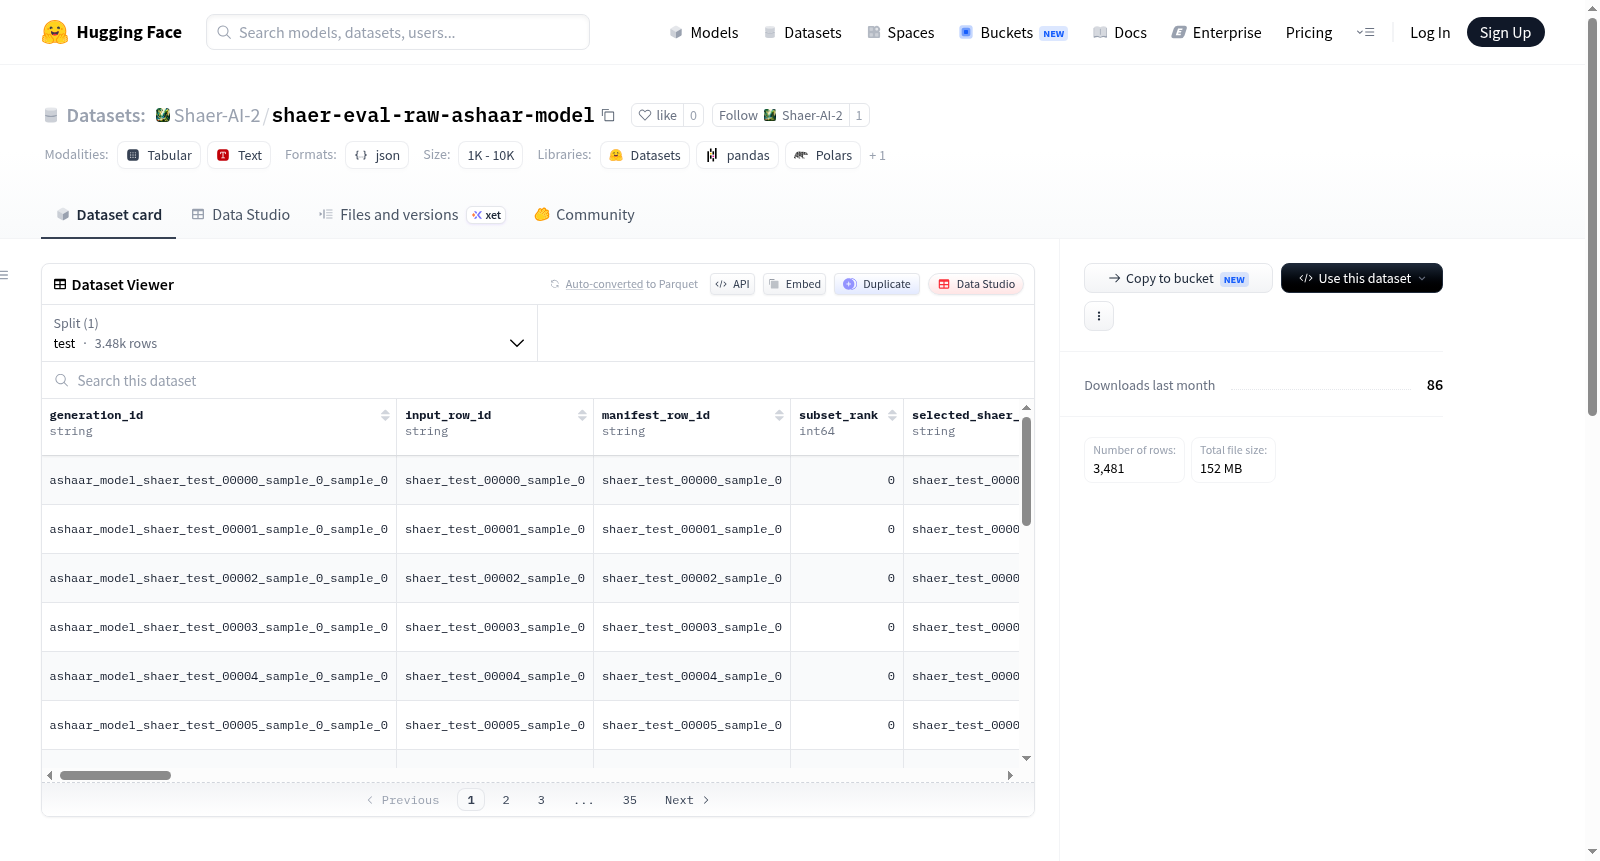
该数据集包含ashaar_model的累积原始续写生成数据。主表为data/test.jsonl,其中包含source/prompt/reference字段以及模型输出在generated_text和raw_generated_text中。当前上传进度为3481行,已全部完成。当scored upload为true时,主表还包括奖励/评估列。验证和CSV导出等工件存储在artifacts/目录下。
This dataset contains cumulative raw continuation generations for ashaar_model. The main table is data/test.jsonl; it includes source/prompt/reference fields plus the model output in generated_text and raw_generated_text. Current uploaded progress target: 3481 rows out of 3481. Scored upload: 1. When scored upload is true, reward/evaluation columns are included in the main table. Artifacts such as validation and CSV exports are stored under artifacts/.
提供机构:
Shaer-AI搜集汇总
数据集介绍
构建方式
在阿拉伯诗歌生成领域,模型输出的质量评估至关重要。shaer-eval-raw-ashaar-model数据集基于Shaer-AI团队开发的ashaar_model,从源数据集shaer-sft-test-generations-k5中抽取3481条测试样本构建而成。原始生成结果以JSONL格式存储于generations.jsonl文件中,并同步提供CSV格式副本;在原始数据基础上,通过韵律与计数评估流程,生成了包含评分信息的generations_scored.jsonl及其CSV对应文件。此外,validation.json记录了验证摘要,aggregate.json汇总了聚合指标,构成了一套完整的评估数据体系。
特点
该数据集聚焦于阿拉伯诗歌生成的客观量化评价,具有鲜明的领域特色。核心评估指标包括韵律均值(Meter mean)为0.036776,计数遵从度均值(Count adherence mean)为0.439289,以及精确计数率(Exact count rate)为0.334099。这些指标反映了模型在诗歌韵律与音节计数上的表现,揭示出模型在韵律方面仍有较大改进空间,而计数遵从性相对较高。数据集不仅提供了原始生成文本,还附加了细致的评分结果,便于研究者深入分析模型在不同诗歌结构维度上的优势与不足。
使用方法
使用者可通过Hugging Face Datasets库加载该数据集,指定config名为default并选择test分片进行访问。加载后,可直接获取原始生成行数据,或调用评分后的generations_scored文件以获取包含韵律与计数评价的增强信息。对于定量分析,建议利用aggregate.json中的聚合指标进行模型性能比较;若需个性化分析,可通过validation.json验证结果并结合CSV格式数据,在Python或其他数据处理工具中进行深度挖掘,从而评估ashaar_model在阿拉伯诗歌生成任务中的实际表现。
背景与挑战
背景概述
古典阿拉伯诗歌作为阿拉伯文化遗产的瑰宝,其格律与韵律的严谨性为自然语言处理领域带来了独特的挑战。Shaer-Eval-Raw-Ashaar-Model数据集由Shaer-AI团队于近期创建,聚焦于评估阿拉伯诗歌生成模型在格律与音节计数上的表现。该数据集基于'ashaar_model'生成的3481条诗歌续写样本,旨在量化模型对阿拉伯诗歌传统规则的遵循程度,其核心研究问题在于如何通过自动化指标衡量生成诗歌的结构精确性。作为Shaer评估体系的一部分,该数据集为阿拉伯诗歌生成领域的标准化评测提供了重要基准,推动了低资源语言中诗意文本生成的研究进展。
当前挑战
该数据集所解决的领域问题在于阿拉伯诗歌生成中格律与音节的严格约束,传统语言模型往往难以同时保证语义流畅性与形式规则。具体挑战包括:模型在格律忠实度上平均得分为0.037(Meter mean),表明生成诗歌的韵律模式与原诗存在显著偏差;计数遵循率(Count adherence mean)仅0.439,反映模型在音节数量匹配上表现较差,精确计数率(Exact count rate)更低至0.334,凸显了精确控制诗句音节的困难。构建过程中,人工标注的稀缺性与阿拉伯诗歌格律的复杂分类增加了样本标定的成本,且自动评估指标如计数的定义需要与专家知识对齐,以防简化评测牺牲诗歌的美学价值。
常用场景
经典使用场景
在阿拉伯诗歌生成领域,Shaer-Eval-Raw-Ashaar-Model数据集专为评估诗歌生成模型而设计,聚焦于韵律(Meter)与音节计数(Count)两个核心维度的量化考核。该数据集包含3481条模型生成的诗歌续写样本,通过精细的韵律一致性评分和计数遵循度指标,为研究者提供标准化评估基准。其经典用法是作为测试基准,衡量微调后的阿拉伯语诗歌生成模型是否在保持阿拉伯传统诗歌格律(如Al-Khalil韵律系统)的同时,精确把控每行诗句的音节数量,从而判断模型对阿拉伯诗歌形式规则的掌握程度。
解决学术问题
该数据集解决了阿拉伯诗歌自动生成领域缺乏细粒度、可量化评估体系的学术困境。传统评估依赖人工评审,主观性强且难以复现,而Shaer-Eval-Raw-Ashaar-Model通过提供韵律均值(Meter mean=0.036776)和计数遵循率(Count adherence mean=0.439289)等客观指标,使得研究者能够精确对比不同模型对阿拉伯古典格律的遵循能力。这些指标揭示了一个关键学术问题:即便先进的语言模型也难以同时完美兼顾诗歌的韵律美与形式严谨性,从而推动学术界深入探索如何在生成过程中平衡创造性表达与严格约束。
衍生相关工作
基于Shaer-Eval-Raw-Ashaar-Model数据集,衍生了一系列针对阿拉伯诗歌生成模型的优化工作:研究者利用其提供的韵律与计数评估指标,设计了专门惩罚格律偏差的损失函数,训练出更遵循传统形式的生成模型;也有工作将其与人工评价结合,构建多维度诗歌质量评分体系。该数据集的聚合指标——精确计数率(Exact count rate=0.334099)——被后续研究用作对比基线,推动了如韵律注意力机制、音节级解码策略等创新方法的提出,形成了阿拉伯自然语言处理中诗歌生成评估的标准参考集。
以上内容由遇见数据集搜集并总结生成


