
allenai/mup-full
收藏官方服务:
资源简介:
MuP数据集专注于多视角科学文档摘要生成,旨在解决现有摘要生成工作中每个文档只有一个最佳摘要的局限性。该数据集通过利用科学同行评审的数据,从读者的角度捕捉多样化的视角,引入了一个新的摘要生成语料库,以探索生成多视角摘要的方法。
The MuP dataset focuses on multi-perspective scientific document summarization, aiming to address the limitation of existing summarization tasks where only one optimal summary exists for each document. By leveraging data from scientific peer reviews, this dataset captures diverse perspectives from readers' standpoints and introduces a novel summarization corpus to explore methodologies for generating multi-perspective summaries.
提供机构:
allenai原始信息汇总
MuP - Multi Perspective Scientific Document Summarization
数据集概述
- 目的: 探索生成多视角科学文档摘要的方法。
- 挑战: 现有的摘要生成工作大多假设每个文档只有一个最佳摘要,这限制了评估摘要系统质量的能力,因为编写摘要是一个主观活动。
- 解决方案: 引入一个新型的摘要语料库,利用科学同行评审数据来捕捉读者视角的多样性。
数据集详情
- 许可证: odc-by
- 更多信息: 请参考 https://github.com/allenai/mup
搜集汇总
数据集介绍
背景与挑战
背景概述
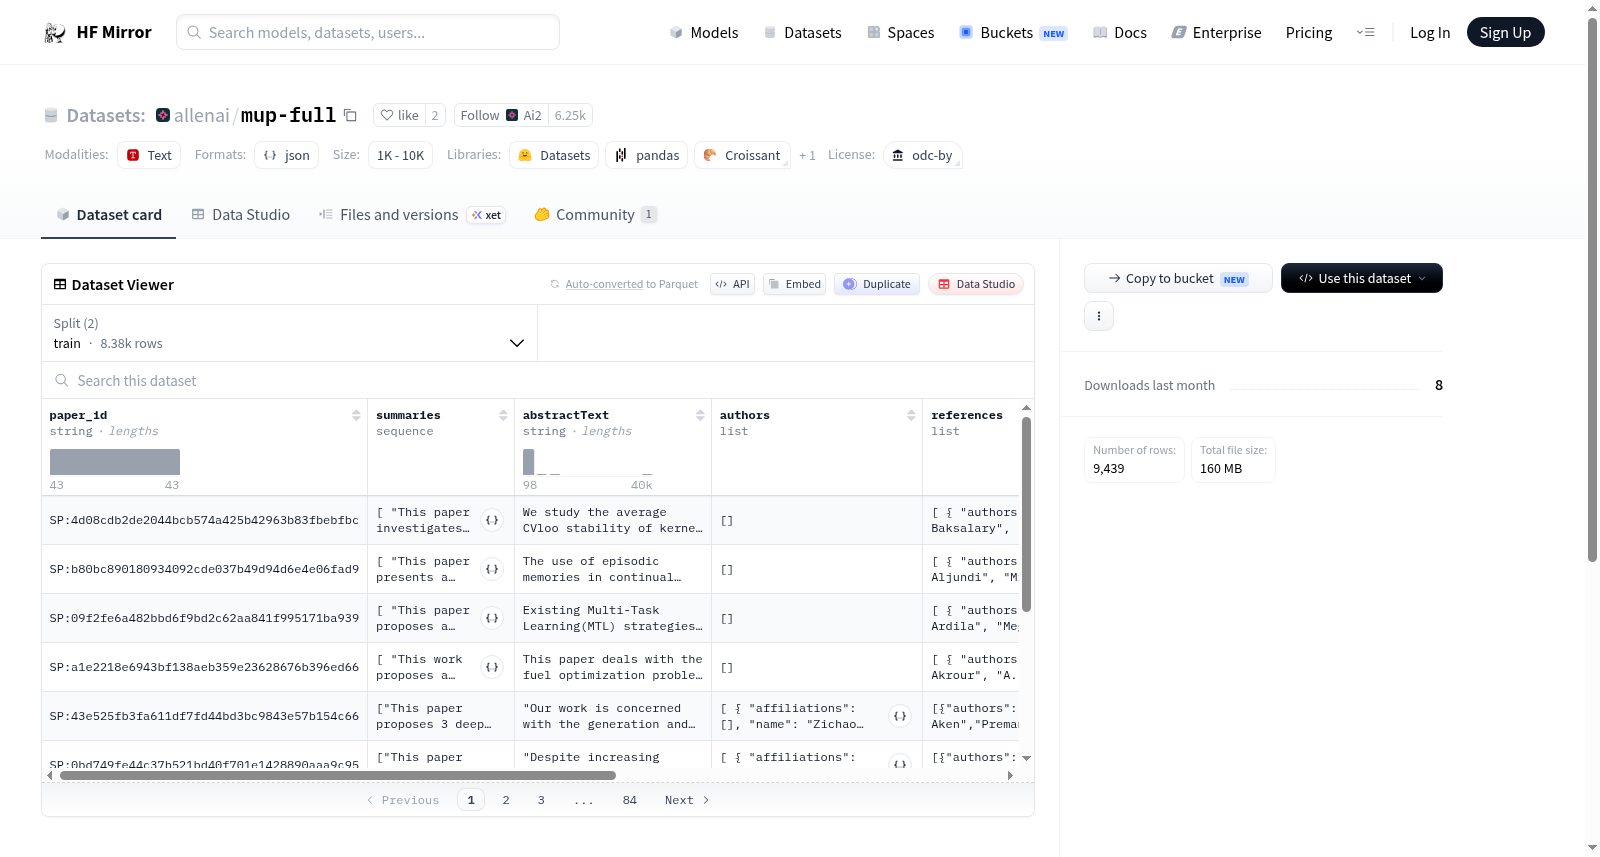
该数据集名为MuP - Multi Perspective Scientific Document Summarization,专注于科学文档的多视角摘要任务。它通过利用科学同行评审数据,捕捉了读者对同一文档的不同观点,以解决单一黄金摘要的主观性问题。数据集包含约9,439行文本数据,格式为JSON,适用于自然语言处理中的摘要生成研究。
以上内容由遇见数据集搜集并总结生成


