
ghananlpcommunity/new-twi-tts-aligned-ref
收藏官方服务:
资源简介:
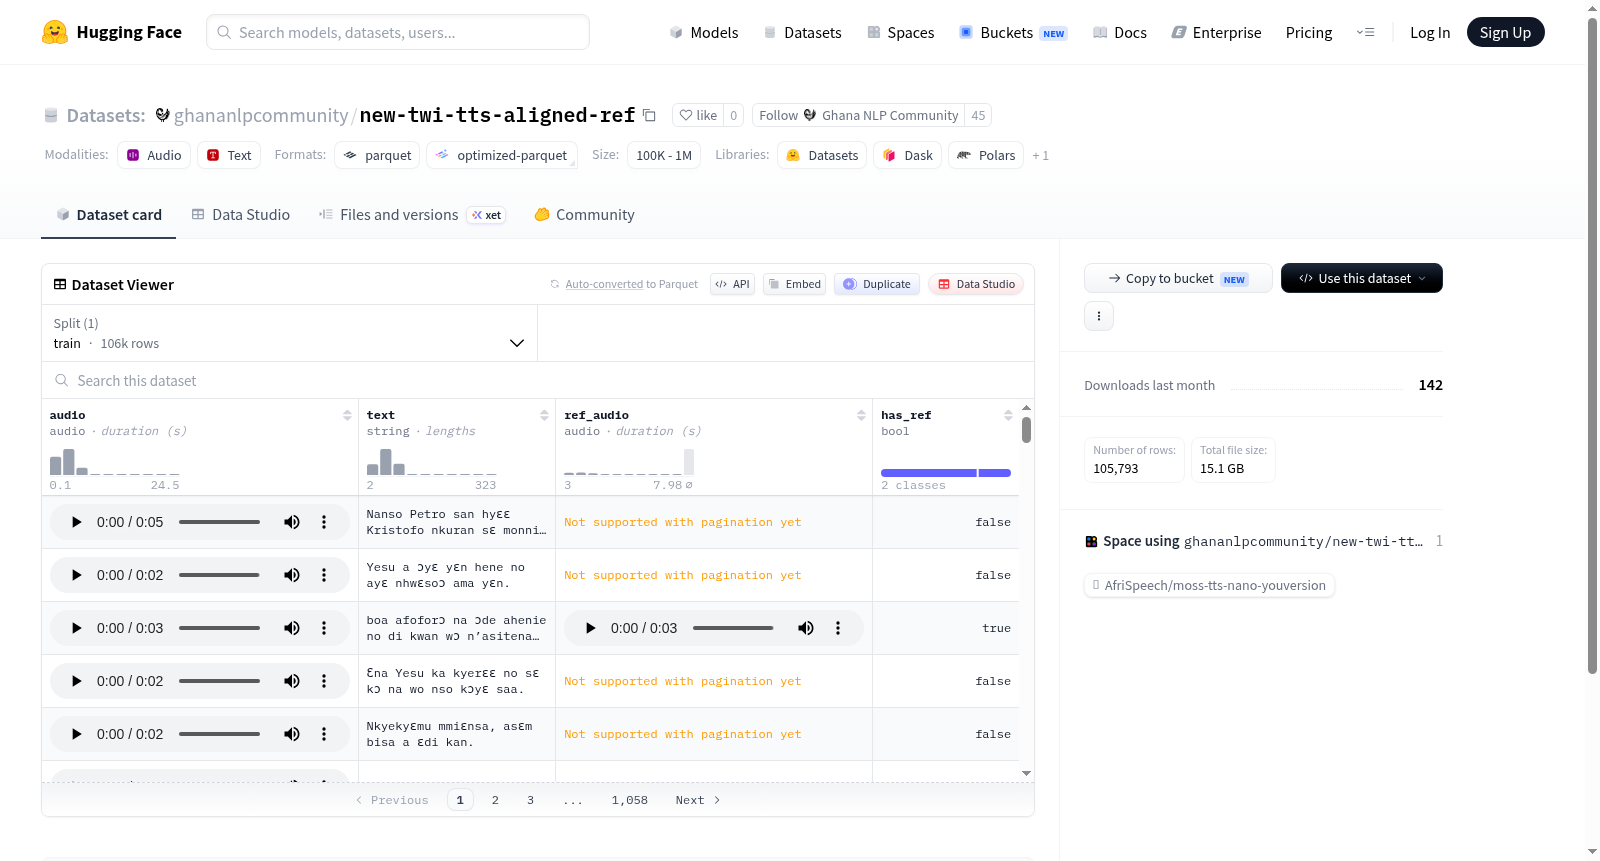
该数据集是一个音频-文本配对数据集,包含105,793个训练样本,每个样本包括主音频(采样率16000Hz)、对应的文本描述、参考音频(采样率16000Hz)以及一个布尔值指示是否存在参考音频。数据集总大小约为15.07 GB,适用于音频处理、语音识别或语音合成等任务。
This dataset is an audio-text paired dataset containing 105,793 training examples. Each example includes a main audio (sampling rate 16000Hz), corresponding text description, reference audio (sampling rate 16000Hz), and a boolean value indicating the presence of reference audio. The total dataset size is approximately 15.07 GB, suitable for tasks such as audio processing, speech recognition, or speech synthesis.
提供机构:
ghananlpcommunity搜集汇总
数据集介绍
构建方式
该数据集基于新浪潮(new-twi)语音数据构建,专为文本到语音(TTS)对齐任务设计。数据集中每条样本包含目标音频(audio)、对应文本(text)、参考音频(ref_audio)以及是否包含参考音频的布尔标识(has_ref)。所有音频均以16kHz采样率存储,确保语音信号的高保真度。训练集规模宏大,包含105,793个样本,总数据量超过15GB,为模型学习提供了丰富的声学与语言特征对齐基础。
特点
数据集的核心特色在于其双音频结构:每条样本不仅提供目标语音与文本配对,还附带参考音频,这为语音克隆、风格迁移及多说话人TTS研究提供了关键支持。has_ref字段明确区分了有参考和无参考样本,便于灵活构建训练策略。统一的16kHz采样率降低了预处理复杂度,使得数据集可直接用于主流TTS框架,如Tacotron、FastSpeech或VITS等,无需额外重采样。
使用方法
使用方法上,研究者可借助HuggingFace Datasets库直接加载该数据集,通过指定split='train'获取全部样本。对于TTS对齐模型训练,可将audio与text作为监督信号,同时利用ref_audio进行说话人嵌入学习或风格适配。has_ref标志可用于实现灵活的训练范式切换,例如在无参考样本上预训练基础对齐能力,再通过有参考样本微调说话人特性。建议在实验前对文本进行分词及音素转换,以适配下游模型的输入要求。
背景与挑战
背景概述
在语音合成与语音转换领域,基于参考音频的文本到语音(TTS)对齐技术近年来受到广泛关注。new-twi-tts-aligned-ref数据集由研究人员于近期创建,致力于解决多说话人语音合成中参考音频与文本的高精度对齐问题。该数据集包含约10.5万个训练样本,每个样本由目标音频、对应文本以及参考音频组成,并标注了是否含有参考音频的布尔标识。其核心研究问题在于如何利用参考音频提升TTS系统在语音风格、韵律和音色上的自然度与可控性。这一数据资源的推出,为少样本语音克隆、跨语言语音合成以及情感语音生成等前沿方向提供了关键的训练基础,显著推动了相关领域的发展。
当前挑战
该数据集面临的挑战首先体现在领域问题上:传统TTS系统在缺乏参考音频时难以捕捉个性化的语音特征,而多说话人场景下的语音对齐极易受到音色差异、语速变化和环境噪声的干扰,导致合成语音的相似度和自然度不足。在构建过程中,数据集面临音频与文本的精准对齐难题,特别是在处理长句、非规范发音或背景噪声时,自动对齐技术可能引入大量错误。此外,参考音频的多样性不均衡、样本规模有限以及计算资源的消耗,也制约了模型从该数据集中充分学习泛化能力,进一步加大了实现高质量、高可控合成的难度。
常用场景
经典使用场景
在语音合成与语音克隆领域,new-twi-tts-aligned-ref 数据集被广泛用于训练基于参考语音的多说话人文本转语音(TTS)模型。其核心设计在于每条样本不仅包含目标文本与对应的标准语音,还提供了参考音频(ref_audio)及其有效性标识(has_ref),使得模型能够学习从参考语音中提取说话人特征、音色、韵律等声学属性,进而实现高质量、高自然度的语音克隆与风格迁移。这一设置特别适用于零样本语音合成场景,即在未见过的说话人参考音频下,生成与目标文本相匹配且具有相似声学特征的语音。
解决学术问题
该数据集有效解决了说话人特征解耦与泛化合成的学术难题。在传统的多说话人TTS研究中,模型通常只能为训练集中出现的固定说话人生成语音,缺乏对未知说话人声音的适应能力。new-twi-tts-aligned-ref 通过提供对齐的参考音频,促使学术界探索如何将语言学内容与说话人身份信息在隐空间中进行分离与重组。相关研究围绕参考编码器设计、跨说话人一致性约束、以及说话人条件生成机制展开,显著推动了零样本语音克隆、可控语音合成等方向的发展,并为说话人自适应与少样本学习提供了标准化验证平台。
衍生相关工作
基于 new-twi-tts-aligned-ref 数据集,学术界涌现了一系列标志性工作。其中,YourTTS 模型借鉴了参考音频对齐策略,实现了跨语言零样本语音克隆;而 XTTS 系列模型则利用类似的数据结构,在TTS预训练阶段引入参考编码器,取得了当前最优的说话人泛化性能。此外,有关数据增强与伪参考生成的研究,如VoiceBox 和 NaturalSpeech 3 亦将此数据集作为评估基准。这些工作共同验证了参考对齐范式在提升TTS系统鲁棒性与可控性方面的有效性,推动了语音合成技术从封闭集多说话人合成向开放集个性化生成的根本性跨越。
以上内容由遇见数据集搜集并总结生成


