
sapbot/gpt-oss-120b-450x
收藏官方服务:
资源简介:
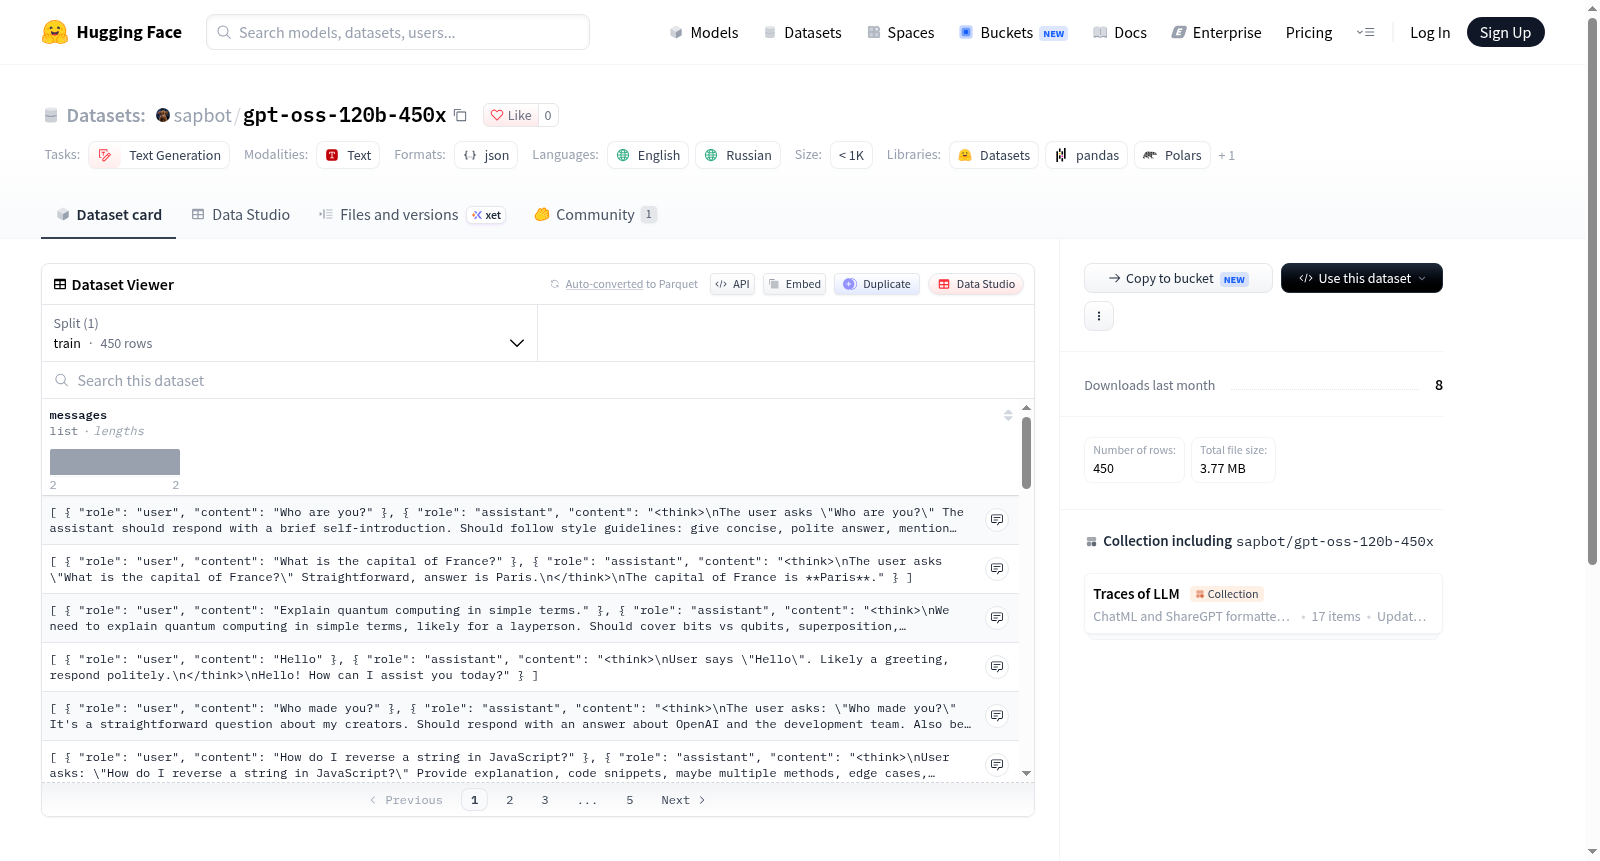
该数据集是OpenAI的gpt-oss 120B大语言模型的痕迹,以ChatML格式呈现,每条对话用换行符分隔,适用于微调任务。数据支持英语和俄语,规模小于1000条。
Trace of `gpt-oss 120B` LLM made by `OpenAI`. Data is presented in ChatML format and each conversation split by newline. Ready to be used for fine-tuning.
提供机构:
sapbot搜集汇总
数据集介绍
构建方式
该数据集源自OpenAI研发的gpt-oss 120B大语言模型所生成的对话轨迹,通过系统化采集模型在交互过程中的完整输出,并以ChatML格式进行结构化封装。每条对话记录独立成行,以换行符分隔,形成可直接用于微调任务的jsonl文件。构建过程注重数据格式的规范性与一致性,确保角色标注(user与assistant)清晰明确,从而为后续模型训练提供高质量的监督信号。
使用方法
使用者可直接加载jsonl文件,逐行解析JSON对象,提取messages字段中的角色与内容序列。在微调场景下,将每条样本输入至支持ChatML格式的模型训练流程,如基于Transformer的对话生成模型。亦可将其作为评估集,检验模型对简短对话的响应能力。由于数据量有限,建议结合其他语料进行联合训练,或用于快速验证数据预处理管线的正确性。
背景与挑战
背景概述
在大规模语言模型迭代演进的浪潮中,OpenAI推出的gpt-oss 120B模型凭借其庞大的参数规模与开放的推理能力,成为开源社区关注的焦点。为揭示该模型在真实对话场景下的行为特性,sapbot团队与Romarchive协作构建了gpt-oss-120b-450x数据集,以ChatML格式记录了450轮由gpt-oss 120B生成的对话轨迹,涵盖英文与俄文两种语言。该数据集旨在为研究者提供细粒度的模型输出样本,支撑指令微调、对话行为分析及跨语言生成评估等下游任务,对理解超大模型的开源生态适配具有参考价值。
当前挑战
该数据集所面向的领域问题在于如何系统性地刻画前沿大语言模型在开放对话中的生成规律,并支撑高效的参数微调与行为复现。构建过程中的挑战集中于对话轨迹的采样与筛选:需在有限规模内保留模型输出的多样性与代表性,避免单一话题或重复模式主导;ChatML格式的规范化要求对角色、内容及换行分隔进行严格对齐,确保可直接用于微调流程;俄英双语混合进一步增加了语言分布均衡与标注一致性的难度。此外,模型版本与生成参数的透明性、以及输出内容的安全与偏见评估,亦是该数据集在后续使用中需持续应对的问题。
常用场景
经典使用场景
在大规模语言模型对话生成领域,该数据集提供了OpenAI所研发的gpt-oss 120B模型的交互轨迹记录,以ChatML格式封装并逐行分隔。其最经典的使用场景在于作为指令微调或对话风格迁移的语料资源,研究者可借助这些真实模型输出,对参数量更小的开源模型进行监督式微调,从而复现大型闭源模型的应答分布与交互模式。
解决学术问题
该数据集应对了学术研究中模型行为复现与对话质量评估的难题。在缺乏大型闭源模型内部参数与训练细节的背景下,研究者难以系统分析其生成偏好与潜在偏差。此数据集提供了可观测的应答样本,有助于开展模型蒸馏、输出分布对比以及安全性对齐等实证研究,为理解大规模模型的行为特征提供了可复用的经验材料。
实际应用
在工业与开发实践中,该数据集可服务于对话系统的快速原型构建与风格适配。开发者利用这些对话轨迹进行轻量级微调,可在有限算力条件下获得接近gpt-oss 120B风格的交互表现,适用于客服机器人、创意写作辅助及多轮问答系统的冷启动,降低了对昂贵闭源接口的依赖,并提升了本地部署模型的应答自然度。
数据集最近研究
最新研究方向
在大型语言模型迭代加速的背景下,对开源模型行为轨迹的精细化记录与再利用成为自然语言处理领域的前沿议题。gpt-oss-120b-450x数据集通过采集OpenAI的gpt-oss 120B模型在对话中的完整输出,并以ChatML格式组织为多轮对话样本,为研究模型对齐、指令遵循及多语言生成能力提供了珍贵的实证材料。该数据集规模虽小,却精准契合当下对轻量级、高质量微调语料的迫切需求,尤其推动了低资源场景下的模型适配与行为分析。其开放共享模式亦呼应了可复现研究的热点趋势,有助于社区探索大模型输出偏差、知识边界及跨语言迁移等关键问题,对构建透明、可信的生成系统具有参考意义。
以上内容由遇见数据集搜集并总结生成


