app-category-opportunity-scan
收藏资源简介:
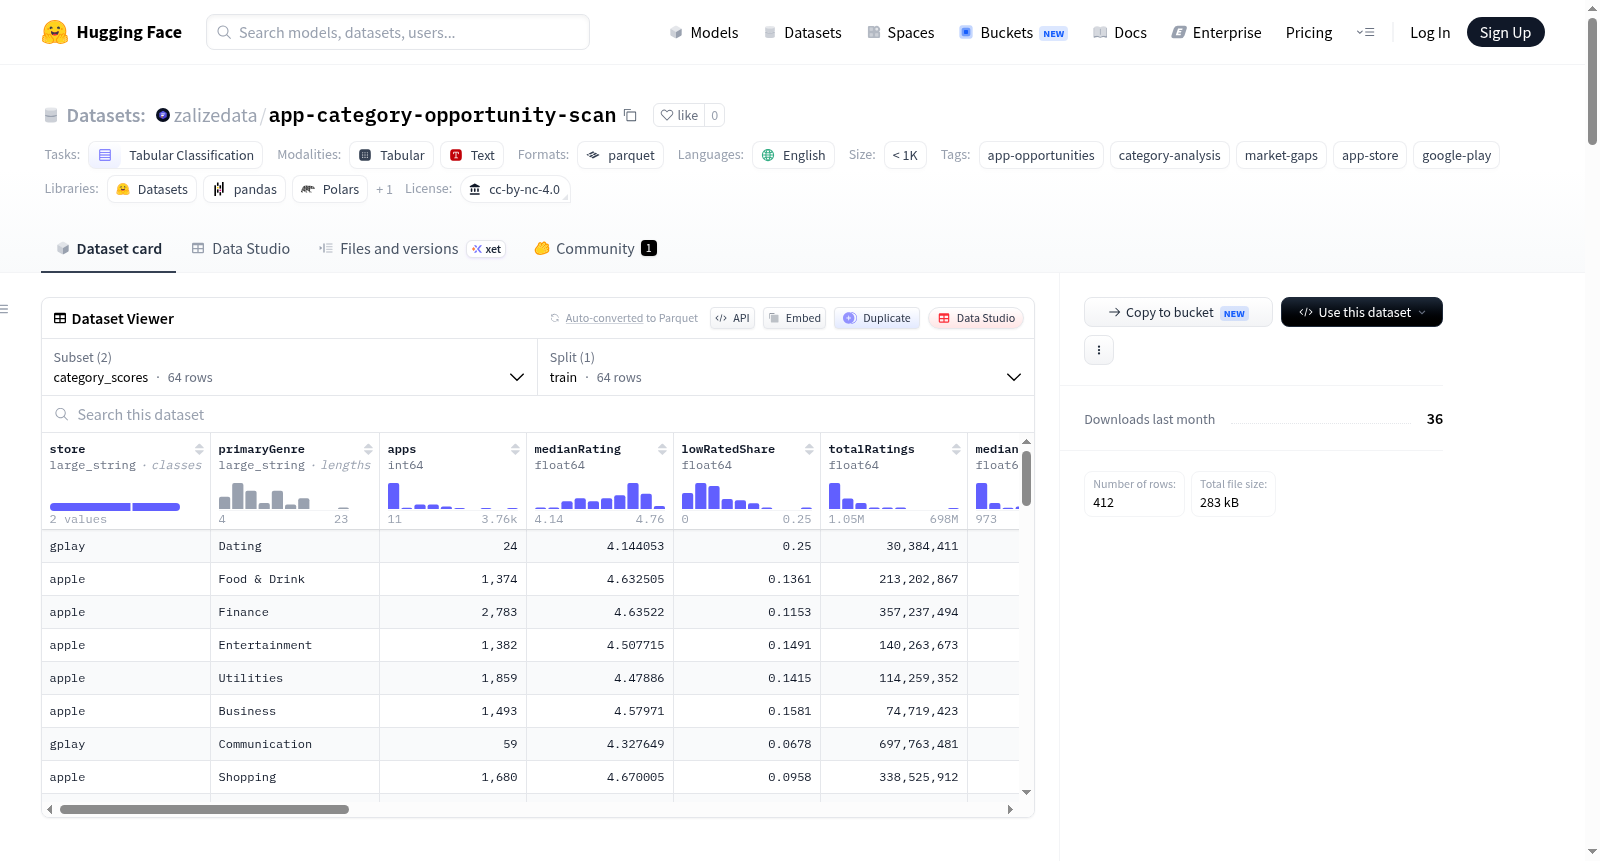
这是一个高需求低评分应用类别机会扫描数据集,由 DataForge 提供。数据集包含64个应用商店类别的排名表,根据需求(下载量)与用户不满程度(低评分)进行评分,涵盖 Apple App Store 和 Google Play。同时提供348个代表性高需求低评分应用作为具体的构建目标,每个应用包含商店标识、类别、评分、评分数量、价格、投诉分析等字段。数据以 Parquet 格式存储,分两个配置:category_scores(64行)和 representative_apps(348行)。该数据集可用于选择下一个要构建的应用、验证 VC/工作室投资方向、评估类别进入时机。许可协议为 CC BY-NC 4.0,仅限学术和个人使用,商业使用需获取 DataForge 商业许可。
This is a high-demand low-rated app category opportunity scanning dataset, provided by DataForge. The dataset contains ranking tables for 64 app store categories, scored based on demand (downloads) and user dissatisfaction (low ratings), covering Apple App Store and Google Play. It also includes 348 representative high-demand low-rated apps as specific build targets, each with fields such as store identifier, category, rating, number of ratings, price, complaint analysis, etc. The data is stored in Parquet format, divided into two configurations: category_scores (64 rows) and representative_apps (348 rows). This dataset can be used to select the next app to build, validate VC/studio investment directions, and assess category entry timing. The license is CC BY-NC 4.0, for academic and personal use only; commercial use requires obtaining a commercial license from DataForge.
高需求低评分应用类别机会扫描数据集
数据集概述
该数据集提供了一个排名榜单,涵盖64个应用商店类别,基于需求与用户不满程度的评分(即下载量高但评分低),并包含348个具有代表性的高需求低评分应用,覆盖Apple App Store和Google Play两大平台。
数据集配置
数据集包含两个配置:
| 配置名 | 行数 | 说明 |
|---|---|---|
category_scores |
64行 | 类别机会评分排名表 |
representative_apps |
348行 | 代表性高需求低评分应用列表 |
数据结构
category_scores 表字段说明
| 字段名 | 类型 | 说明 |
|---|---|---|
store |
string | 商店枚举:apple / gplay |
primaryGenre |
string | 商店类别 |
apps |
int | 符合条件的应用数(评分数≥200) |
medianRating |
double | 合格应用中位数评分 |
lowRatedShare |
double | 评分低于3.5的应用占比 |
totalRatings |
double | 评分总数(需求规模代理) |
medianRatings |
double | 每个应用的中位评分数量 |
avgComplaintShare_* |
double | 各类投诉平均占比(崩溃/广告/计费/登录/性能/UX/支持/隐私) |
opportunityScore |
double | 0–100分:50%对数需求 + 50%不满程度 |
representative_apps 表字段说明
| 字段名 | 类型 | 说明 |
|---|---|---|
store |
string | 商店枚举:apple / gplay |
appId |
string | 商店原生应用标识符 |
name |
string | 应用名称 |
developer |
string | 开发者 |
primaryGenre |
string | 类别 |
rating |
double | 平均评分(<3.5) |
ratingCount |
double | 总评分数(≥200) |
price |
double | 价格 |
country |
string | 国家 |
reviewsAnalyzed |
double | 分析评论数 |
sentimentMean |
double | 平均情感得分 |
complaintShare_* |
double | 各类投诉占比 |
topComplaint |
string | 最高投诉主题 |
topKeywordLabels |
string | 主要评论关键词标签 |
发布包
| 包名 | 层级 | 行数 |
|---|---|---|
category-opportunity-tier1-S-2026-08-02.zip |
S | 64 |
category-opportunity-tier1-M-2026-08-02.zip |
M | 292 |
category-opportunity-tier1-L-2026-08-02.zip |
L | 412 |
应用场景
- 选择下一个要构建的应用类型
- 风投/工作室的投资论点验证
- 类别进入时机判断
许可信息
- 学术/个人使用:CC BY-NC 4.0,需注明出处并链接至 https://data.zalize.com
- 商业使用:需获得DataForge商业许可(https://data.zalize.com/datasets)
- 上游许可条款适用于底层数据
使用示例
python from datasets import load_dataset
ds = load_dataset("zalizedata/app-category-opportunity-scan", "category_scores", split="train") print(ds[0])
相关数据集
完整目录(25个数据集):https://data.zalize.com/open-data