
HyGenar数据集
收藏资源简介:
HyGenar数据集是一个用于评估大型语言模型(LLM)在少量样本上进行语法生成的数据集。该数据集包含540个结构化的语法生成挑战,每个挑战由3个正例和3个反例组成。数据集旨在研究LLM从少量正反例中推断和生成语法的能力,并用于评估8种不同LLM的性能。HyGenar数据集为LLM在语法生成方面的研究提供了重要的数据基础,并有助于推动相关领域的发展。
The HyGenar dataset is a benchmark resource designed to evaluate large language models (LLMs) on few-shot grammatical generation tasks. It comprises 540 structured grammatical generation challenges, with each challenge containing 3 positive examples and 3 negative examples. This dataset aims to explore the capacity of LLMs to infer and generate grammatical rules from a limited set of positive and negative examples, and to assess the performance of 8 distinct LLMs. The HyGenar dataset provides a critical data foundation for research on grammatical generation in LLMs, and contributes to advancing progress in this research area.
HyGenar 数据集概述
数据集基本信息
- 数据集名称: HyGenar: An LLM-Driven Hybrid Genetic Algorithm for Few-Shot Grammar Generation
- 数据集用途: 用于研究大型语言模型(LLMs)在小样本语法生成任务中的表现,并优化语法生成能力
- 数据集内容: 包含540个结构化语法生成挑战
数据集结构
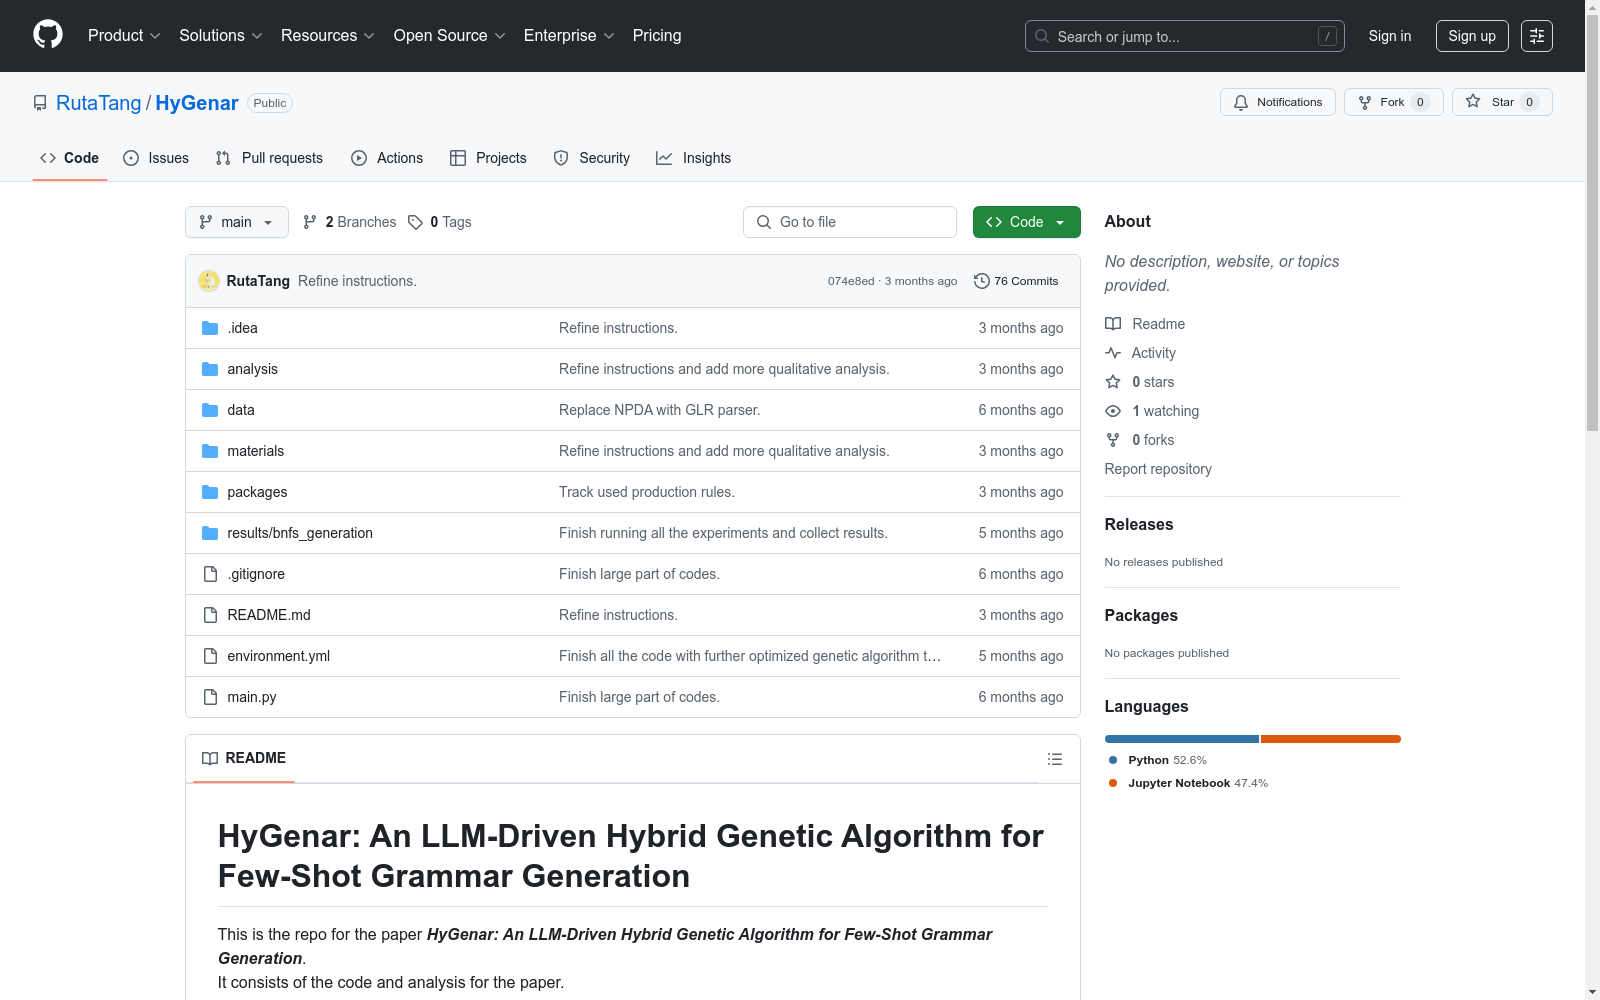
- 核心数据文件:
data/processed/bnf_with_examples.json - 分析文件夹:
analysis - 代码文件夹:
packages - 结果文件夹:
results
数据集特点
- 语法生成任务: 从少量正负示例中推断并生成Backus-Naur Form(BNF)语法
- 评估指标: 包含6个专门设计的评估指标
- 模型评估: 评估了8种不同的大型语言模型
相关算法
- 核心算法: LLM驱动的混合遗传算法(HyGenar)
- 算法效果: 在生成语法的句法和语义正确性方面实现了显著改进
运行要求
- 环境配置: 需通过
conda env create -f environment.yml创建环境 - API要求: 可选提供OpenAI API密钥
- 硬件需求: 使用GPU可显著加速运行(不同模型运行时间从40分钟到24小时不等)
- 1HyGenar: An LLM-Driven Hybrid Genetic Algorithm for Few-Shot Grammar Generation爱丁堡大学 · 2025年


