
adorkin/replay-mix-10B
收藏官方服务:
资源简介:
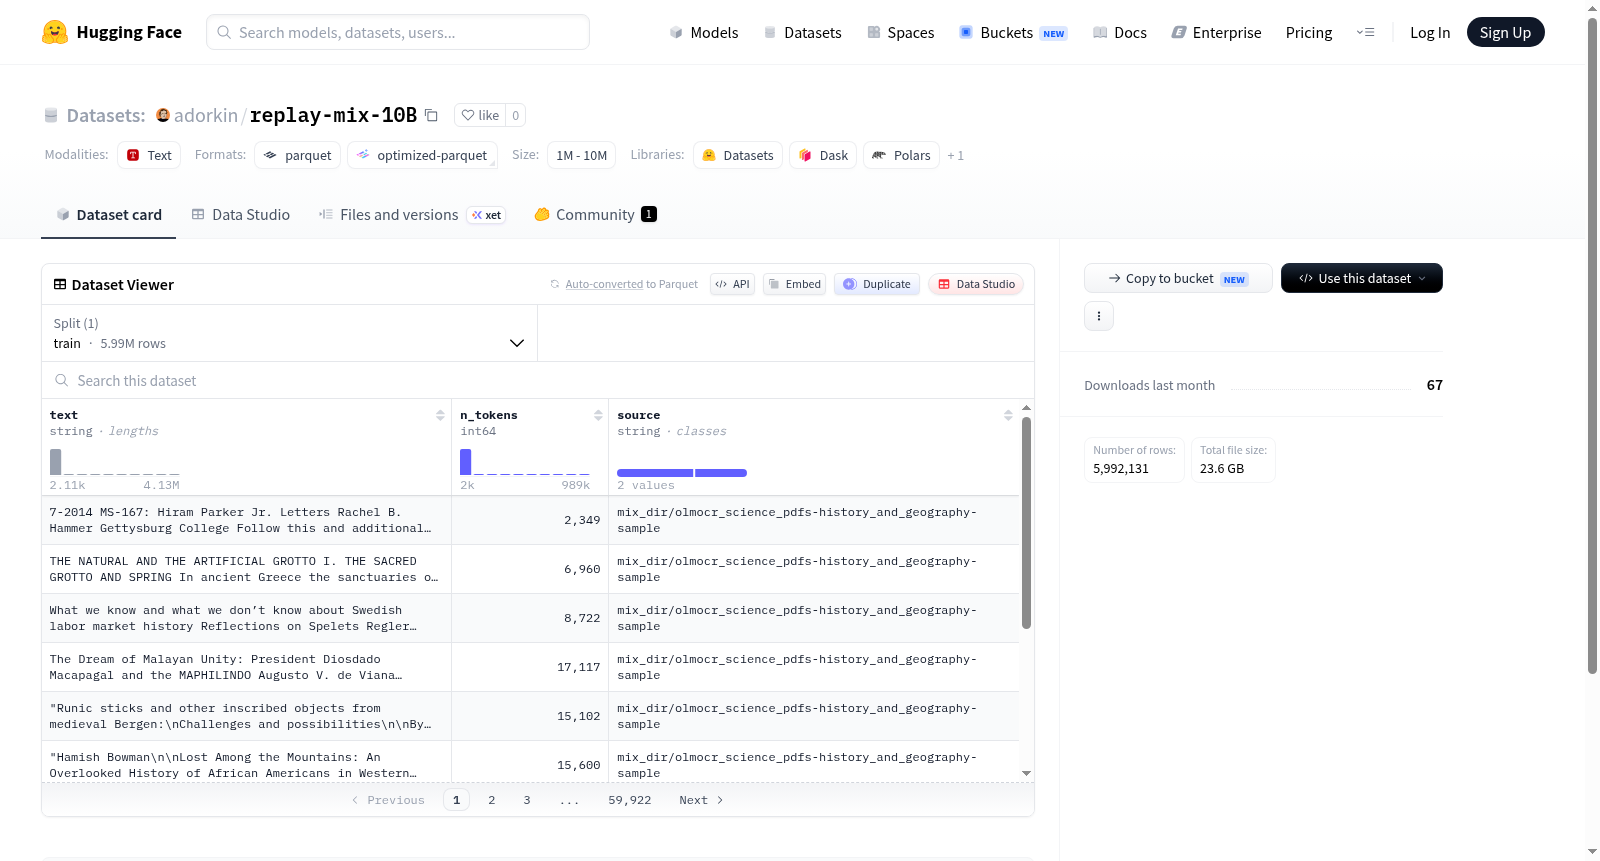
该数据集是一个文本数据集,包含5,992,131个训练示例,总大小为47,426,558,350字节,下载大小为23,616,622,876字节。每个示例具有三个特征:text(文本内容,以字符串形式存储)、n_tokens(表示文本中的令牌数量,以整数形式存储)和source(表示数据来源,以字符串形式存储)。数据集仅提供训练分割,数据文件路径为data/train-*。
This dataset is a text dataset containing 5,992,131 training examples, with a total size of 47,426,558,350 bytes and a download size of 23,616,622,876 bytes. Each example includes three features: text (the text content, stored as a string), n_tokens (the number of tokens in the text, stored as an integer), and source (the data source, stored as a string). The dataset only provides a training split, with data file paths specified as data/train-*.
提供机构:
adorkin搜集汇总
数据集介绍
构建方式
replay-mix-10B数据集通过整合多种数据源构建而成,旨在为语言模型训练提供高质量的混合文本。数据集的构建过程包括对原始文本进行清洗、去重和筛选,以确保内容的多样性与一致性。最终数据以parquet格式存储,并按照训练、验证和测试集进行划分,其中训练集包含约590万个样本,总文本量达47.4GB。每条记录包含文本内容、token数量及来源信息,便于后续分析和使用。
使用方法
使用replay-mix-10B数据集时,可通过HuggingFace Datasets库加载,指定配置名为'default',并选择'train'分割。每条数据包含'text'字段用于模型输入,'n_tokens'辅助批次管理,'source'字段便于溯源或过滤。建议在加载后根据需求进行进一步采样或切分,以适应具体训练任务。
背景与挑战
背景概述
在大型语言模型(LLM)训练中,数据质量与多样性的平衡始终是制约模型性能提升的核心瓶颈。replay-mix-10B 数据集由 Hugging Face 团队于 2023 年创建,旨在为语言模型的持续学习(continual learning)与回放机制(replay)提供高质量、多源异构的预训练语料。该数据集包含约 10B 个 token,整合了来自 Web 文本、书籍、代码等不同来源的混合数据,并按照回放策略进行重采样与结构化组织。通过引入多样化的源标签(source)与 token 计数(n_tokens),数据集为研究灾难性遗忘、领域适应与多任务学习提供了标准化评估基准。其设计理念直接影响后续基于回放的增量学习框架,成为连接数据工程与模型动态训练的关键桥梁。
当前挑战
该数据集面临的核心挑战来自两层面:其一,领域问题层面,需解决语言模型在连续学习新知识时如何有效避免旧能力遗忘,同时保持多源数据分布的长期一致性。不同来源(如代码与自然语言)的统计特性差异会导致模型训练时出现梯度冲突与表示偏移,亟需设计动态加权与重采样策略。其二,构建过程层面,海量 token 的清洗、去重与混合比例优化对计算资源与流水线架构提出极高要求,数据噪声(如重复段落、低质翻译)的过滤与回放缓冲区的容量-效率权衡始终未彻底解决。此外,源标签的粒度与语义对齐缺乏统一规范,限制了跨数据集迁移的可复现性。
常用场景
经典使用场景
Replay-Mix-10B数据集以其庞大的规模和涵盖多样化的文本来源,在自然语言处理领域中扮演着预训练语言模型的关键角色。该数据集汇集了来自互联网、书籍、新闻等多元渠道的文本,为模型提供了丰富的语言表征学习素材。研究者常将其用于预训练诸如GPT、BERT等大型语言模型的基础阶段,通过在海量文本上实施自监督学习,使模型掌握词汇、语法、语义乃至世界知识的通用表示,为后续的下游任务微调奠定坚实基础。
解决学术问题
在学术研究中,Replay-Mix-10B数据集有效缓解了语言模型训练中数据稀疏性与领域覆盖不全的问题。通过提供高达100亿词级别的多源文本,它帮助模型在常识推理、知识记忆与长程依赖建模方面取得显著进步,推动了语言模型泛化能力与鲁棒性的研究。这一数据集的发布促进了关于大规模数据预处理、去重策略及数据质量对模型性能影响的深入探讨,也为研究跨领域知识迁移与灾难性遗忘现象提供了标准化实验平台。
实际应用
在实际应用中,基于Replay-Mix-10B预训练的语言模型被广泛部署于智能客服、机器翻译、内容摘要生成以及代码辅助编程等场景。例如,科技公司利用其在海量文本上习得的语义理解能力,构建能够精准回复用户查询的聊天机器人;媒体机构则借助模型自动产出新闻报道摘要,极大提升内容生产效率。此外,教育领域利用这些模型辅助写作纠正与知识问答,而研究机构将其作为基准工具,进行文本分析与信息抽取,从而加速知识发现进程。
数据集最近研究
最新研究方向
面向大规模语言模型训练的数据复现与混合策略成为当前研究热点。replay-mix-10B数据集汇聚了约600万条高质量文本样本,涵盖多样化来源,总标记数达百亿级别,为模型在预训练与持续学习阶段提供丰富的回放数据。前沿方向聚焦于利用此类混合数据集缓解灾难性遗忘、提升模型鲁棒性与泛化能力,同时探索数据配比与去重技术对训练效率的影响。该数据集的发布为构建更强大、更稳定的基础模型奠定了关键数据基础,推动了语言模型在复杂任务上的性能跃升。
以上内容由遇见数据集搜集并总结生成


