遇见数据集

Lloviant/autotrain-data-ex-and-pt

收藏
Hugging Face2023-01-28 更新2024-03-04 收录
官方服务:

资源简介:

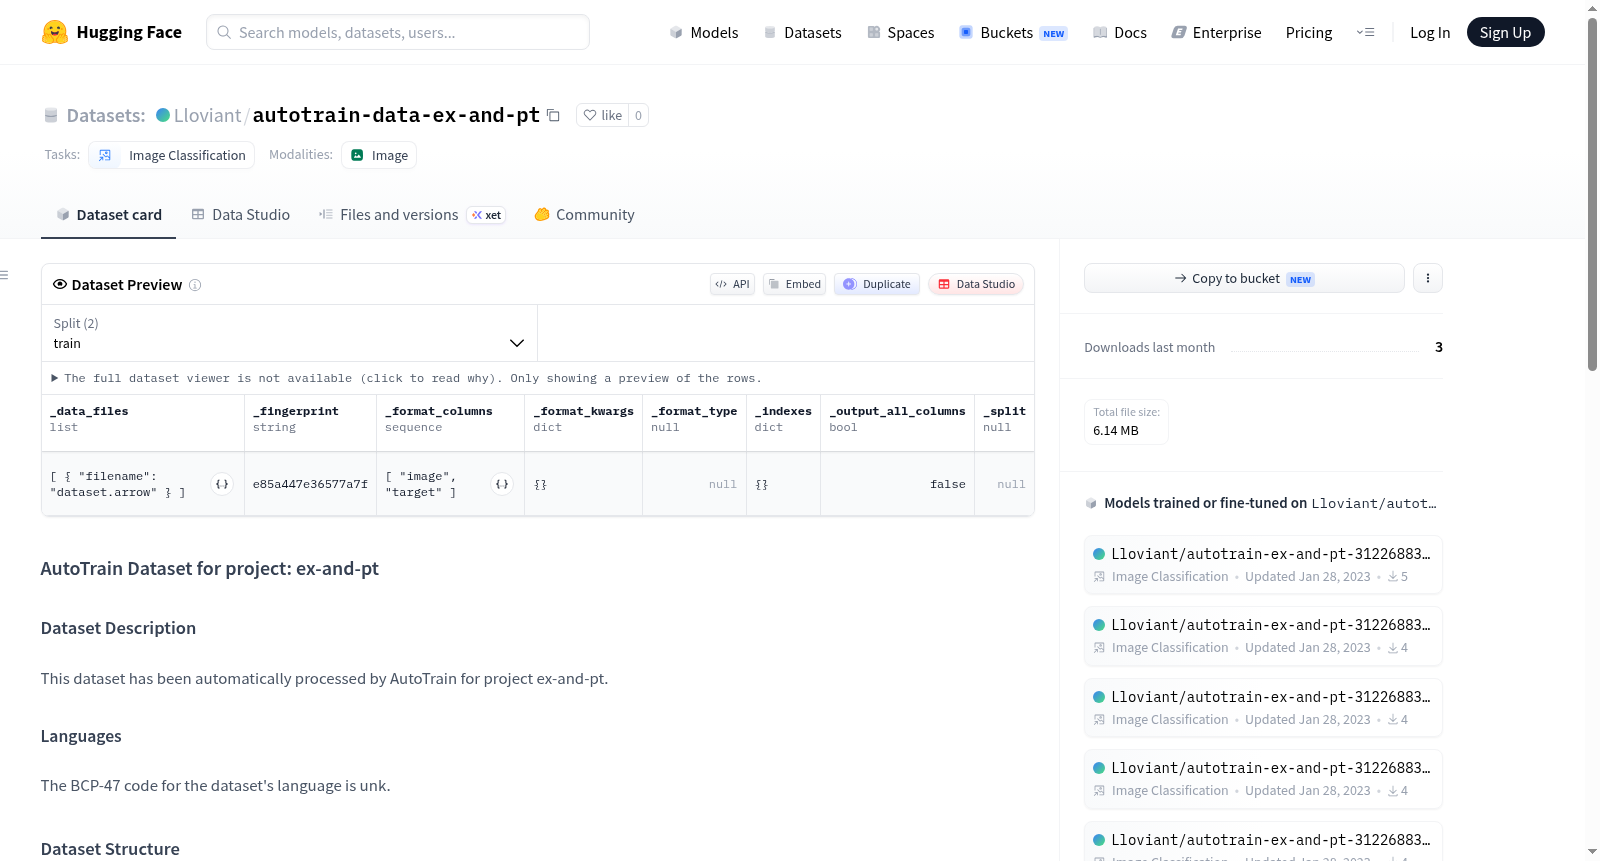
该数据集是用于图像分类任务的,由AutoTrain自动处理生成。数据集包含图像和对应的目标标签,图像格式为3840x2160的RGB或RGBA PIL图像,目标标签为分类标签,共有6个类别。数据集分为训练集和验证集,分别包含15和7个样本。

This dataset is designed for image classification tasks and was automatically generated and processed by AutoTrain. It comprises images and their corresponding target classification labels. The images are RGB or RGBA PIL images with a resolution of 3840×2160. There are 6 classification categories in total. The dataset is split into a training set and a validation set, which contain 15 and 7 samples respectively.

提供机构:
Lloviant
原始信息汇总

数据集概述

数据集描述

该数据集是为项目“ex-and-pt”通过AutoTrain自动处理生成的,主要用于图像分类任务。

语言

数据集的语言代码为unk。

数据集结构

数据实例

数据集中的样本示例如下:

json [ { "image": "<3840x2160 RGB PIL image>", "target": 2 }, { "image": "<3840x2160 RGBA PIL image>", "target": 5 } ]

数据集字段

数据集包含以下字段:

json { "image": "Image(decode=True, id=None)", "target": "ClassLabel(names=[EX and PT, EX and PT Logo, EX and PT Mutant, EX and PT Mutants, EX and PT TCG, Vagitron], id=None)" }

数据集分割

数据集被分割为训练集和验证集,分割详情如下:

分割名称 样本数量
训练集 15
验证集 7
搜集汇总
数据集介绍
Lloviant/autotrain-data-ex-and-pt 数据集图片
构建方式
该数据集名为Lloviant/autotrain-data-ex-and-pt,专为图像分类任务而设计,经由AutoTrain流水线自动处理生成。数据集的构建基于对原始图像数据的自动标注与整理,最终形成包含训练集与验证集的结构化样本集合。训练集包含15个样本,验证集包含7个样本,样本以JSON格式存储,每条记录包含一个解码后的PIL图像及其对应的类别标签。类别标签涵盖了六类目标:'EX and PT'、'EX and PT Logo'、'EX and PT Mutant'、'EX and PT Mutants'、'EX and PT TCG'以及'Vagitron',体现了数据集在特定视觉概念识别上的聚焦性。
使用方法
该数据集的使用方法主要围绕图像分类任务展开。用户可直接通过HuggingFace Datasets库加载数据,利用其提供的'image'字段进行模型输入,'target'字段作为监督信号。由于数据集已被AutoTrain预处理,用户无需额外清洗即可将其用于训练或微调图像分类模型,尤其适用于基于PyTorch或TensorFlow的深度学习框架。建议在加载后检查数据分布,并可根据需要扩展数据增强策略以应对样本量较小的挑战,从而提升模型泛化能力。
背景与挑战
背景概述
图像分类作为计算机视觉领域的基石任务,长期以来驱动着从自动驾驶到医学影像分析等众多应用的发展。在此背景下,Lloviant/autotrain-data-ex-and-pt数据集由AutoTrain平台于近期自动构建,旨在支持针对特定主题的图像分类研究。该数据集聚焦于‘EX and PT’及其变体(如Logo、Mutant、TCG)以及‘Vagitron’共六个类别,为细分领域的视觉识别提供了基础资源。尽管样本规模有限(训练集15张、验证集7张),但其针对性的类别设计反映了研究者对特定视觉概念进行精细化区分的需求,为相关领域的模型训练与评估提供了初步的数据支撑。
当前挑战
该数据集面临的核心挑战首先体现在领域问题的复杂性上:类别间视觉差异细微,例如‘EX and PT’与其Logo、Mutant变体之间的边界模糊,要求模型具备高分辨力的特征提取能力,而图像尺寸高达3840x2160像素,进一步加剧了计算与存储负担。其次,构建过程遭遇显著困难:数据集完全依赖AutoTrain自动化处理,缺乏人工标注校验,可能导致标签噪声或类别定义不一致;极端有限的样本量(仅22张)不仅难以覆盖真实场景中的多样性,还极易引发过拟合,且未明确提供数据来源与伦理审查信息,削弱了其可复现性与可靠性。
常用场景
经典使用场景
在图像分类领域,Lloviant/autotrain-data-ex-and-pt 数据集凭借其精心标注的六类视觉概念,成为探究特定品牌标识与衍生符号识别任务的经典基准。该数据集包含高分辨率图像样本,涵盖了从原始品牌标志到变异形态及关联产品的丰富视觉变体,为细粒度图像分类研究提供了极具挑战性的测试平台。研究者常利用该数据集验证模型在区分高度相似类别(如‘EX and PT’与‘EX and PT Mutant’)时的判别能力,从而推动视觉特征提取与分类算法在商标识别、品牌保护等垂直场景中的性能提升。
解决学术问题
该数据集有效回应了计算机视觉领域中关于小样本学习与类别不平衡问题的学术关切。由于训练集仅含15个样本,验证集仅有7个样本,它天然构成了一个极端小样本学习场景,促使学者探索数据增强、迁移学习及元学习等策略在有限标注条件下的泛化边界。同时,类别分布的非均衡性(如‘Vagitron’类与‘EX and PT’类样本数量悬殊)为研究鲁棒分类器面对长尾分布时的表现提供了实证材料,其成果对于提升模型在真实世界稀疏数据场景中的实用性具有重要理论价值。
实际应用
在实际应用中,该数据集所代表的图像分类任务可无缝迁移至品牌侵权监测与知识产权保护系统。企业可利用基于此数据集训练的模型,自动识别网络平台上未经授权的品牌标志使用、变异设计或仿冒产品,从而加速侵权证据的筛查流程。此外,该数据集所涵盖的‘EX and PT TCG’等类别,也使其在集换式卡牌游戏的卡片真伪鉴别与稀有度分类中具备直接应用潜力,为数字内容审核与实物资产数字化管理提供了可落地的技术方案。
数据集最近研究
最新研究方向
在图像分类领域,小样本学习与自动化数据标注正成为前沿热点。Lloviant/autotrain-data-ex-and-pt 数据集通过AutoTrain自动处理,仅包含22个样本(15训练、7验证),聚焦于“EX and PT”及其变体(如Logo、Mutant、TCG)与“Vagitron”的细粒度分类。这类极小规模数据集的研究意义在于,它呼应了工业界对快速模型迭代与低资源场景下的需求,尤其是在数据获取成本高昂或隐私敏感的领域。当前研究方向集中于利用预训练视觉模型(如CLIP、ViT)进行迁移学习,结合数据增强与对比学习策略,在极端小样本条件下提升分类精度。该数据集的发布为验证这类方法的鲁棒性提供了基准,同时也推动了自动化机器学习流程(如AutoTrain)在图像分类任务中的实用化进程,对推动边缘计算与个性化视觉识别系统的落地具有示范价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务