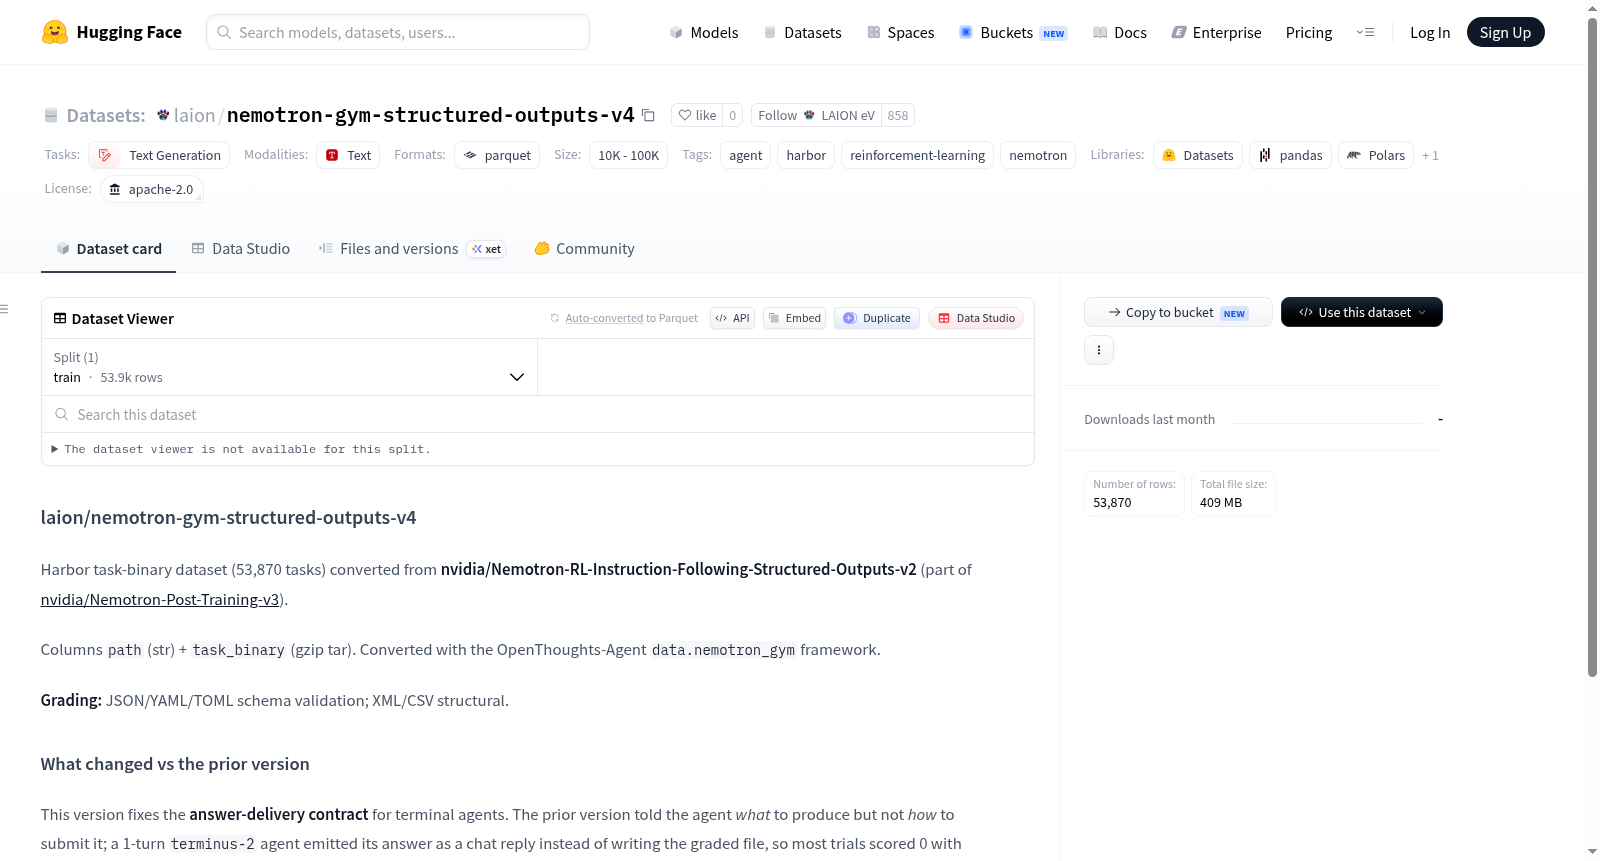
nemotron-gym-structured-outputs-v4
收藏资源简介:
该数据集为Harbor任务二进制数据集,包含53,870个任务,从nvidia/Nemotron-RL-Instruction-Following-Structured-Outputs-v2转换而来,属于nvidia/Nemotron-Post-Training-v3集合的一部分。数据集包含两列:path(字符串类型)和task_binary(gzip压缩tar文件格式),转换过程使用了OpenThoughts-Agent的data.nemotron_gym框架。数据集主要用于文本生成任务,涉及智能体、Harbor、强化学习和Nemotron等技术,其评分机制基于JSON/YAML/TOML模式验证以及XML/CSV结构验证。相较于前一版本,本版本修复了终端智能体的答案交付契约问题,明确指示智能体通过shell heredoc将答案写入评分器指定的文件路径并验证,从而确保答案正确提交,避免因文件缺失导致的评分失败。该数据集适用于训练或评估智能体在遵循结构化输出指令方面的能力,特别是在需要生成符合特定模式或结构的文本生成场景中。
This dataset is the Harbor task binary dataset, containing 53,870 tasks, converted from nvidia/Nemotron-RL-Instruction-Following-Structured-Outputs-v2 and is part of the nvidia/Nemotron-Post-Training-v3 collection. The dataset includes two columns: path (string type) and task_binary (gzip-compressed tar file format), with the conversion process using OpenThoughts-Agents data.nemotron_gym framework. It is primarily used for text generation tasks, involving technologies such as agents, Harbor, reinforcement learning, and Nemotron. The scoring mechanism is based on JSON/YAML/TOML schema validation and XML/CSV structure validation. Compared to the previous version, this version fixes the answer delivery contract issue for terminal agents, explicitly instructing agents to write answers to the file path specified by the scorer via shell heredoc and verify, ensuring correct answer submission and avoiding scoring failures due to missing files. The dataset is suitable for training or evaluating agents ability to follow structured output instructions, particularly in text generation scenarios that require generating text conforming to specific schemas or structures.
数据集概述:laion/nemotron-gym-structured-outputs-v4
- 来源与转换:该数据集基于 nvidia/Nemotron-RL-Instruction-Following-Structured-Outputs-v2 转换而来,属于 nvidia/Nemotron-Post-Training-v3 系列的一部分。
- 规模:包含 53,870 个任务(Harbor task-binary 格式)。
- 数据列:包含
path(字符串)和task_binary(gzip tar 格式)两列。 - 转换框架:使用 OpenThoughts-Agent 的
data.nemotron_gym框架完成转换。 - 评分标准:支持 JSON、YAML、TOML 模式的验证;以及 XML、CSV 的结构验证。
相较于先前版本的变更
- 修复了终端代理的“答案交付契约”问题:先前版本仅告知代理要生成什么,但未说明如何提交。导致 1 轮
terminus-2代理以聊天回复形式输出答案,而非写入需评分的文件,造成大多数尝试因“答案文件缺失”得 0 分。 - 改进后的指令:现已明确要求代理通过 shell heredoc 将答案写入评分器指定的文件路径,并执行验证。评分逻辑本身未作其他更改。
许可与标签
- 许可协议:Apache-2.0
- 任务类别:文本生成(text-generation)
- 标签:agent、harbor、reinforcement-learning、nemotron